※ 本記事は、Srinidhi Sathyamurthyによる”Stop Making AI Guess Your Database: Oracle SQLcl MCP Server, Agent Memory, and Oracle AI Database“を翻訳したものです。
2026年11月8日
Oracle SQLcl MCPサーバー、Codex、Cursor、Antigravity、Claude、Oracle AI Agent Memoryを使い、Oracle AI Databaseへのアクセスを適切に管理しながら開発を進めるためのガイドです。
関連記事とノートブック:
- Codexを使う場合:CodexとOracle AI Databaseで、アクセスを適切に管理したMCPワークフローを構築する方法、Codexの関連ノートブック
- Cursorを使う場合:Oracle AI Databaseで、アクセスを適切に管理したCursorのMCPワークフローを構築する、Cursorの関連ノートブック
- Antigravityを使う場合:Oracle SQLcl MCP ServerとOracle AI DatabaseでAntigravityのワークフローを構築する方法、Antigravityの関連ノートブック
- Claudeを使う場合:Claudeのメモリ、Oracle AI Agent Memory、LangChainを組み合わせるべき場面、Claudeの関連ノートブック
主なポイント
- Oracle SQLcl MCPサーバーを使えば、AIクライアントからツールを介してOracle AI Databaseにアクセスする方法を明確に定められます。アシスタントは、プロンプトに貼り付けられたスキーマ情報だけに頼ることなく、アクセスを許可されたデータベースの情報を調べられます。
- Codex、Cursor、Antigravity、Claudeでは、開発時の使い勝手は異なります。それでも、承認済みのSQLcl接続を使うこと、データベース権限を適用すること、ツールの呼び出し内容を確認できるようにすること、アクセス範囲を広げる前に検証することは、共通のルールとして維持できます。
- Oracle AI Agent Memoryは、ツールへのアクセスとは別に、アプリケーション層に追加するものです。スレッドを長期保存する、対象範囲を絞って検索する、情報を再利用する、セッションをまたいで作業を継続するといった必要が生じたときに導入します。MCPを使っているという理由だけで、メモリまで追加する必要はありません。
- 関連ノートブックは、環境を構築し、動作を検証するために使います。設定、データの保存と検索、メモリの利用方法を確認できます。ただし、実際のクライアントでの動作検証や、本番環境で収集する稼働データの代わりにはなりません。
- まず小さな構成で始め、データベースへの接続と操作を検証します。一連の処理がどのように動くかを説明できるようになってから、アクセス範囲を広げます。
AIアシスタントにSQLを書いてもらうことはできます。しかし、そのアシスタントは、実際に使うデータベースのことを把握しているでしょうか。
たとえば、開発者がテーブル定義をプロンプトに貼り付けてクエリの作成を依頼すると、アシスタントは一見正しそうなSQLを返します。ところが、実行すると失敗します。列名が先週変更されていた、対象のオブジェクトが別のスキーマにあった、接続中のデータベースユーザーにはそのオブジェクトを見る権限がなかった、といった理由です。あるいは、アプリケーション固有のルールを、プロンプトで伝えていなかったのかもしれません。
アシスタントがSQLを生成できないことが原因ではありません。開発者が渡した情報を前提に推論しているため、その前提に不足や誤りがあれば、実際の環境に合わない回答になるのです。情報が不完全だったり、古かったり、単純化されすぎていたりすれば、もっともらしい回答でも、そのまま使えるとは限りません。
このガイドのタイトルでいう「推測させる」とは、このように、実際の環境を確認できないまま回答させることです。アシスタントに推論させること自体をやめようとしているわけではありません。ツール、データベースの権限設定、実行時の検証で管理すべきことまで、プロンプトの文章だけで対処しようとするのをやめる、という意味です。
Oracle Database MCPシリーズでは、複数の開発環境に共通する構成を取り上げてきました。開発者は、Codex、Cursor、Antigravity、Claudeのいずれからでも、一連の処理を始められます。データベースに関する情報をプロンプトに書き写して接続方法を伝える代わりに、Oracle SQLcl MCPサーバーと承認済みのSQLcl接続プロファイルを使い、ツール経由でOracle AI Databaseにアクセスします。現在のやり取りが終わった後も有用な情報を残しておく必要があれば、Oracle AI Agent Memoryの利用を検討します。さらに、検索処理を取りまとめるアプリケーション層が必要であれば、LangChainを使うこともできます。
最終回となる本記事では、これらの構成要素の関係を整理します。シリーズ全体を読むための案内として、各層で何を担当するか、クライアントを変えると何が変わるか、何を共通に保つべきかを説明します。また、単純なMCPの構成に、いつメモリや検索の仕組みを加えるべきかを判断できるようにします。
本記事は、Oracle Database MCPシリーズを締めくくるガイドです。これまでの記事では、Codex、Cursor、Antigravity、ClaudeとOracle AI Agent Memoryを使い、具体的な構築手順を紹介してきました。まずは本記事で全体像をつかみ、実際に試す環境を決めたら、個別の記事とノートブックのリンクをたどってください。
プロンプトの説明に頼らず、データベースを直接調べられると何が変わるか
アシスタントにデータベースの説明を渡す場合と、ツールを使って、アクセスを許可されたデータベースの情報を調べさせる場合とでは、実際の開発でできることが異なります。説明を渡すだけなら、モデルが参照できるのは、開発者がプロンプトに貼り付けた情報に限られます。一方、ツールを使えるようにすれば、モデルは実行時に、あらかじめ定義されたツールに情報を要求できます。その際のアクセスは、開発者が設定した権限と接続先の範囲に限定されます。
この違いは、日常の開発でも重要です。開発を進めるうちにスキーマを変更することがありますし、環境ごとに付与されている権限も異なります。似た名前のオブジェクトを取り違えることもあれば、ビューを見ただけでは実装の詳細が分からないこともあります。データ品質の問題に、クエリを実行して初めて気付く場合もあります。こうした点を推測で済ませず、処理の中で確認できるようにすれば、実際のデータベース業務でアシスタントを使いやすくなります。問題が起きたときにも、原因を調べやすくなります。
このような場面で、AIエージェントに渡す情報を設計する「コンテキストエンジニアリング」が実務に役立ちます。データベースの詳細を、ひたすらプロンプトに追加すればよいわけではありません。開発者は、実行時にデータベースを調べて取得する情報、保存済みのメモリを検索して取得する情報、そもそもモデルへのリクエストに含めない情報を決める必要があります。
MCPを使ったからといって、モデルの判断が正式なものとして保証されるわけでも、データベースのセキュリティが不要になるわけでもありません。AIクライアントからツールを呼び出すための標準的な方法が、MCPです。Oracle SQLcl MCPサーバーを使うと、その仕組みを介してOracle AI Databaseのツールを呼び出せます。接続するデータベースユーザーに何を許可するかは、引き続きデータベース側で制御します。どの処理を自動化し、どの処理をレビューし、どの処理を禁止するかは、開発者が決めます。
MCPが行うこと、行わないこと
MCPを使うと、AIクライアントから、利用可能なツールを確認して呼び出せます。Oracle SQLcl MCPサーバーでは、この標準的な仕組みをOracle Databaseを使う処理に適用します。
MCPを導入しても、データベースの権限設定は引き続き必要です。また、MCPだけで長期保存できるメモリが自動的に用意されるわけでも、アプリケーションに許可する操作が決まるわけでもありません。設定したデータベースユーザーが何にアクセスでき、何を実行できるかは、Oracle AI Databaseで制御します。
一方、現在のやり取りが終わった後も有用な情報を残しておきたい場合には、Agent Memoryが役立ちます。ツールへのアクセス、データベースのセキュリティ、長期保存するメモリを、それぞれ別の役割として設計すれば、テストも運用も進めやすくなります。
共通の構成を、さまざまな開発環境で使う
このシリーズを読む際は、開発者が操作する環境と、各環境に共通する基盤を分けて考えると理解しやすくなります。
Codex、Cursor、Antigravity、Claudeでは、日々の開発作業への取り入れ方が異なります。
それでも、クライアントを変えるたびに、基盤となる構成を一から設計し直す必要はありません。
| 層 | 主な役割 | 開発者が確認すること |
|---|---|---|
| AIクライアント | 開発者の意図を読み取り、計画を立て、ツールの実行を要求する。 | クライアントが出したツールへの要求と、その結果を確認できるか。利用可能と認識されたツールと、SQLcl MCPの設定やデータベース権限によって実行を許可された操作を、分けて文書化しているか。 |
| SQLcl MCP | あらかじめ定義したOracleのツールをMCP経由で公開し、承認済みのSQLcl接続プロファイルを使って接続する。 | サーバーが正常に起動するか。想定した保存済み接続を使っているか。サーバー設定で許可されるSQLclコマンドは何か。データベース権限で制御される操作は何か。 |
| Oracle AI Database | SQLを実行し、権限に従って操作を制御し、アプリケーションのデータを保存する。ベクトル検索、メモリレコード、処理の追跡記録、検索した根拠資料の管理にも利用できる。 | どのデータベースユーザーで操作したか。どのオブジェクトにアクセスできたか。結果と操作履歴を確認できるか。 |
| Oracle AI Agent Memory | ユーザー、エージェント、スレッド、長期保存するメモリ、対象範囲を限定した検索、モデルに渡す情報の構成を扱うアプリケーションAPIを提供する。 | 適切なユーザーや作業に対象範囲を限定しているか。アプリケーションの方針に従って、レコードを取得、訂正、失効、削除できるか。 |
| LangChain | Oracleを使ったメモリの仕組みを基に、アプリケーション側で一連の処理を取りまとめ、再利用できる検索パターンを用意する。 | 導入によってアプリケーションを簡素化できるか。それとも、基盤のデータベースへの接続や検索処理を確認する前に、層を1つ増やしているだけか。 |
利用可能なツールを確認することと、そのツールで実行できる操作を制御することは、関連していても別の問題です。クライアントからツールが見つかったとしても、実際にどの操作を実行できるかは、SQLcl MCPの設定とOracle Databaseの権限に従います。
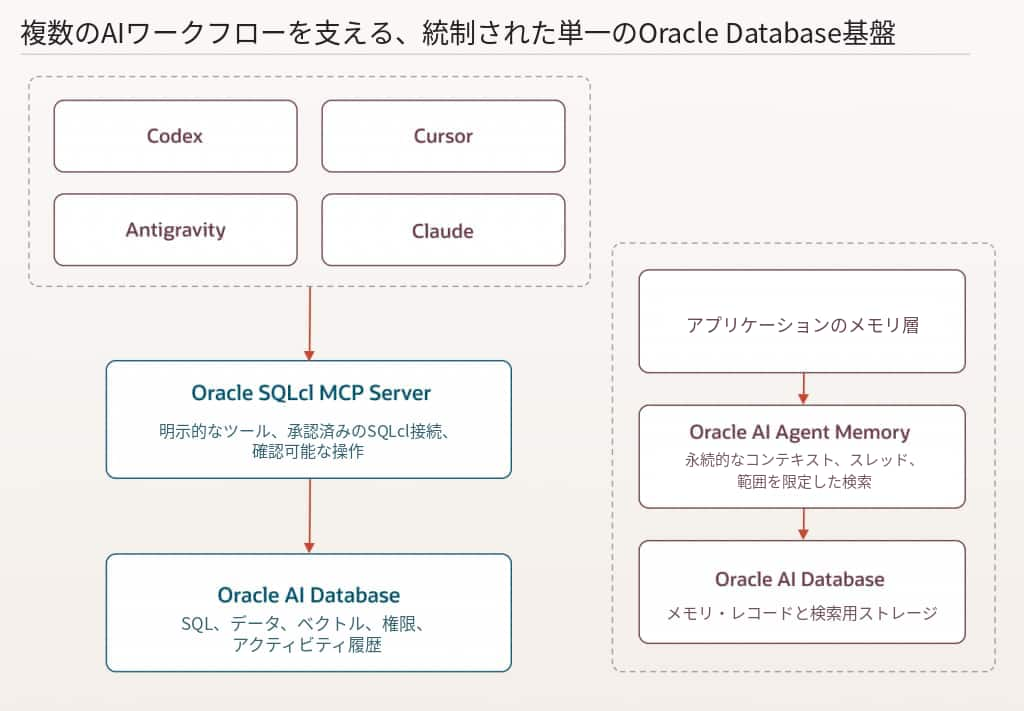
図1. 複数のAIワークフローで共通利用できる、アクセスを管理したOracle AI Databaseの基盤
基本となる考え方: アシスタントにどのツールを使って、どのように操作させるかは、SQLcl MCPで管理します。アプリケーションでどの情報を長期的に記憶しておくかは、Oracle AI Agent Memoryで管理します。どちらもOracle AI Databaseを利用できますが、構成上、担当する役割は異なります。
Oracle SQLcl MCP Serverで、実行できる操作を区切る
ここで紹介する構成では、MCP対応のクライアントから、Oracle SQLcl MCPサーバーを介してOracle AI Databaseにアクセスします。SQLclをMCPモードで起動すると、あらかじめ定義したツール群を公開できます。クライアントに接続させるために、プロンプトへデータベースの認証情報を書き込む必要はありません。クライアントはMCPサーバーを呼び出し、サーバーは、開発者が事前に作成して検証したSQLcl接続プロファイルを使って接続します。
小さな実装上の違いに見えるかもしれませんが、この構成を採ると、処理の安全性をどのように確かめるかが変わります。「安全に振る舞ってください」とプロンプトに書いたからアシスタントを信頼する、という判断に頼る必要がなくなります。代わりに、接続に使うユーザー、その権限、接続先を明確にし、実際の操作を確認できるようにします。そのため、クエリの実行が拒否されても、権限制御としては正しく動作している場合があります。公開されていないツールを、アシスタントが使いたいと考えただけで利用できるようになることもありません。
開発者は、この構成によって、漠然と安全性を議論する代わりに、具体的な点を確認できます。使っている保存済み接続はどれか。その接続は、どのデータベースユーザーのものか。そのユーザーは、何を読み取り、何を変更できるか。どのSQLcl MCPの機能を利用できるか。後から、どのような操作履歴を調べられるか。こうした点は、「安全なことだけをしてください」という一般的な指示よりも、はるかにテストしやすくなります。
これまでの記事では、クライアントごとの具体的な設定手順を説明しました。最終回となる本記事で押さえておきたいのは、アクセスや操作を制御する仕組みを、クライアントに依存しない下位の層で実装することです。開発に使うインターフェースを切り替えても、データベースの権限設計を一からやり直さずに済むようにします。
共通の基盤を4つの開発環境で使う
このシリーズで複数のクライアントを扱っているのは、開発者によって普段の作業環境が異なるためです。ターミナルでエージェントを使いたい人もいれば、エディタ内で作業を完結させたい人もいます。新しいエージェント型の開発環境を評価している人も、汎用アシスタントとアプリケーションのメモリを組み合わせて試している人もいるでしょう。クライアントによって使い勝手は変わりますが、基盤の各層で何を担当するかという設計まで変える必要はありません。
Codex:ファイル操作やコマンド実行と一緒に、データベースも扱いたい場合
すでにエージェントを使って、ファイル、コマンド、設定、ノートブック、実装の詳細を扱っているなら、Codexを使う構成が適しています。開発作業全体で使うツールの1つとして、データベースへのアクセスを組み込めます。エージェントは、データベースを調べて分かったことを、そのままコードの変更に結び付けられます。その一方で、実装作業と密接に結び付くからこそ、データベースに対して何を許可するかを明確にしておく必要があります。
Codexの関連ノートブックでは、前提条件、SQLclでの接続、メモリの保存、検索、Agent Memoryとの連携を検証できます。これらを分けて確認することで、問題が起きたときに、MCPによるツールの検出、データベース接続、権限、メモリ、検索のどこに原因があるかを特定しやすくなります。
Cursor:コード編集を続けながら、データベースの情報も確認したい場合
Cursorを使えば、コードを編集する作業の中で、データベースも扱えます。アプリケーションのコードを変更しながら、別の作業に移ることなくスキーマを調べたり、前提が正しいかを確認したりしたい場合に、特に役立ちます。
ただし、ほかのクライアントと同じ注意が必要です。便利だからといって、明確に許可していない広範なアクセスまで認めるべきではありません。
Cursorのノートブックでは、掲載する操作記録が、教材用に作った模擬データであり、実際にCursorから収集した稼働データではないことも明示しています。データベースを基盤にする構成を示すためのサンプルであり、実際にクライアントが操作した証拠として提示しているわけではありません。
Antigravity:別のエージェント型開発環境でも、同じ構成を試したい場合
Antigravityの記事を読むと、この構成を別の環境にも適用できることが分かります。開発者が操作するインターフェースは変わっても、役割を分ける考え方は同じです。開発者が使うエージェント、ツールを介した操作を管理するSQLcl MCP、Oracle AI Databaseを分け、必要に応じてOracle AI Agent Memoryや検索処理を取りまとめる仕組みを追加します。
Antigravityのノートブックも、同じ原則に従っています。ノートブックでは、メモリの保存基盤、検索、Agent Memoryを介した処理を検証できます。ただし、MCPが実際にどう動作するかは、実際のクライアントからSQLcl MCPを使い、一連の処理を確認する必要があります。
Claude:アシスタントが対話中に使う情報と、アプリケーションが保存するメモリの役割を整理したい場合
Claudeの記事では、このシリーズの内容に、もう1つの問いを加えています。アシスタントがデータベースのツールを使えるようになった後、有用な情報を現在のやり取りが終わっても残しておくには、どうすればよいでしょうか。そのために、MCPにメモリの管理まで担わせる必要はありません。ツールへのアクセスと、アプリケーションが情報を長期保存する仕組みは、同じOracleの基盤を使っていても、別々に設計すべきものです。
この役割分担は、シリーズ全体でも特に重要な考え方です。アシスタントが作業に必要な情報を対話中に使えていても、アプリケーション側で別途メモリを管理する必要が生じる場合があります。逆に、アシスタントへ無制限のデータベースアクセスを与えなくても、アプリケーションで情報を長期保存することはできます。それぞれの役割を分ければ、開発者は、何をテストし、誰が管理するかを明確にでき、暗黙の前提も減らせます。
後に残す価値のある情報ができてから、Agent Memoryを追加する
エージェントのデモが動き始めると、すぐにメモリを追加したくなるかもしれません。しかし、実際には、その段階ではまだ早すぎることがよくあります。メモリが役立つのは、作業や対話をまたいで情報を引き継ぐ、具体的な必要が生じたときです。たとえば、後日戻ってきたユーザーが以前伝えた好みを覚えていてほしい場合や、開発者が前回のツール実行結果を新しいセッションで使いたい場合です。また、エージェントが会話全体を再び読み込むことなく、過去の作業から必要な情報だけを取得したい場合にも役立ちます。
このシリーズでいうAIエージェントメモリは、Oracle AI Agent Memoryを指します。Oracle AI Databaseを使って情報を長期保存し、それを扱うためのAPIを提供するものです。Oracle AI Databaseの上のアプリケーション層に位置し、Pythonアプリケーションから、スレッド、長期保存するメモリレコード、対象範囲を限定した検索、モデルに渡す情報の構成を扱えます。データの保存とアクセス制御の適用は、下位のOracle AI Databaseで行います。そのため、開発者はメモリについても、すでに馴染みのある設計項目に沿って検討できます。具体的には、ユーザーの識別、保持期間、アクセス制御、動作や履歴を確認する方法、データ品質、ライフサイクルです。
Pythonアプリケーションでは、oracleagentmemoryパッケージのAPIを使って、ユーザー、エージェント、スレッド、メモリレコード、検索フローを作成します。
何を追加するか迷ったら、まず、どの問題を解決したいのかを確認すると判断しやすくなります。「クライアントから現在のスキーマを調べられない」のであれば、MCPツール経由でアクセスする仕組みを追加するか、修正します。「セッションが変わると有用な情報が失われる」のであれば、Agent Memoryの導入を検討します。「そのメモリを使い、再利用できる検索パイプラインを構築したい」のであれば、LangChainなど、処理を取りまとめる層が役立つかもしれません。どの機能も、具体的な必要に応じて追加するべきです。
2種類の処理ループに分けて考える
構成を理解するには、その場の対話を進めるループと、情報を保存して後で再利用するループを分けると分かりやすくなります。どちらもOracle AI Databaseを利用できますが、それぞれ異なる目的で動かします。
その場の対話を進めるループでは、開発者が質問したり、作業を依頼したりしたことに、すぐに対応します。クライアントがデータベースのツールを必要と判断すると、SQLcl MCPを介し、承認済みの接続先と方法で操作を実行します。Oracle AI Databaseから結果が返ると、クライアントはそれを使って作業を続けます。
一方、情報を保存して後で再利用するループでは、アプリケーションのコードで、保存対象に選んだ会話履歴、ツールの結果、メモリレコード、メタデータ、埋め込みを格納します。後から、現在のユーザーや作業に役立つ情報だけを検索し、次にモデルを呼び出す前に、渡す内容をまとめます。目的は、保存したすべての情報を再び読み込むことではありません。有用な情報を検索できるようにし、利用する対象範囲を限定することです。
後で情報を有効に再利用するには、エージェントが検索する対象範囲を限定することが重要です。保存したすべての情報を同じように利用するのではなく、適切なユーザー、エージェント、スレッド、作業に対応するレコードを取得します。こうして範囲を絞れば、関連性の高いメモリを使いやすくなり、古い情報や無関係な情報を次のモデルへのリクエストに混ぜることを防げます。
| ループ | 行う処理 | 確認すること |
|---|---|---|
| その場の対話を進めるループ | クライアントからSQLcl MCPのツールを呼び出し、データベースの現在の情報を取得する。 | 利用可能なツールを検出できるか。どの保存済み接続とデータベースユーザーを使うか。権限は適切か。結果と操作履歴を確認できるか。 |
| 情報を保存して後で再利用するループ | 後で使うために、メモリレコード、処理の追跡記録、メタデータ、ベクトルをアプリケーションで保存し、検索する。 | ユーザーとスレッドの対象範囲は適切か。検索品質は十分か。保持、訂正、削除をどう行うか。取得した情報が次の作業に適しているか。 |
ノートブックは検証に使い、実際の操作はクライアントで行う
このシリーズの実践記事には、いずれも関連ノートブックを用意しています。複数の構成要素がどう動くかを、目に見える形で確かめやすいためです。ノートブックでは、ローカル環境の前提条件を確認し、機密情報を除いた設定を表示し、教材用のテーブルを作成してサンプルレコードを挿入できます。さらに、語句検索とベクトル検索を試し、Agent Memoryを初期化し、最後に検証結果をまとめて確認できます。
ただし、ノートブックの役割を正しく捉える必要があります。開発者が最終的に操作するのは、Codex、Cursor、Antigravity、Claudeです。ノートブックは、クライアントを使う前、または使いながら、その周辺のデータベースやメモリの仕組みを検証するために使います。ノートブックを実行すれば、実際のクライアントの稼働データまで自動的に得られる、というわけではありません。教材用の模擬データを、クライアントで実際に操作が行われた証拠として示すべきではありません。
クライアントを変えても、データベースへのアクセスルールを統一する
利用するクライアントは変更して構いません。ただし、データベースへのアクセスルールは、共通に保つべきです。
Codex、Cursor、Antigravity、Claudeでは、開発者がAIアシスタントと作業する方法が異なります。それでも、クライアントを切り替えるたびに、データベースへのアクセスを設計し直す必要があってはなりません。どのクライアントでも、基盤で使うSQLcl接続、データベースユーザー、権限、検証手順を明確にし、想定どおりに動く状態を維持します。
まず、用途に応じたデータベースユーザーを用意し、その作業に必要な権限だけを付与するとよいでしょう。開発時には通常、読み取り中心の限られた操作から始め、明確な理由ができたときにだけアクセス範囲を広げます。
保存済みのSQLcl接続も、アプリケーションの構成要素として管理します。開発者は、どの接続別名を使い、その接続がどのデータベースユーザーに対応し、そのユーザーがどの環境にアクセスできるのかを把握しておくべきです。予期しない動作が起きたときは、プロンプトを書き換えるより、これらを確認するほうが役立つことがよくあります。
MCPツールにも同じ原則を適用し、実際の作業に必要な機能だけを公開します。誰も十分にレビューしていない大量のツールを公開するより、必要なものに絞ったほうが、内容を理解しやすく、テストや問題の調査も進めやすくなります。
データベースで行われた操作も、後から確認できるようにしておく必要があります。クライアントがツールを呼び出したとき、チームで、何を要求し、どのデータベースユーザーで実行し、どのような結果になったかを確認できるようにします。書き込みや、そのほかの影響が大きい操作には、通常の調査や読み取りクエリよりも厳格な制御を適用すべきです。
Agent Memoryを導入するときは、保存する情報の役割についても線引きが必要です。有用な情報を後に残すためにメモリを使えますが、正式な情報源として管理しているシステムがすでにある場合、その情報について別の正本をメモリ内に作るべきではありません。また、メモリの量が増えるにつれて、適切な情報を検索できることも、アプリケーションとして満たすべき要件になります。検索処理そのものが技術的に成功していても、無関係な情報を確かなものとして返してしまえば、アプリケーションとしては失敗です。
目指すのは、開発者が自分に合うクライアントを選べるようにしつつ、データベースへのアクセス方法を分かりやすく、適切に管理された、一貫性のあるものに保つことです。
開発者が段階的に導入するための手順
一度に多くの機能を有効にすると、問題が起きたときに原因を調べにくくなります。各段階で、何を確認すれば動作を受け入れられるかを明確にし、確認が済んでから次の機能を追加するとよいでしょう。
- 実行環境を確認する:ローカルでSQLclをMCPモードで起動し、使用するクライアントからSQLclのツールを検出できることを確認します。
- 接続を確認する:承認済みの保存済みSQLcl接続を1つ使い、想定したスキーマに対して、取得範囲を限定した読み取りクエリを実行します。
- 権限による制限を確認する:許可したクエリが成功し、許可していない操作は、データベースのロールや設定した制限によって失敗することを確認します。
- 動作を追跡できることを確認する:データベース側で利用できる操作履歴を調べ、処理が失敗した際にチームで何を確認するかを文書化します。
- ここまで確認してから、長期保存するメモリを追加する:有用なレコードを少量保存し、別のセッションで取得して、ユーザーなどの識別情報と対象範囲が正しいことを検証します。
- 完全一致の絞り込みだけでは足りなくなったら、意味に基づく検索を追加する:成功する1つの例だけで判断せず、開発者が実際に尋ねそうな代表的な質問を使い、検索品質を評価します。
- 利用可能なツールや書き込み権限の拡大は、最後に行う:新しい機能を追加するときは、単にプロンプトを調整するのではなく、実際に操作できる範囲を変更するものとして扱います。
どのワークフローから始めるか
このシリーズで紹介するクライアントに、誰にとっても「最良」のものがあるわけではありません。普段どのように開発を進めているか、次に何を検証したいかを基準に選ぶとよいでしょう。次の表から、目的に合う詳細記事とノートブックに進めます。
| やりたいこと | 最初に試すもの | この構成で重視すること | 次に行うこと |
|---|---|---|---|
| ターミナル中心のコーディングエージェントで作業する | Codex | ファイル操作、コマンド実行、検証と密接に連携しながら、エージェントと実装を進める。 | Codex MCPの記事を読み、Codexの関連ノートブックを実行する。 |
| エディタでの作業中に、データベースの情報も使う | Cursor | Oracle Databaseのツールにアクセスする方法を明確にし、エディタ内でコードを開発する。 | Cursor MCPの記事を読み、Cursorの関連ノートブックを実行する。 |
| 別のエージェント型開発環境で、同じOracleの構成を試す | Antigravity | 別の環境でも構成を利用できることと、何をどこで検証するかを明確にする。 | Antigravity SQLcl MCPの記事を読み、Antigravityの関連ノートブックを実行する。 |
| アシスタントを接続した後、アプリケーションで情報を長期保存する | ClaudeとAgent Memory | アシスタントが対話中に使う情報、MCPによるツールアクセス、長期保存するメモリ、検索処理の取りまとめを区別する。 | Claude、Oracle AI Agent Memory、LangChainの記事を読み、メモリの関連ノートブックを実行する。 |
| クライアントを選ぶ前に、全体の構成を理解する | 本ガイド | シリーズ共通の基盤、段階的な導入手順、選択時の判断点を理解する。 | 本ガイドを基にクライアントを1つ選び、メモリを追加する前に、共通のOracle SQLcl MCPサーバーを介した接続と操作を検証する。 |
シリーズを読み進める際の推奨手順
この記事で初めてシリーズを知った場合は、すべてのクライアントの構成を再現しようとする必要はありません。自分の作業に合う環境を選び、共通のSQLcl MCPを介した接続と操作を一度検証してください。そのうえで、用途に必要になったときにだけ、追加の仕組みを導入します。
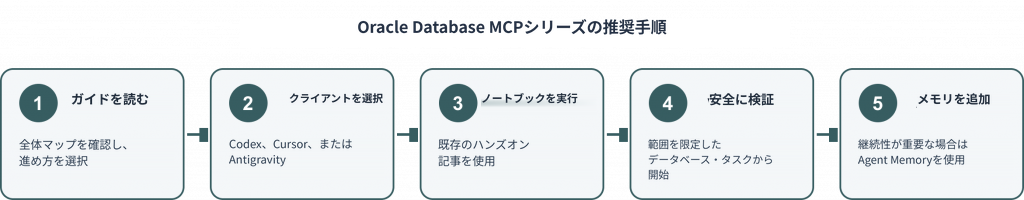
図2. Oracle MCPシリーズを段階的に進めるための簡単な手順
この順序で進めると、各段階で確認するたびに、次に調べるべき問題を絞り込めます。たとえば、SQLcl MCPが起動できない段階では、メモリを調べても、その問題は解決しません。接続先が間違っていれば、検索処理より先に接続を直す必要があります。データベースユーザーに権限を与えすぎている場合も、プロンプトを改善するだけでは、権限設計を修正できません。このように、基盤となる下位の層から検証しておけば、残った問題の原因を調べやすくなります。
デモから本番へ移るときにも維持したいこと
このシリーズでは開発者向けの例を扱っていますが、構成を設計する際の考え方は、より幅広い場面に当てはまります。本番で使えるようにするには、順調に動いていないときにも、何が起きているかをチームで説明できる必要があります。クライアントは何を要求したか、どのツールが動いたか、どのデータベースユーザーで実行したか、どのような結果が返ったか。どのメモリを取得したか、慎重に扱うべき操作をなぜ許可または拒否したか。こうした基本的な問いに、すぐ答えられるようにしておくべきです。
そのためには、環境ごとの区分を明確にし、公開するツールをレビューし、書き込み権限は明確な判断に基づいて付与する必要があります。処理に失敗する場合の動作も確認します。クエリが拒否されたことから、最小権限の原則に沿った制御が正しく機能していると分かる場合もあります。情報を作り上げて返すよりも、検索結果が空のまま返るほうが安全な場合もあります。クライアントから未承認のツールが見えないのも、まさに意図したとおりの動作かもしれません。
メモリについては、何を記憶し、どのくらいの期間保持し、どのユーザーなどの識別情報に結び付けるかを、別途決める必要があります。古くなったメモリを訂正したり、削除したりできるかも確認します。また、メモリに複製せず、正式な情報源であるシステムで管理し続けるべき情報は何かを判断します。
できるだけ、複雑さを増やさず、扱い慣れた構成に保ってください。通常は、問題がどう起こるかをチームで理解する前にフレームワークを追加するよりも、接続を適切に管理し、公開ツールを絞り、分かりやすいログを残し、メモリの対象範囲を限定し、十分に検証するほうが役立ちます。
AIがデータベースを適切な方法で調べられるようにする
AIコーディングアシスタントを使うと、渡した情報を基に、優れた推論結果を得られます。ただし、データベースを扱う作業でよい結果を得るには、その情報をどのように取得してアシスタントへ渡すかが重要です。小規模な例を試すだけなら、スキーマの一部をプロンプトに貼り付ける方法でも役立ちます。しかし、利用規模が大きくなれば、それだけでは対応しきれません。実際の環境で、権限に従って最新の情報を取得し、アクセス内容を後から確認できる仕組みが必要です。
開発者は、Oracle SQLcl MCPサーバーを使うことで、データベースへどのようにアクセスするかを明確にできます。Oracle AI Databaseでは、データを管理する層に近い場所で、処理の実行、セキュリティ、記録の長期保存、検索を扱えます。セッションをまたいで情報を引き継ぐ必要があれば、Oracle AI Agent Memoryを追加します。その上で、Codex、Cursor、Antigravity、Claudeのいずれを開発に使うかを選べます。クライアントごとに、データベースの構成まで作り直す必要はありません。
これが、このシリーズで伝えたいことです。プロンプトの中でデータベースを丸ごと覚え込ませようとする代わりに、利用できるツールと操作範囲を適切に定め、権限などのルールはOracle Databaseで適用し、実際の処理結果を検証してください。そのうえで、後に引き継ぐ価値のある情報ができたときにだけ、長期保存するメモリを追加します。
よくある質問
SQLcl MCPでツールが見つかれば、すべての操作が許可されたことになりますか。
いいえ。利用可能なツールを確認することと、実行できる操作を制御することは別です。クライアントからMCPツールが見つかっても、実際に実行できる操作は、SQLcl MCPの設定、SQLclのコマンド制限、Oracle Databaseの権限に従います。
MCPと、情報を長期保存するエージェントメモリは同じものですか。
いいえ。MCPは、AIクライアントからツールを呼び出すための仕組みです。Oracle AI Agent Memoryは、それとは別のアプリケーション層で、Oracle AI Databaseを使い、情報の長期保存、対象範囲を限定した検索、スレッド、メモリレコードを扱います。
ノートブックには、実際のクライアントから収集した稼働データが示されていますか。
いいえ。ノートブックは、前提条件、データの保存と検索、メモリの設定、データベースを使う構成を検証するためのものです。クライアントの実際の動作は、設定したSQLcl MCPを使い、Codex、Cursor、Antigravity、Claudeで確認する必要があります。
どのバージョンを使えばよいですか。
各実践記事と関連ノートブックに記載されたバージョンと前提条件に従ってください。実行前に、SQLcl、Java、選択したクライアント、Oracle AI Agent Memoryパッケージについて、現在サポートされているバージョンを確認します。
異なるAIクライアントで、同じOracle SQLcl MCPのパターンを使えますか。
はい。このシリーズで共通の基盤を用意しているのは、そのためです。Codex、Cursor、Antigravity、Claudeでは開発時の使い勝手は異なりますが、承認済みのSQLcl接続、設定したツール、データベースの権限、検証手順を共通にすることで、アクセスの制限を一貫して適用できます。データベースへのアクセス方法を全面的に設計し直さなくても、クライアントを変更できます。
いつMCPワークフローにOracle AI Agent Memoryを加えるべきですか。
現在のやり取りが終わった後も、情報を引き継ぐ必要があるときに追加します。たとえば、ユーザーの好みを覚えておく、有用なプロジェクト情報を後のセッションで使う、以前のツール実行結果を取得する、繰り返し行う作業に合わせて対象範囲を限定した情報をモデルに渡す、といった場合です。MCPを導入したという理由だけで、メモリまで追加する必要はありません。まずOracle SQLcl MCPサーバーを介した接続と操作を検証し、その後、引き継ぐ価値のある情報ができたらメモリを追加します。
参考資料
- CodexとOracle AI Databaseで、アクセスを適切に管理したMCPワークフローを構築する方法
- 一連の処理を検証するCodexの関連ノートブック
- Oracle AI Databaseで、アクセスを適切に管理したCursorのMCPワークフローを構築する
- 一連の処理を検証するCursorの関連ノートブック
- Oracle SQLcl MCP ServerとOracle AI DatabaseでAntigravityのワークフローを構築する方法
- 一連の処理を検証するAntigravityの関連ノートブック
- Claudeのメモリ、Oracle AI Agent Memory、LangChainを組み合わせるべき場面
- 一連の処理を検証するClaudeの関連ノートブック
- Oracle AI Agent Memoryのドキュメント
- Oracle Database 26aiのドキュメント
- PyPIのoracleagentmemory
- SQLcl MCP Server