Im Paket einer Oracle Database Lizenz bzw. Subskription sind zahlreiche Komponenten enthalten, die KI Features der Oracle Database unterstützen. Ob es um die Ausführung von KI Agenten gehen soll, um Erzeugung von Vektoren und Vektor Indizes, beliebige Text-Generierungen oder sogar um ein intelligentes Gedächtnis für Agenten und KIs – spezialisierte Container können die Oracle Database entlasten, beliebige KI Aufgaben können in kontrollierten, privaten Umgebungen in beliebigen Clouds und on premises wahrgenommen werden. Verwaltet durch einen Kubernetes Operator wie dem OraOperator wird aus den diversen Containern nach und nach ein Konstrukt, das man als eine “private KI Plattform” für die Oracle Database bezeichnen könnte. Und nicht nur für die Oracle Database.
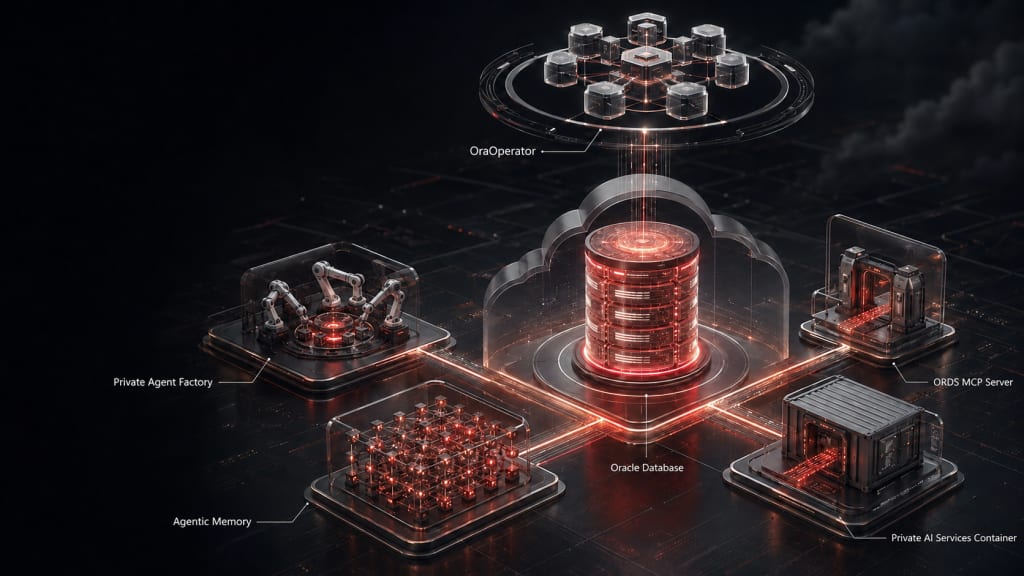
Die Komponenten Private Agent Factory ab Version 26.7 , ORDS MCP Server ab Version 26.2, Private AI Services Container ab Version 26.2, und der in der Private Agent Factory enthaltene intelligente und datenbank-gestützte AI Agent Memory sind als Container auf container-registry.oracle.com erhältlich und werden nach und nach vom Kubernetes Operator for Oracle Database, OraOperator, unterstützt.
Heute möchte ich erklären, wie der Private AI Services Container 26.2 mit Hilfe des OraOperator 2.2 nahezu beliebige LLMs von Huggingface.co herunterladen und auf einem “GPU-enabled” Knoten betreiben kann. Denn mit dem Private AI Services Container lassen sich nicht länger nur Embeddings und Vektor-Indizes berechnen, sondern er unterstützt ab dieser Version weitere wesentliche Teile der OpenAI kompatiblen Inferencing API. Beispielsweise kann er und seine von ihm verwalteten LLMs von In-Database Agents, SELECT AI und den Agenten und Chatbots der Private Agent Factory eingebunden werden, aber auch als generischer KI-Dienst für gängige KI Werkzeuge und Chatbots fungieren.
Kurze Information zum Private AI Services Container
Der kurz auch PAI genannte Private AI Services Container dient dazu, besonders rechenintensive Aufgaben im KI Umfeld der Oracle Database zu übernehmen und diese -rein optional- zu entlasten. Statt LLMs im sogenannten ONNX Format in die Datenbank zu laden und dort auszuführen bietet PAI einige wesentliche ONNX-formatierte LLMs bereits vorinstalliert und unkompliziert an (Liste unter “Included Models” in dem Oracle Container Registry PAI Repository). Per Parameter kann in der Oracle Database gewählt werden, ob Embeddings und Vektor Indizes auf den Datenbank-CPUs erzeugt werden oder ob ein “nearby” Service wie PAI diese Aufgabe übernehmen soll. Wenn Ihre Security Policies und Netzwerke dies erlauben, würde selbstverständlich auch ein Cloud Service wie OpenAI, OCI GenAI, Microsoft Foundry, AWS Bedrock usw. funktionieren.
Der Clou am neuen PAI: der Container bietet nun drei Ausführungs-Engines an, um LLMs zu nutzen und wahlweise auf GPUs oder preisgünstigeren Mehrkern-CPUs auszuführen. Sie können per Konfiguration wählen, welche Engine zu verwenden sei:
- Eine von Oracle angepaßte, auf CPU laufende ONNX Runtime mit 6 vorinstallierten kleinen und schnellen Embedding-LLMs. Natürlich können Sie auch weitere LLMs hinzufügen. Diese Runtime bietet eine REST API an, um Embeddings zu erzeugen – also keine Chats oder Texte zu generieren.
- Die llama.cpp Runtime, die aktuell auf CPU läuft und kleine generische und chat-fähige LLMs betreiben kann, die für CPU optimiert und entsprechend quantisiert wurden (GGUF Format mit AVX512 CPU Optimierung und Mixed-Integer-Quantisierung).
Der vorkonfektionierte “large” PAI container enthält bereits ein kleines ministral LLM mit 3 Milliarden Parametern. Es ist kein weiterer Download und keine weitere Klärung der LLM Lizenzvereinbarung notwendig. Sie bietet die Möglichkeit, LLMs direkt von Huggingface Repositories herunterzuladen und lokal zu starten. - Die vLLM Runtime, die neben CPU auch nvidia GPUs unterstützt. vLLM ist wahrscheinlich die beliebteste LLM Ausführungs-Engine neben ollama und sglang. Auch mit dieser Runtime können LLMs direkt von Huggingface Repositories heruntergeladen und gestartet werden.
Kurze Information zum OraOperator
OraOperator ist ein spezieller (nicht-Anwendungs-)Container, der im betreibenden Kubernetes Cluster neue Ressourcen bekannt macht und diese verwaltet. Das können in-cluster oder remote Oracle Datenbanken unterschiedlicher Ausprägung sein (RAC, Data Guard, Autonomous, BaseDB Service, Globally Distributed,…), oder vielleicht noch interessanter die immer zahlreicher werdenden datenbank-nahen Komponenten wie ORDS, Datenbank-Metriken, aber auch PAI und demnächst PAF (Private Agent Factory).
Gerade bei PAI Containern bietet der OraOperator einigen Komfort. Er kümmert sich bzw orchestriert u.a.:
- Die Einbindung von SSL Zertifikaten
- Die Einbindung von Security Token für REST Aufrufe und Huggingface Downloads
- Persistent Volumes für die heruntergeladenen LLMs
- Die Einbindung von Konfigurations-Dateien mit LLM Konfigurationen
- Die Netzwerk-Anbindung per LoadBalancer
- Skalierung und Zuteilung der Container auf verfügbare Server
- Den Reconcile, d.h. Abgleich der soll-ist Konfiguration und um Konfigurationsänderungen
Vorbedingungen
- Ein Kubernetes Cluster (OpenShift, OKE, AKS,…) mit mindestens einem GPU-Knoten darin (z.B. mit Nvidia A10 GPU). Mein Beispiel bezieht sich auf den in OCI laufenden OKE Service, aber ich werde auf Besonderheiten und Unterschiede eingehen. Z.B. werden GPU Knoten unterschiedlich gekennzeichnet bzw. annotiert. Der Cluster sollte vorübergehend Internet-Zugang (egress) haben, um Operatoren, LLMs und Anwendungscontainer herunterzuladen.
- Einen vorinstallierten cert-manager , das ist ein Kubernetes Operator der sich um die Verwaltung, Ausstellung und Erneuerung von Zertifikaten kümmert. Dessen Installation wird bei der Installation des OraOperator beschrieben, der ihn ebenfalls für interne Zwecke benötigt.
- Einen vorinstallierten OraOperator – die Installation ist relativ einfach und hier beschrieben:
https://github.com/oracle/oracle-database-operator/blob/main/README.md
Im Prinzip: YAMLs mit Ressourcen-Definitionen einspielen, YAMLs mit Berechtigungen einspielen je nachdem ob Ressourcen nur global oder auch lokal (“namespaced”) sichtbar sein sollen, den Container über ein Deployment YAML herunterladen und starten. - Ein Huggingface Login Token (HF_TOKEN), erstellt auf der Huggingface-Seite, sowie die Annahme der meist freien Lizenz für das zu verwendende LLM durch Button-Klick. Die LLMs “openai/gpt-oss-20b” oder “google/gemma4-12b-it” benötigen keine Annahme der Lizenzvereinbarung und auch kein HF_TOKEN für den Download. Ein LLM wie das medizinische “google/medgemma-27b-it” muss vor dem Download erst bestätigt werden und benötigt daher ein HF_TOKEN für den Download.
Um ein Token zu erzeugen klicken Sie auf Ihren Huggingface-Benutzer und wählen Sie das Menü “Access Tokens”. - Ein Download Token auf container-registry.oracle.com. Das wird als Kennwort für den Download der PAI Container verwendet, die ebenfalls vor dem jeweiligen Download eine Bestätigung der Lizenzvereinbarung benötigen. Um ein Token zu erzeugen klicken Sie auf Ihren Benutzer in container-registry.oracle.com und wählen Sie das Menu “Auth Token”.
Es geht los: Zertifikate, Konfigurationsdateien und Token anlegen
Starten wir, indem wir für unseren Test einen neuen Namespace anlegen:
$ kubectl create namespace private-aiDann brauchen wir ein kubernetes secret mit Namen container-registry-secret in dem neuen Namespace, in dem der Schlüssel für den Download der Container abgelegt wird. Wie in den Vorbedingungen genannt. Zum Beispiel wie folgt:
$ kubectl create secret docker-registry container-registry-secret -n private-ai --docker-server=container-registry.oracle.com --docker-username=meinusername@oracle.com --docker-password=DOWNLOADTOKENDamit der Zugriff auf den PAI Container ebenfalls nur mit einem Key erfolgen kann lassen wir uns einen erzeugen und legen ihn in einem secret Namens paisecret ab unter dem Eintrag bzw. key api-key. Es genügt eigentlich eine beliebige Zeichenfolge. Für etwas professioneller wirkende Token kann das auf github bereitgestellte Skript create_auth_secret.sh benutzt werden.
In das gleiche Secret legen wir auch den HF_TOKEN, den download Token für Huggingface repositories. Das Token muss unter dem Schlüssel huggingface-token abgelegt werden, damit der PAI Container den Token später finden kann.
$ kubectl create secret paisecret -n private-ai --from-literal=api-key=MYAPIKEY --from-literal=huggingface-token=MYHF_TOKENDer PAI Container sollte per HTTPS und mit eigenen Zertifikaten angesprochen werden. Erzeugen wir eben ein Test-Zertifikat mit Hilfe des vorinstallierten cert-manager , indem wir eine neue Ressource vom Typ Certificate anlegen – mittels kubectl apply -f und folgender Datei:
apiVersion: cert-manager.io/v1
kind: Certificate
metadata:
  name: privateai-cert
  namespace: private-ai
spec:
  commonName: api.example.com
  dnsNames:
  - api.example.com
  - pai-sample.private-ai.svc
  - pai-sample.private-ai.svc.cluster.local
  duration: 2160h
  issuerRef:
    kind: ClusterIssuer
    name: selfsigned-issuer
  keystores:
    pkcs12:
      create: true
      passwordSecretRef:
        key: privateai-ssl-pwd
        name: paisecret
  privateKey:
    algorithm: RSA
    rotationPolicy: Always
    size: 3072
  renewBefore: 360h
  secretName: privateai-tls
  usages:
  - digital signature
  - key encipherment
  - server auth
Das SSL Zertifikat wird mit Hilfe des meist vorinstallierten Test-Issuers namens selfsigned-issuer erzeugt und in einem Secret namens privateai-tls abgelegt. Das Passwort für den ebenfalls angelegten keystore wird zur bestehenden Secret-Sammlung in das paisecret hinzugefügt. Eine noch umfassendere Unterstützung beim Anlegen eines Zertifikates bietet das auf github bereitgestellte Skript tr-cert-manager.sh
Nun folgt noch eine Konfigurations-Datei in Form einer Kubernetes ConfigMap. In der Datei wird beschrieben, welche LLMs aus welchem HuggingFace Repository zu laden sind, und welche besonderen Parameter noch nötig sind, um beispielsweise den Speicherverbrauch bei kleinen GPUs (in meiner Umgebung eine Nvidia A10) ein wenig zu begrenzen. Auch dieses YAML Konstrukt können Sie mittels “kubectl apply -f” an Ihr Kubernetes Cluster senden:
apiVersion: v1
kind: ConfigMap
metadata:
  name: private-ai-config
  namespace: private-ai
data:
  config.json: |
    {
      "models":[
        {
          "name":"gpt-oss-20b",
          "path":"openai/gpt-oss-20b",
          "runtime":"vllm",
          "capabilities":["TEXT_GENERATION"],
          "runtime_arguments": [
             "--max-num-seqs", "8",
             "--max-model-len", "16384",
             "--gpu-memory-utilization", "0.95"
          ]
        }
      ]
    }
Die in der ConfigMap enthaltene Datei “config.json” wird dem PAI Container später an passender Stelle untergeschoben. Bei erfolgreicher Initialisierung des LLMs kann es unter dem Namen “gpt-oss-20b” in Chatbots und von Agenten verwendet werden. Es handelt sich dabei um das Open Weight LLM GPT-OSS von OpenAI. Es benötigt zum Download übrigens kein HF_TOKEN und es muss vorher auch keine Lizenzvereinbarung im Browser akzeptiert werden, ähnlich auch bei google/gemma-4-12B-it. Andere LLMs wie beispielsweise google/medgemma-27b-text-it hingegen benötigen sowohl Token als auch Annahme der Lizenzvereinbarung.
Obacht: aus Sicherheitsgründen werden nur LLMs im SafeTensor-Format von der vllm Runtime des PAI Containers unterstützt. Immer mehr stark quantisierte LLMs stehen beispielsweise als GGUF Format zur Verfügung. Sie können oft dieselben LLMs in anderen Repositories im SafeTensor Format finden oder ein LLM Ihrer Wahl im Format umwandeln und in einem eigenen Huggingface Repository (eigentlich ein riesiges git repository) bereitstellen.
Die ebenfalls im PAI Container enthaltene llama.cpp Runtime unterstützt das GGUF Format, kann im Moment aber nur auf CPUs ausgeführt werden und betreibt am liebsten CPU-optimierte LLMs. Für das ONNX Format gibt es eine weitere Runtime im PAI Container. Es verbleibt noch das langsam schwindende TensorFlow Format, das im PAI Container nicht unterstützt wird.
Die weiteren Parameter betreffen die zu nutzende Runtime wie onnx, llamacpp oder eben vllm, zu welchem Zweck das LLM dienen soll (z.B. EMBEDDINGS oder TEXT_GENERATION), und optionale Kommandozeilen-Parameter für die vllm Runtime.
Verwenden Sie keine config.json Datei, so stehen Ihnen die mit dem Container gebündelten LLMs zur Verfügung. Starten Sie einfach mehrere PAI Container mit unterschiedlicher Konfiguration, der OraOperator hilft Ihnen gerne dabei.
Anlegen einer neuen “PrivateAI” Ressource und Anpassung
Nun kommt alles zusammen, indem wir eine neue PrivateAI Ressource definieren und dem Kubernetes Cluster bzw. dem OraOperator übergeben. Der wird aus der Ressourcenbeschreibung weitere Kubernetes Komponenten anlegen und verwalten, z.B. ein Deployment, Pod, Netzwerk Dienst, und die Konfigurationen in die Komponenten einbinden. Ein Beispiel YAML für einen neuen PAI Container, der alles benutzt was wir bisher definiert haben:
apiVersion: privateai.oracle.com/v4
kind: PrivateAi
metadata:
  name: pai-quickstart
  namespace: private-ai
spec:
  security:
    authEnabled: true
    secret:
      name: paisecret
      mountLocation: /privateai/ssl
    tls:
      secretName: privateai-tls
      mountLocation: /privateai/ssl
  runtime:
    image:
      name: container-registry.oracle.com/database/private-ai:large-gpu-infer-26.2.1.0.0
      pullSecret: container-registry-secret
    replicas: 1
    # workerNodes:
    #   - 10.0.10.35
    resources:
      limits:
        nvidia.com/gpu: '1'
      requests:
        nvidia.com/gpu: '1'
  configuration:
    configFile:
      name: private-ai-config
      mountLocation: /privateai/config
  networking:
    service:
      ports:
      - port: 8443
        targetPort: 8443
        protocol: TCP
Erklärung der Parameter:
- security.authEnabled auf true gesetzt bedeutet, daß der API Key verwendet und geprüft werden soll, wenn der PAI Container per REST call aufgerufen wird
- security.secret gibt das kubernetes Secret an, in dem der oder die zu verwendenden API Keys stehen sollen sowie auch das (optionale) HF_TOKEN für den Download der LLMs
- security.tls gibt den Namen des Kubernetes secrets an, in dem die SSL Zertifikate abgelegt wurden. Der Mount Point sollte erst einmal nicht verändert werden.
- runtime.image gibt den Namen des zu ladenden PAI Container Images samt Kennwort-Secret an. Der hier verwendete “large” Container enthält mehrere kleine LLMs, die wir im Moment aber nicht verwenden, und die GPU-taugliche vllm runtime.
- runtime.workerNodes ist hier auskommentiert. Man kann hier den Namen der in Frage kommenden Kubernetes Knoten eintragen, auf denen die Container gestartet werden sollen. So lassen sich gezielt die Knoten eintragen, die mit GPUs ausgestattet sind. Eine beliebige nodeSelector Konfiguration ist zukünfig vorgesehen.
- runtime.resources kann ebenfalls steuern, auf welchen Knoten die Container gestartet werden. Denn die requests Angabe fordert ein GPU Device ein, das Kubernetes für den zu startenden Container reserviert. Die limits Angabe begrenzt den Container hier, nicht mehr als ein GPU device zu nutzen.
- configuration.configFile gibt an, aus welcher Kubernetes ConfigMap die config.json Datei zu holen ist und wo sie im PAI Container eingebunden werden soll. Den hier vorgegebenen Pfad bitte vorerst nicht ändern.
- networking gibt an , welche Art von Kubernetes Diensten an den Container anzuhängen sind und über welche Ports. Sie können diese Konfiguration erst einmal nutzen und dann eigene Dienste wie LoadBalancer, Gateways und Ingresses anhängen. Oder Sie geben wie in einer erweiterten Konfiguration auf github beschrieben bereits hier LoadBalancer Dienste an.
Eine manuelle Anpassung des Deployments ist eventuell noch notwendig ! Vorerst unterstützt die PrivateAI Ressource noch keine Angaben zu sogenannten Tolerations. Das wird in der nächsten Version des OraOperator behoben sein, so die Roadmap.
Also wundern Sie sich bitte nicht, wenn Sie die PrivateAI Ressource angelegt haben und der vom OraOperator verwaltete Pod dauerhaft im Pending Zustand bleibt: ein Blick in die Liste der Kubernetes Events (kubectl get events -n private-ai) verrät Ihnen wahrscheinlich, dass kein passender Knoten gefunden werden konnte. Das liegt daran, dass Kubernetes Knoten mit GPU Unterstützung in Cloud Umgebungen gerne auf besondere Weise markiert werden, sie erhalten vom System einen “Taint“. Dieser sorgt dafür, dass nur Container, die diesen Taint tolerieren, auf solchen Knoten gestartet werden können.
In einem solchen Fall editieren Sie bitte das vom OraOperator erzeugte Deployment mittels “kubectl edit deployment pai-quickstart -n private-ai“. Tragen Sie eine zum markierten Knoten passende Toleration ein, in meiner OKE Umgebung beispielsweise wie in folgendem Snippet:
...
      imagePullSecrets:
      - name: container-registry-secret
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext:
        fsGroup: 2001
        runAsGroup: 2001
        runAsUser: 2001
      terminationGracePeriodSeconds: 30
      tolerations:
      - effect: NoSchedule
        key: nvidia.com/gpu
        operator: Exists
...
Welcher Taint in Ihrer Umgebung zu tolerieren ist, das sehen Sie wenn Sie Ihre Kubernetes Knoten gezielt nach deren Metadaten abfragen, z.B. wie hier:
$ kubectl get nodes -o json|jq '.items[].metadata.name'
"10.0.10.12"
"10.0.10.159"
"10.0.10.35"
"10.0.10.37"

$ kubectl get nodes -o json|jq '.items[].spec.taints'
null
null
[
  {
    "effect": "NoSchedule",
    "key": "nvidia.com/gpu",
    "value": "present"
  }
]
null
Haben Sie bitte keine Sorge, daß diese Anpassung beim nächsten reconcile Vorgang des OraOperator wieder überschrieben wird: der Bereich tolerations wird vom OraOperator zur Zeit nicht überwacht und daher auch nicht auf seinen nicht vorhandenen Soll-Wert zurückgesetzt. Das wird sich wahrscheinlich in der nächsten Version ändern.
Start und Test des Containers
Nun sollte der PAI Container sauber starten, und wir können mit kubectl logs sehen, ob alle Parameter greifen und der Container komplett hochfährt. Obacht: die herunterzuladenden LLMs werden ins GPU RAM geladen und auch Ahead-of-time compiliert. Das kann mehrere -zig Sekunden bis zu Minuten dauern ! Das sieht zum Beispiel so aus:
$ kubectl get pods -n private-ai

NAME                             READY   STATUS    RESTARTS   AGE
pai-quickstart-7f9757b8f-2dg8p   1/1     Running   0          6h40m


$ kubectl logs pai-quickstart-7f9757b8f-2dg8p -n private-ai

INFO: Config file set to /privateai/config/config.json
INFO: Keystore path set to file:/privateai/ssl/keystore
INFO: API Key path set to /privateai/ssl/api-key
INFO: Hugging Face token loaded from secret /privateai/ssl/huggingface-token

08:51:48.618 [main] INFO  i.m.s.ObjectMappers$ObjectMapperContext$1 - Established active environments: [k8s, cloud]
  ____       _            _            _    ___
 |  _ \ _ __(_)_   ____ _| |_ ___     / \  |_ _|
 | |_) | '__| \ \ / / _` | __/ _ \   / _ \  | |
 |  __/| |  | |\ V / (_| | ||  __/  / ___ \ | |
 |_|   |_|  |_| \_/ \__,_|\__\___| /_/   \_\___|
  Private-AI (version small-cpu-infer-26.2.1.0.0, build 2.0.42)

08:51:48.846 [main] INFO  i.m.c.DefaultApplicationContext$RuntimeConfiguredEnvironment - Established active environments: [k8s, cloud]
08:55:33.357 [main] INFO  i.m.l.PropertiesLoggingLevelsConfigurer - Setting log level 'ERROR' for logger: 'io.micrometer.core.instrument.binder.cache.CaffeineCacheMetrics'
08:55:33.357 [main] INFO  i.m.l.PropertiesLoggingLevelsConfigurer - Setting log level 'ERROR' for logger: 'io.micrometer.core.instrument.binder.cache.caffeine-cache-metrics'
08:55:33.691 [main] INFO  io.micronaut.runtime.Micronaut - Startup completed in 224855ms. Server Running: https://0.0.0.0:8443
Sie sehen bereits in den ersten Zeilen, daß API Key, keystore, Konfigurationsdatei und Huggingface Token eingebunden wurden. Und ganz am Ende des Logs sehen Sie, daß das geladene LLM mehrere Minuten zur Initialisierung benötigt hat. Wohl dem, der mehrere GPUs im Zugriff hat und die Container rollierend durchgestartet werden können !
Testen wir nun, ob wir mit dem LLM chatten können. Auf Kommandozeile geht das recht einfach, indem wir uns direkt mit einer Shell in den Container hinein verbinden und dort einige curl Kommandos aufrufen:
$ kubectl get pod -n private-ai

NAME                             READY   STATUS    RESTARTS   AGE
pai-quickstart-7f9757b8f-2dg8p   1/1     Running   0          6h53m

$ kubectl exec -ti pai-quickstart-7f9757b8f-2dg8p -n private-ai -- /bin/bash

[ai_user@pai-quickstart-7f9757b8f-2dg8p app]$ curl https://127.0.0.1:8443/v1/models --insecure -H "Authorization: Bearer MYAPIKEY"

{"data":[{"id":"gpt-oss-20b","modelDeployedTime":"2026-09-03T08:51:52.059736071Z","modelSize":"14.03G","modelCapabilities":["TEXT_GENERATION"]}]}[
Der eben abgesetzte curl-Aufruf prüft, welche LLMs geladen sind und unter welchem Namen sie zur Verfügung stehen (hier: gpt-oss-20b). Der –insecure Parameter sorgt dafür, dass das (Test-)Zertifikat nicht weiter geprüft wird.
Der folgende Aufruf nutzt die OpenAI-kompatible Chat API, um das gestartete LLM zu begrüßen:
$ curl -X POST https://127.0.0.1:8443/v1/chat/completions --insecure \
-H "Authorization: Bearer MYAPIKEY" \
-H "Content-type: application/json" \
--data '{
    "model": "gpt-oss-20b",
    "messages": [{"role": "user", "content": "Hello!"}],
    "stream": false,
    "options": {
        "use_mmap": true,
        "use_mlock": true,
        "num_thread": 4
    }}'

{"id":"chatcmpl-a6032acc20e02ed0","object":"chat.completion","created":1788454191,"model":"gpt-oss-20b","choices":[{"index":0,"message":{"tool_calls":[],"content":"Hello there! How can I help you today?","role":"assistant"},"finish_reason":"stop"}],"usage":{"prompt_tokens":11,"total_tokens":22,"completion_tokens":11}}
Diskussion: Netzwerk-Anbindung
OraOperator hat in unserer Beispiel-Konfiguration einen Kubernetes-internen Service erzeugt, d.h. vom Typ ClusterIP, der zwischen mehreren Instanzen bzw. Replica der Container Load Balancing betreibt.
$ kubectl get service -n private-ai

NAME             TYPE        CLUSTER-IP   EXTERNAL-IP   PORT(S)    AGE
pai-quickstart   ClusterIP   None         <none>        8443/TCP   16d
Damit sind die PAI Container innerhalb des Kubernetes ansprechbar, d.h. wenn Sie eine Oracle Datenbank oder die Private Agent Factory ebenfalls als Container in Kubernetes betreiben können Sie nun jeweils den Provider “privateai” bzw. “openai” (für OpenAI-kompatibel) oder sogar “vllm” konfigurieren und den PAI Container ganz privat und exklusiv für Chats, Agenten und Embeddings nutzen.
Natürlich können Sie ab dieser Stelle eine weitere Netzwerk-Anbindung von außerhalb des Kubernetes Clusters hinzufügen. Die PrivateAI Kubernetes Ressource (bzw. OraOperator) kann für Sie einen LoadBalancer Dienst anlegen, der eine externe IP Adresse erhält und auf die PAI Container verweist. Ich persönlich präferiere es, einen zusätzlichen Kubernetes Ingress oder einen Gateway-Dienst zu konfigurieren, der nach außen hin offizielle SSL Zertifikate verwendet und intern mit “technischen” Zertifikaten des PAI Containers kommuniziert – oder der erweiterbar ist um zusätzliche Security Prüfungen.
Ab dann kommen Sie auch von Ihren Exadata Systemen und Entwicklerarbeitsplätzen mit deren KI Assistenten an ihren immer noch sehr privaten KI Dienst bzw. Inferencing Service heran und können ihn auch großflächiger nutzen.
Fazit
Die Komponenten Private Agent Factory, Agent Memory, ORDS MCP, PAI Container und die Oracle Database sind aufeinander abgestimmt und können eine eigene self-hosted (wenn auch komfortabel dank Kubernetes) KI Plattform bilden, die von anderen Agenten und KI Systemen genutzt werden darf. Der OraOperator wird im Moment um den Support dieser neuen Komponenten erweitert und erhöht den Komfort bei der Inbetriebnahme, indem er die anonymen Container und Netzwerkstrecken zu überwachten und CI/CD tauglichen (Micro-)Services zusammenfasst. Der Private AI Services Container kommt mit gängigen Runtime Umgebungen daher und bietet den Komfort, die wichtigsten Embedding-LLMs und ein kleines Chat-fähiges LLM bereits mitzuführen. Alle Komponenten sind aufeinander abgestimmt und Teil des Supports der Oracle Database. Ich freue mich sehr, Ihnen demnächst von weiteren neuen Services zu erzählen !
Links
Informationen und weitere Blogs zum OraOperator und zum Private AI Service Container:
- Sanjay Singh: Announcement des OraOperator 2.2 mit weiteren Links
- Markus Kissling: Einbindung des PAI Containers in die Oracle Database
- Doug Hood: Getting started with PAI Container (mit podman)
- Oracle Database Dokumentation zum PAI Container
- PAI Container auf container-registry.oracle.com, mit Anleitung
- OraOperator auf container-registry.oracle.com, mit Link zur Anleitung
- OraOperator github Repository