※ 本記事は、Jay Sardharaによる”Powering AI Agents with Autonomous AI Lakehouse connected to Oracle and Databricks data“を翻訳したものです。
2026年11月2日
大企業の多くでは、データがさまざまなデータソースや既存の分析環境に分散しています。それらを移動、複製せずに、1つのレイクハウスへ接続したいと考えています。分析を始める前に、チームはソースを見つけ、メタデータを調べ、適切なアクセス権を得る必要があります。
この手順では、Data StudioからOracle AI Data Catalogを使ってソースを接続し、探索のアクセス権を管理します。管理者としてカタログの設定を完了した後、権限のないユーザーに何が見えるかと、権限を持つユーザーがカタログを参照してサンプルクエリを実行する方法を示します。
AI Data Catalogのデータベースを作成する
Data StudioのDataからAI Data Catalogを開き、Createを選びます。Databases画面からも作成できます。データベースが作成されたら、カタログのオブジェクトストレージを設定します。
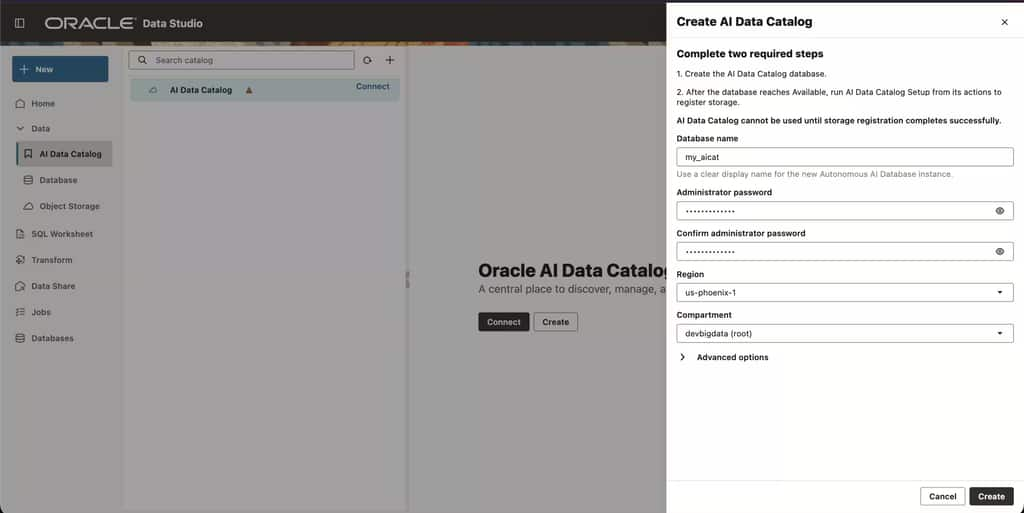
図1:AI Data Catalogをホストするデータベースを作成します。
ストレージを登録して設定を完了する
AI Data CatalogがIcebergカタログのデータを読み書きする場所として使えるように、オブジェクトストレージを設定する必要があります。選択したバケットは、テーブルデータのIcebergウェアハウスとなります。設定では、カタログをホストするデータベースへADMINで接続し、ストレージの資格証明を登録します。
Databases画面の対象、またはナビゲータのAI Data Catalogから実施できます。
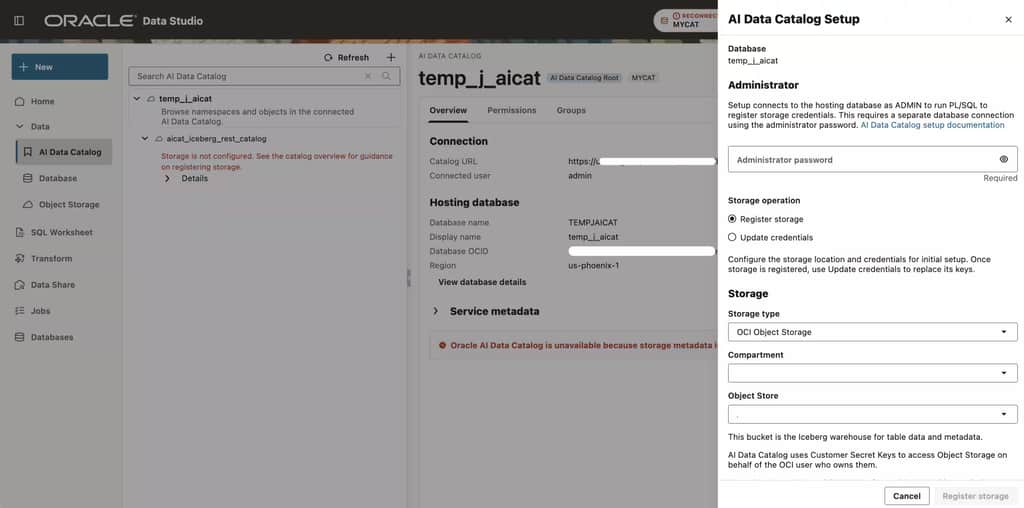
図2:ストレージの場所と資格証明を登録します。
詳細:AI Data CatalogのObject Storage設定
Databricks Unity Catalogを接続する
+でIcebergカタログを追加し、Catalog Typeを選びます。Iceberg RESTエンドポイント、認証情報、カタログのオブジェクトストレージ設定を入力します。
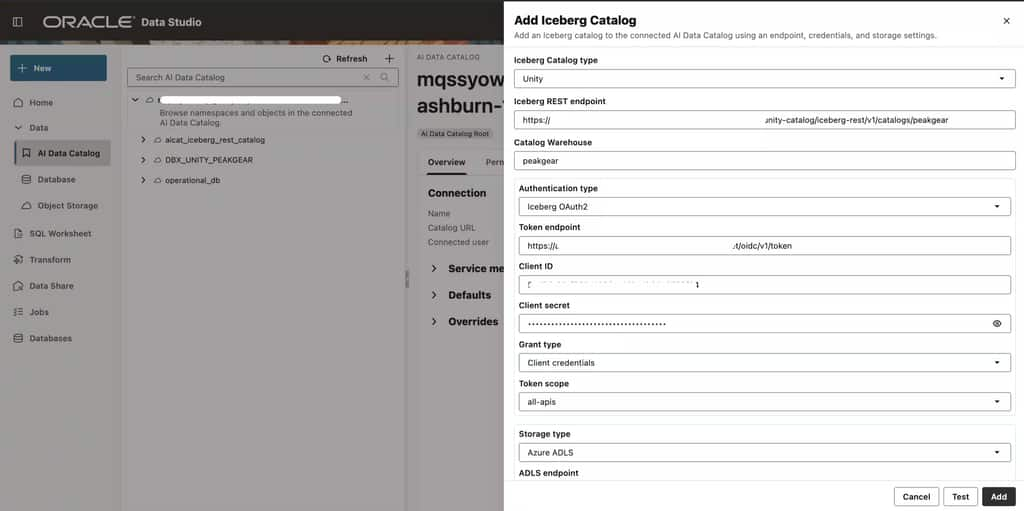
図3:エンドポイント、認証、ストレージ設定でUnity Catalogを追加します。
管理者はDBX_UNITY_PEAKGEARとそのicebergスキーマを展開し、digital_clickstream_eventsやproductsなどのテーブルを確認できます。このメタデータを調べることで、顧客行動分析に関連するデータを特定できます。
詳細:Oracle AI Data CatalogのOAuth
Oracleの業務データベースを接続する
+でJDBCカタログを接続します。データベース種別にOracleを選び、接続情報を入力します。
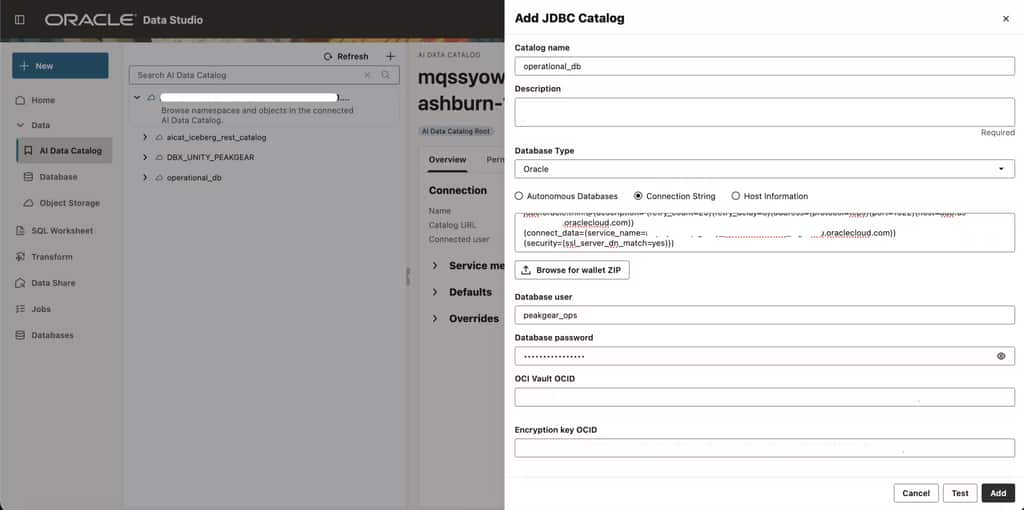
図4:Oracle Databaseをoperational_dbというJDBCカタログとして登録します。
DatabricksとOracleが同じナビゲーションツリーに並びました。次に、分析チームへデータ探索に必要な権限を付与します。
AI Data Catalogへのアクセス権限
すでにMANAGE権限を持つAI Data Catalogユーザーで、カタログのルートを選び、Permissions、Grant accessの順に開きます。Userを選択し、対象のプリンシパルを指定します。この例では、analytics_userというユーザーにBROWSE_METALAKEを付与します。
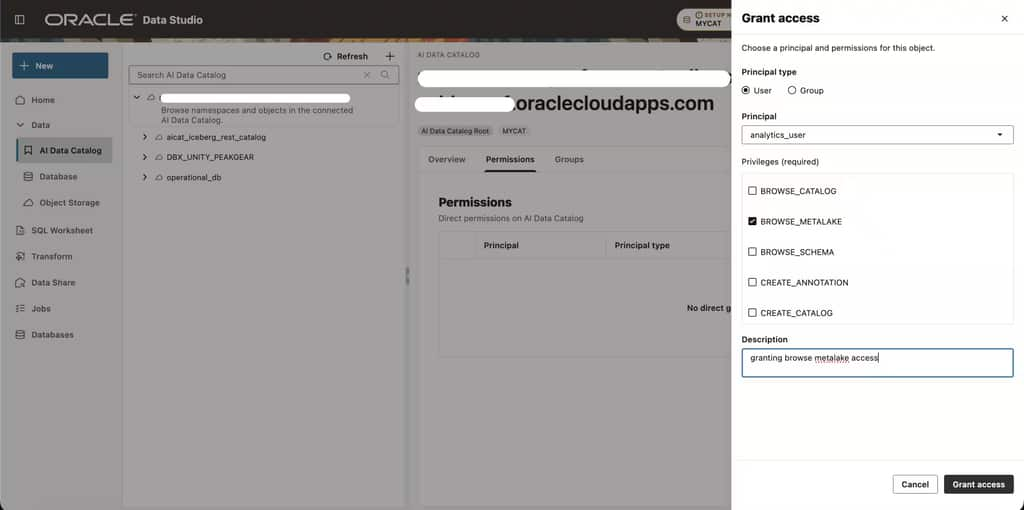
図5:ルートでanalytics_userにBROWSE_METALAKEを付与します。
グループでアクセスを管理する
チームに対しては、ルートのGroupsタブでAnalytics_Teamなどのグループを作成し、メンバーを管理します。Grant accessでプリンシパルの種類にGroupを選び、必要な権限をグループへ付与します。管理者は、グループへの所属によって共通のアクセス権を維持できます。
権限を付与したユーザーの表示を確認する
対象ユーザーとして接続し、カタログツリーを更新してアクセスを確認します。以下の権限付き表示では、analytics_userはaicat_iceberg_rest_catalogとMY_NAMESPACEを展開し、SALES_CURATEDとSALES_RAWを確認できます。これはカタログの参照権限の検証であり、テーブルの行データを読み取る権限の確認ではありません。
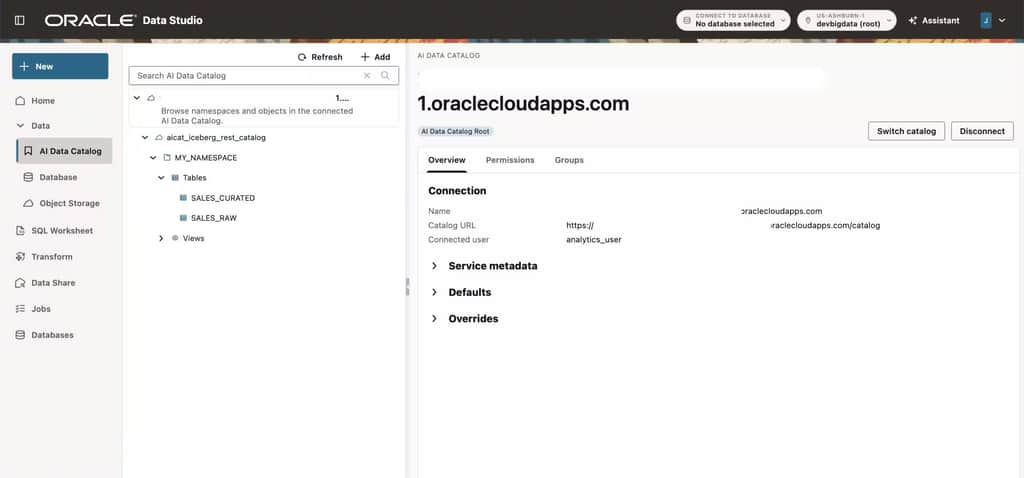
図6:権限のあるユーザーがカタログ、名前空間、表示可能な表を参照できます。
顧客行動データのサンプルをクエリする
SQL Worksheetを選び、対象表を探します。
データのクエリにはOracle Databaseが必要で、接続されたOracle Databaseのセッションユーザーが使われます。Database Settings、またはSQL Worksheetのバナーメッセージで、必要な権限と設定を確認してください。
Oracle AI Data Catalogのユーザー接続は、カタログのメタデータを参照するために使われます。テーブルの行データをクエリするには、接続しているカタログユーザーにOracle AI Data CatalogのSELECT_TABLE権限を付与することも必要です。
以下は、同様のデータソースを接続した別のOracle AI Data Catalogの画面です。
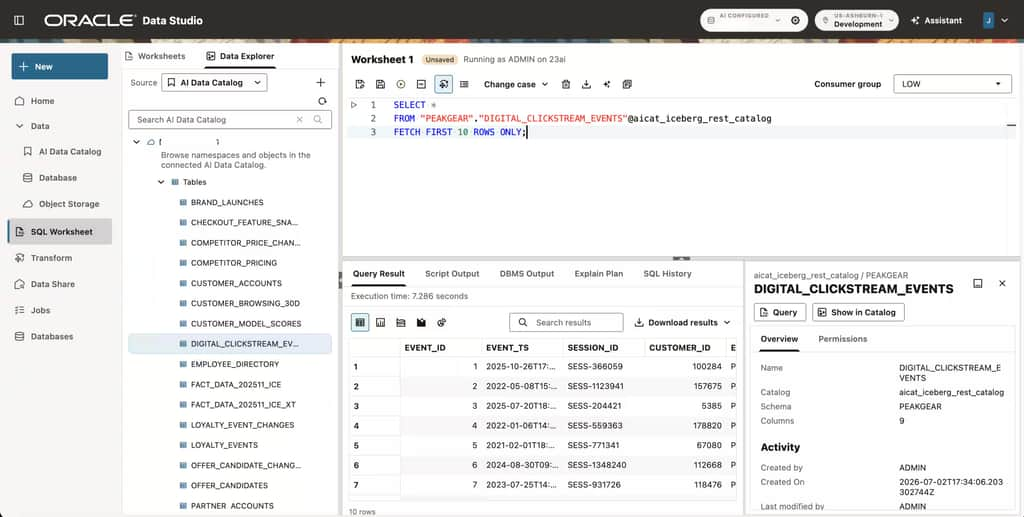
図7:AI Data Catalog経由でDIGITAL_CLICKSTREAM_EVENTSの10行を取得します。
AIアシスタントによる探索と自然言語
AIアシスタントは、Data Studio画面の主要な機能です。自然言語のプロンプトを使い、接続されているすべてのデータソースからメタデータを探索し、さらにデータ探索を支援するクエリを生成できます。いずれも、接続ユーザーの権限に従います。
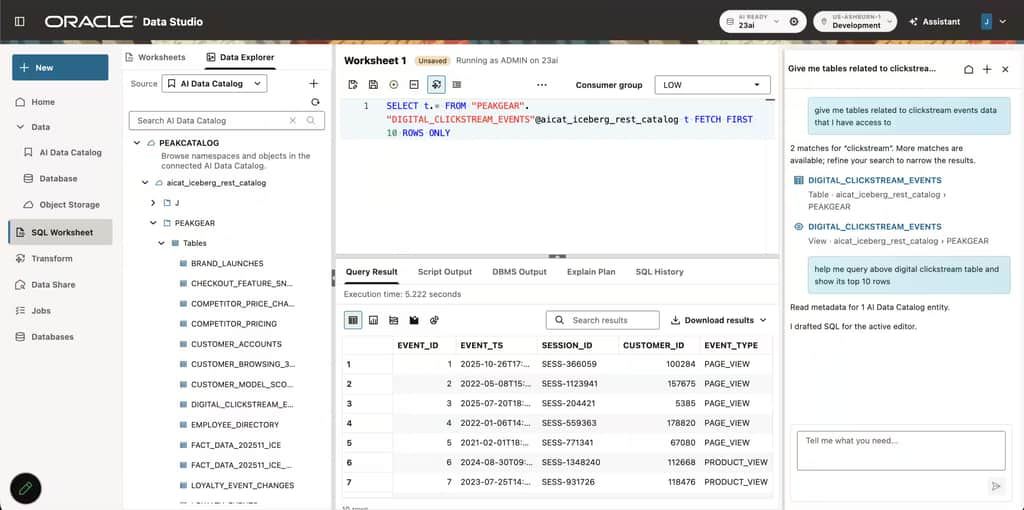
図8:AIアシスタントがメタデータとデータの探索を支援します。
ガバナンスの下で管理する1つのOracle AI Data Catalogを使い、分散した異なるデータソースを接続して、ユーザーとAIがデータを発見、利用できるようにしました。