※ 本記事は、Adrian Scottによる”A modern path from Oracle Fusion Applications to AI Lakehouse“を翻訳したものです。
2026年11月2日
Data Transformsが、3クリックでデータを橋渡しします。Spectra Batch Processingコネクタを使い、FusionのデータをAutonomous AI Lakehouseへ取り込みます。増分ロード、削除、並列ロードは、ツール側で処理します。
Fusion ApplicationsからAI Lakehouseへの新しい経路
Autonomous AI Lakehouseのパイプライン作成機能であるOracle Data Transformsは、BI Cloud Connector(BICC)接続、または新しいSpectra Batch Processing接続を通じて、Fusion Applicationsからデータを抽出します。どちらも、抽出するデータオブジェクトと、結果を格納する出力先スキーマを設定できます。使い慣れたData Transformsの設計エディタと実行エディタでロードを管理するため、他のデータ統合作業と並べて作成、実行、監視できます。
FusionとLakehouse、その間のデータ
Fusionは、企業の業務運営を支えるOracleのSaaSソリューションです。Autonomous AI Lakehouseは、Oracleのデータレイクハウスソリューションです。この記事では、前者から後者へデータを取り込む方法を説明します。
Fusionは、財務(ERP)、サプライチェーン(SCM)、人材(HCM)、顧客(CX)、計画(EPM)をカバーし、14,000社以上の企業が利用しています。単一のデータモデルに基づくため、仕入先、顧客、従業員は、すべてのモジュールを通じて1つのレコードとして扱われます。OracleはFusionを四半期ごとに更新します。Lakehouseは、このデータを他のシステムのデータと組み合わせ、変換し、SQLや自然言語で分析する場所です。
Fusionは、支出、納品、契約上のコミットメント、請求書、従業員数など、さまざまなデータ分析に必要な情報を管理する信頼できる基幹システム(System of Record)としての役割を担っています。分析では通常、他システムの情報との組み合わせ、取引処理ではなくレポート向けの整形、利用中の業務アプリケーションへ負荷を加えないクエリが必要です。そのため、データをレイクハウスへコピーし、そこで分析します。Fusionアプリケーションを妨げず、確実に繰り返し抽出する必要があります。
これまで、抽出自体が1つのプロジェクトでした。従来のBI Cloud Connector(BICC)では、業務分野ごとにビューオブジェクトを選び、BICCコンソールで抽出ジョブをスケジュールし、Universal Content ManagementまたはOCI Object StorageでCSVを受け取り、その後のロード処理を作成します。BICCは一括抽出と増分抽出に信頼性がありますが、バッチ専用です。条件に応じた行の絞り込みや数分ごとの実行はできず、大量の抽出を頻繁に行うとアプリケーション性能へ影響します。そのため、チームは関連するスケジュール、ファイル処理、増分ロジック、削除処理を作成、保守することになります。REST APIは大量処理ではなくリアルタイム連携向けで、Oracleは、レポートエンジンであるBI Publisherを抽出に使うことを推奨していません。
Spectra:Fusionの次世代データ基盤
Spectraは、Fusionを支える新しいプラットフォームです。Spectra Batch Processingは、そこで大量のデータを抽出するサービスです。Lakehouseのパイプライン作成機能Data Transformsに、そのコネクタが追加されました。
Spectra Batch Extractは、Fusionのデータをデータベース・ビューとしてではなく、ビジネス・オブジェクトとして利用できるようにする機能です。これに加えて、Oracleは新たにRead-Optimized Data Store(RODS:読み取り最適化データストア)を導入しました。RODSは、Fusionのデータを継続的に同期する仕組みで、Oracle GoldenGateを使用してAutonomous AI Lakehouseのテクノロジー上にデータを複製し、大量のデータ読み取りを伴う処理に最適化されています。データの抽出処理はRODSに対して実行されるため、Fusionアプリケーションのトランザクション処理に負荷をかけることなく、データを取得できます。また、従来のように夜間のバッチ処理でデータを更新するのではなく、継続的な同期によって、複製されたデータを常に最新の状態に近い形で維持できます。
Spectra Batch Processingは、このプラットフォーム上の一括抽出サービスです。業務オブジェクトを対象にバッチジョブを送信すると、RODSに対して実行され、出力ファイルがOCI Object StorageまたはUniversal Content Managementへ到着した時点で終了します。受け渡しの場所はBICCと同じです。FusionのOracle Data Extraction Toolも、Data Transformsも、このサービスのクライアントです。
Data Transformsは、受け渡しの前後をまとめて処理します。抽出対象を定義し、Spectraバッチジョブを送信、監視し、ファイルの到着を検知し、必要に応じてジョブを再起動します。続いて、各テーブルに適切なアップサートや削除を適用しながら、Autonomous AI Lakehouseへロードします。Incremental Mergeに設定したオブジェクトでは、変更された行がマージされます。Incremental with Deletesでは、Fusionから削除された行が出力先からも削除されます。
接続には、FusionのサービスURL、OAuthトークン・エンドポイント、クライアントID、クライアント・シークレット、スコープの設定が必要です。これらの接続処理を独自のコードで開発することもできますが、Data Transformsを使用すれば、ウィザード形式の画面から簡単にデータロードを設定できます。 また、データロードの実行スケジュールを設定したり、Jobsパネルから実行状況を監視したりすることもできます。
Spectraは現在、多くのFusionモジュールに対応しており、新しく追加されるモジュールもサポートしています。さらに、四半期ごとのリリースに合わせて、対応するビジネス・オブジェクトの範囲も拡大しています。なお、RODSによるデータ複製を含むSpectraプラットフォームを利用するには、Oracleを通じてFusion環境にプロビジョニングする必要があります。Spectraがまだ対応していないモジュールについては、引き続きBICC接続を利用できます。BICC接続も同じウィザードから設定できるため、Data Transformsという1つのツールで、SpectraとBICCの両方を使用したデータ連携に対応できます。
重要な理由
Data Transformsを使用すると、FusionのデータをLakehouseに取り込む際の複雑な処理を自動化できます。 差分データの取り込み、削除された行の反映、並列ロードなどの処理をData Transformsが担うため、ユーザーが個別に実装する必要はありません。データエンジニアにとっての大きなメリットは、データ連携に必要な一連の処理を個別に開発・管理する手間を大幅に削減できることです。BICCとSpectraのどちらを使用する場合でも、データの抽出処理自体は、ファイルがオブジェクト・ストレージに保存された時点で完了します。しかし、実際のデータ連携には、その前後にさまざまな処理が必要です。例えば、抽出対象データの定義、ジョブの実行と監視、ファイルの到着確認、データのロード、変更データのマージ、削除データの反映、そして処理全体の監視といった一連のステップがあります。Data Transformsでは、これらの処理を1つのデータロードとしてまとめて管理できます。 さらに、データロードの設計、スケジュール設定、実行状況の監視を、その後のデータ変換処理と同じツール上で行えます。これにより、複雑なデータ連携処理をシンプルに管理でき、データエンジニアは個々の処理の実装や運用ではなく、データの活用や変換ロジックの開発に集中できます。
業務側にとっては、アプリケーションではなく読み取り最適化コピーから抽出するため、Fusionデータを、より早く、より頻繁にLakehouseへ届けられます。リスクの大きい仕入先はどこか、といった質問に、完全で最新のデータと、Lakehouse内の他のすべての情報を組み合わせて答えられます。
Data Transformsを選ぶ理由
Data TransformsはAutonomous AI Lakehouseに組み込まれており、インストールは不要です。アプリケーション、データベース、ファイル、オブジェクトストレージからのロード、ノーコード設計やSQLでの変換、ワークフローへの編成、スケジュール、すべての実行の監視まで、1つのツールとコンソールで扱います。変換はLakehouse内で実行され、データを別エンジンへ取り出して戻すことはありません。
同じ1つのツールで、Oracle Fusion、NetSuite、Salesforce、その他のSaaS、主要クラウドのウェアハウスやレイクハウス、Apache Icebergなどの公開形式へ接続します。ツールと受け渡しが簡単になり、何が実行され、何が失敗し、その理由は何かを、一か所で確認できます。
Fusionの抽出、増分、削除、変換、スケジュールを1つで扱い、独立した抽出基盤は不要です。
3ステップでFusionデータをAI Lakehouseへ取り込む
例えば、データエンジニアが、取引先ごとの支出額、納品遅延、未履行の契約上のコミットメント、外部リスクの高さを分析し、注意が必要なサプライヤーを特定したいとします。この分析に必要なデータの多くは、Fusion ERP、Procurement、SCMなどのモジュールで管理されています。一方、サプライヤーのリスク情報など、一部のデータは外部のデータソースから取得する必要があります。このようなレポートを作成するには、まずFusionに保存されている関連データをAI Lakehouseに取り込む必要があります。
従来、Fusionからのデータ抽出には、多くの設定や処理ステップが必要でした。しかし、Data Transformsを使用すれば、こうした複雑な処理を意識することなく、わずか3つの簡単なステップでデータを取り込めます。具体的な手順は以下のとおりです。
- Fusionアプリケーションへの接続を作成、設定する。
- 抽出するオブジェクトを選ぶ。
- データロードのスケジュールを作る。
Fusionの生データをロード、整理するFusion Launchカード
1 Data StudioからFusion Launchウィザードを実行する
ホームからFusion Launchを起動します。Data Studioはdatastudio.oracle.com、またはOCIコンソールのDatabase Actionsから開けます。
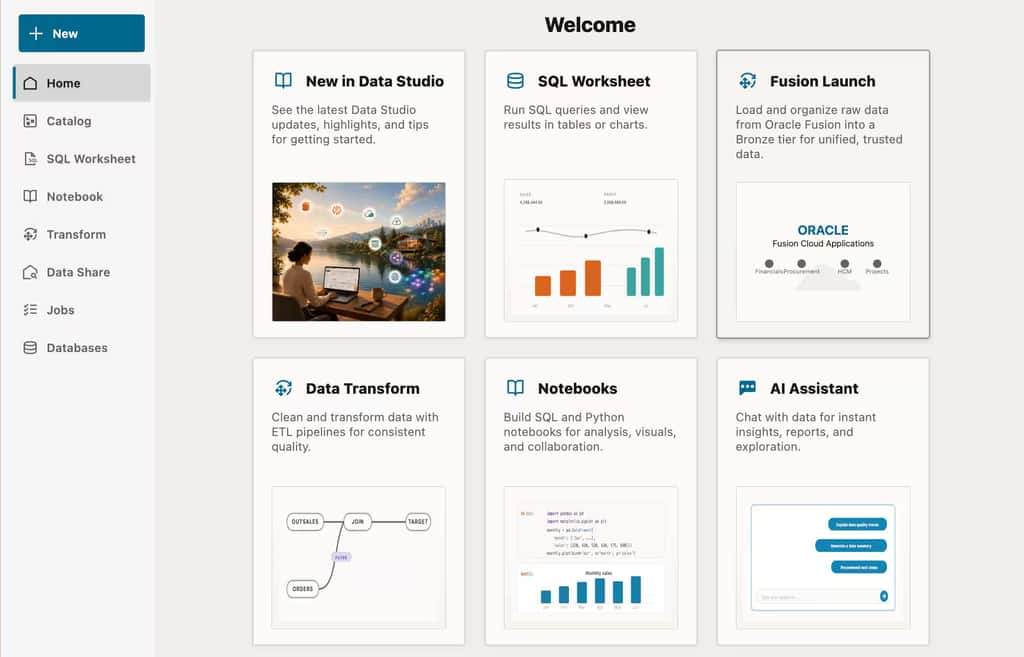
図1:Fusion Launchウィザードのあるホーム画面。
初回はOracle Cloud Applications(Fusion)への接続を作成します。抽出方法は次の2種類です。
- BI Cloud Connector(BICC): 多くのモジュール向けの、ビューオブジェクトに基づく従来方式。
- Spectra Batch Processing: 多くの既存モジュールと全新規モジュール向けの、RODS上で動く業務オブジェクト方式。
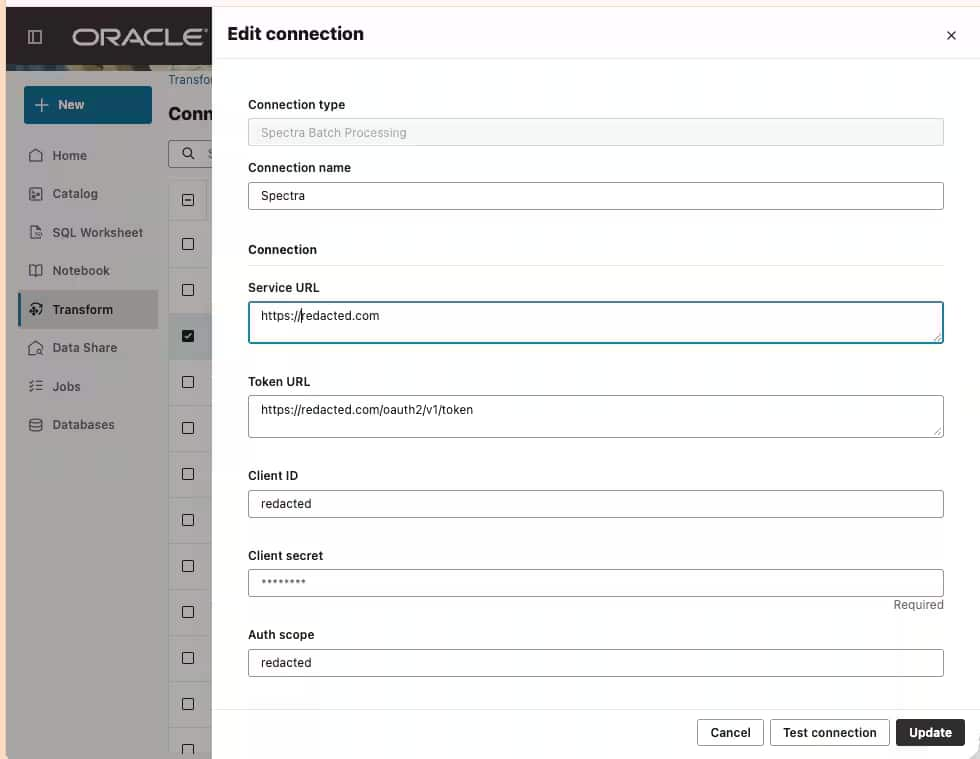
図2:Fusionの接続資格証明を入力します。
入力後に接続をテストし、ウィザードを進めます。
2 抽出するモジュールとオブジェクトを選ぶ
関心のあるFusionの機能領域を選択します。領域を絞ることで、後で抽出対象のオブジェクトを見つけやすくなります。すべての領域を選択し、エディタで絞り込むこともできます。
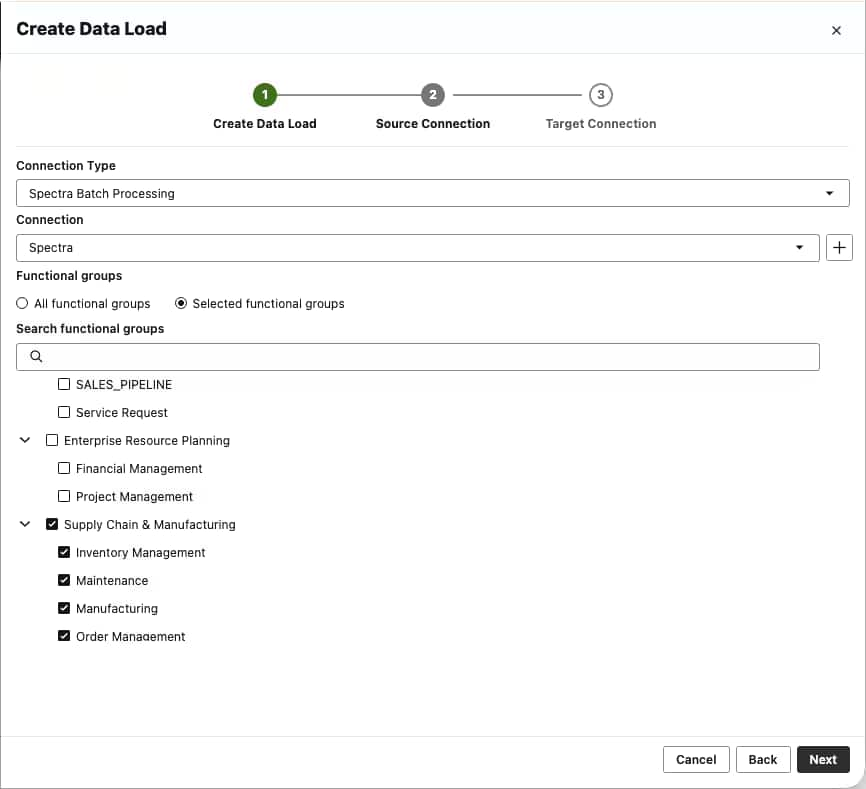
図3:抽出方式と業務領域を選びます。
ウィザードが完了すると、Data TransformsはData Load Editorを開きます。フィルタと検索項目で対象を見つけ、複製するオブジェクトを選びます。オブジェクトごとに、削除も処理するかを選択できます。Fusionアプリケーションに行が存在しなくなれば、出力先テーブルからも削除されます。選択したすべてのオブジェクトは増分処理となり、変更データの検出方法とマージキーはData Transformsが判断します。
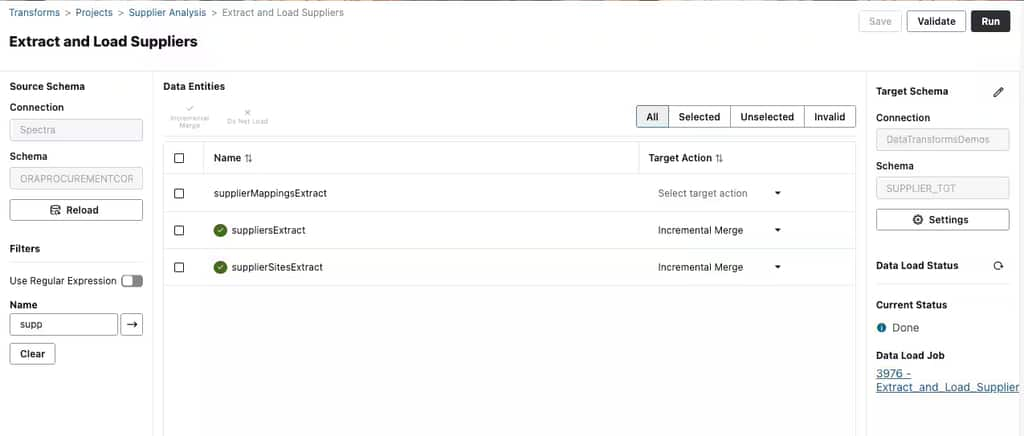
図4:抽出するFusionオブジェクトを選びます。
3 実行をスケジュールし、抽出を監視する
保存後、Data Load Editorから直接実行するか、ワークフローを作ってスケジュールに追加します。
Jobsパネルでジョブの状態を追跡します。Data Loadジョブには、選択したオブジェクトと、抽出が完了したテーブルごとの挿入行数、更新行数が表示されます。ロード完了後、ジョブ詳細レポートに、最終的な統計とエラー情報が集約されます。
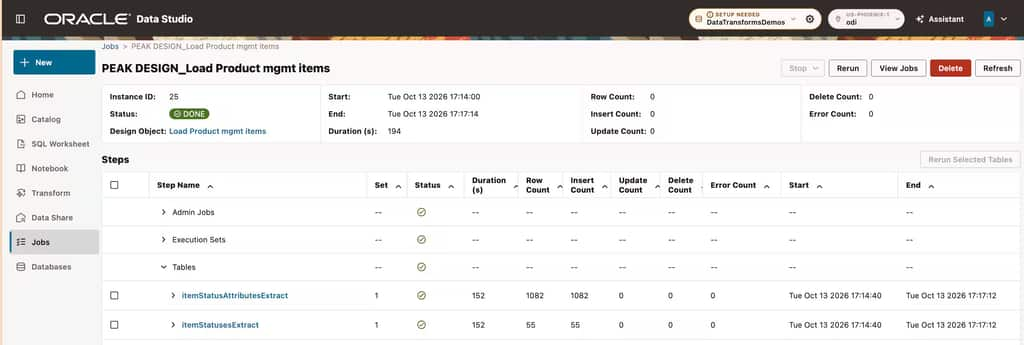
図5:完了した抽出の状態、行数、ロード操作、所要時間、エラー数。
4 変換して他システムのデータと結合する
FusionデータをAI Lakehouseへロードした後、Data Flow Editorで変換します。以下の例では、仕入先リスク分析用の外部情報を加え、拡張された仕入先テーブルを作成します。Lookup演算子で一致する可能性を高めるため、両方のテーブルの仕入先名を正規化します。フローは、分析用の新しいテーブルを作成します。
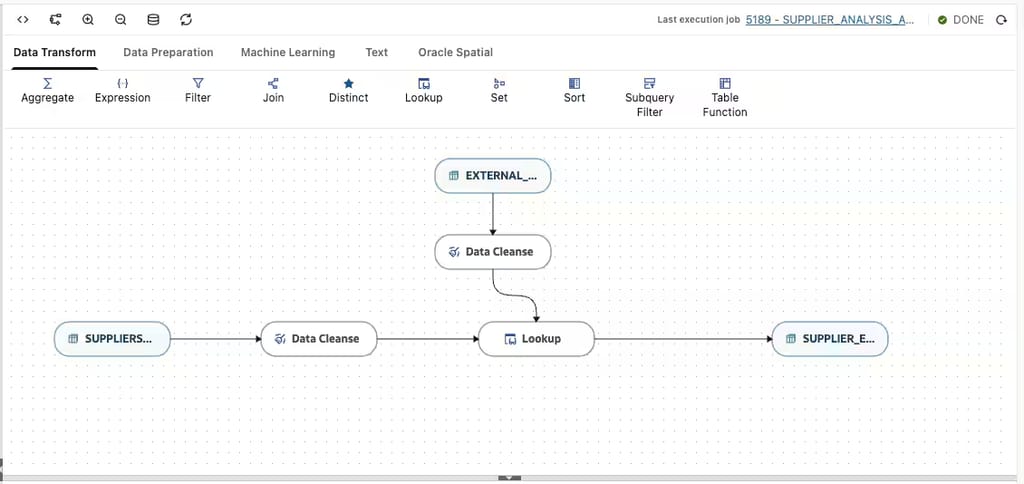
図6:Fusionと外部データを組み合わせるフロー。
5 自然言語でAI Lakehouseのデータを調べる
Data StudioでSQL Worksheetタブを開き、データフローが作成したテーブルをクエリします。最終的なSupplier Risk Scoreを作成するSQLを、次のプロンプトで生成します。
SUPPLIER_ANALYSIS.SUPPLIER_EXT1で、最もリスクの高い上位100仕入先を特定するクエリを書いてください。複数の構成スコアを使い、仕入先リスクスコア列を作ってください。
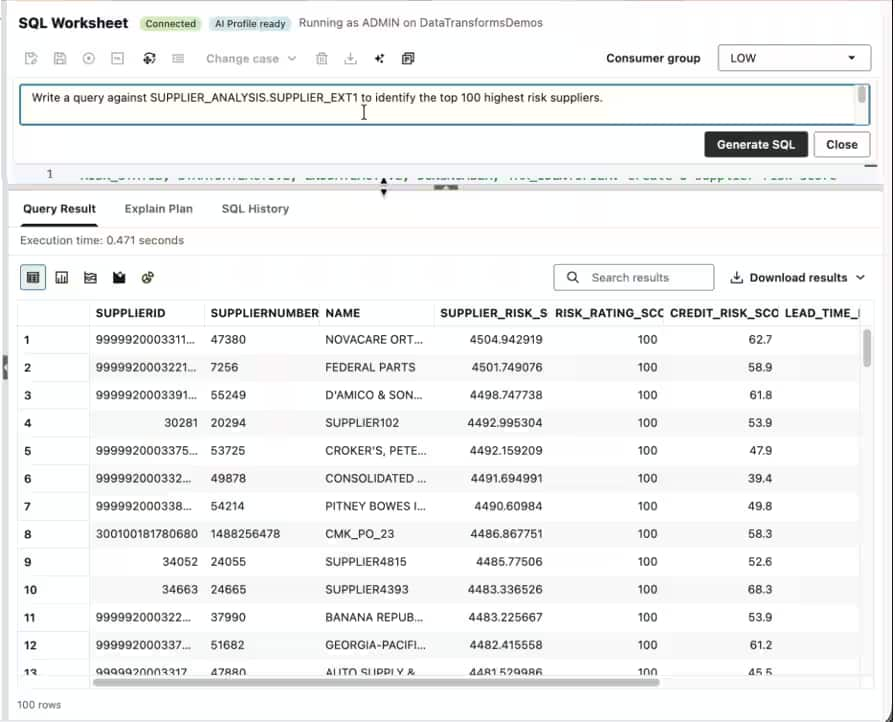
図7:リスク上位100社をData Studioで照会します。
FusionからAI Lakehouseへの構成
次の構成図は、Data Transformsの設計時と実行時の構成要素、およびFusionからAI Lakehouseへのデータの流れを示しています。
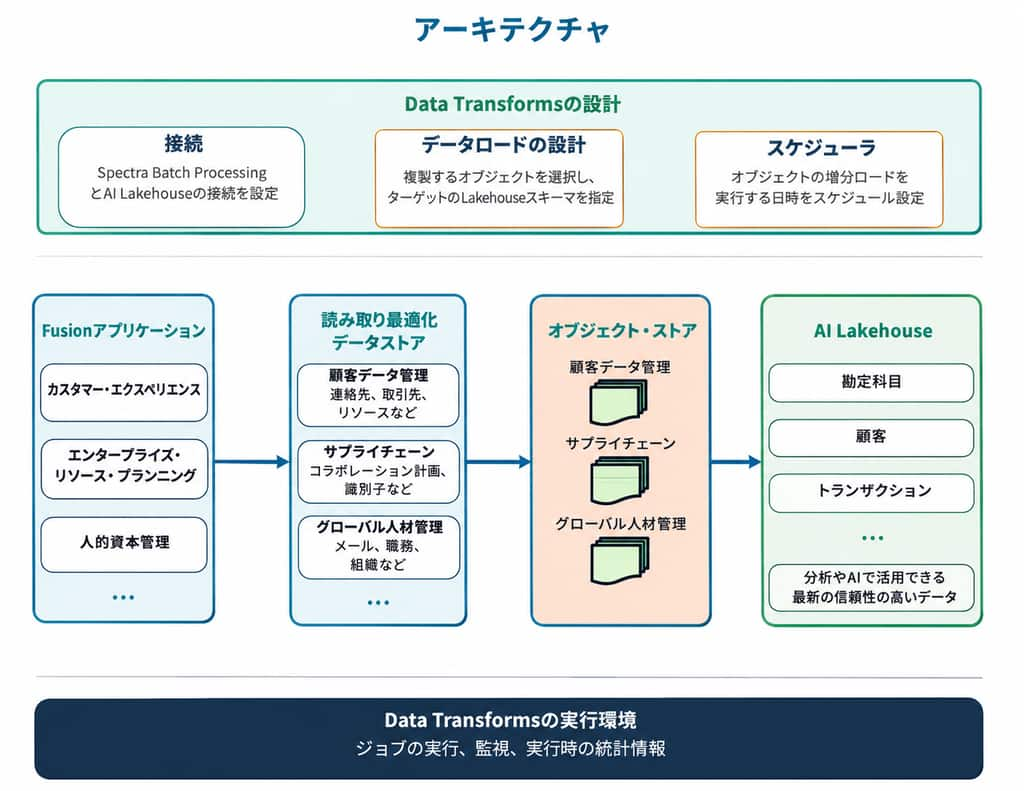
図8:Data Transformsが転送の複雑さを隠します。
Data TransformsとAI Lakehouseに加わる価値
FusionデータをAI Lakehouseへ取り込むことで、データ全体を横断する分析と報告の基盤ができます。Data Transformsが抽出、増分ロード、削除を処理、監視するため、Spectra Batch Processingコネクタは、本来複雑な操作を分かりやすい手順で行えるようにします。
この利点は、データエンジニアが作らなくてよくなる点にあります。抽出スクリプトも、増分処理や削除の手書きロジックも不要です。各工程の別々のコンソールではなく、1つのJobsパネルで監視できます。
datastudio.oracle.comでOracle Data Transformsのパイプライン作成を始めてみましょう。