※ 本記事は、Alexey Filanovskiyによる”Optimize your Iceberg tables with Autonomous AI Lakehouse with catalog federation and no data movement“を翻訳したものです。
2026年11月2日
共有オープンテーブルに、カタログフェデレーションとOracle SQLの高度な処理を提供
OracleはAI LakehouseのネイティブなApache Iceberg対応を拡張しています。共有Icebergテーブルを読み、Oracleの業務データと結合し、Oracle SQLの結果を新しいIcebergテーブルとして公開して、他のIceberg互換エンジンで利用できます。
オープン標準と顧客の選択肢を重視し、データは単一エンジンに縛られず、公開形式のままレイクに残ります。Oracle SQLを適用しつつ、他のサポート対象基盤を使う自由が保たれます。
今回の発表では、次の4つの機能強化が大きなポイントとなります。。
- シームレスなカタログ・フェデレーション: AI LakehouseをOracle AI Data Catalogまたはサポート対象の外部カタログに接続することで、各テーブルをそれぞれ毎に設定することなく、アクセス権限のあるテーブルを検出できます。
- Icebergテーブルの読み取り互換性の拡大: 対応機能の拡充により、他のエンジンで作成・管理された、より幅広いIcebergテーブルをAI Lakehouseから読み取れるようになりました。
- Icebergテーブルへのネイティブな書き込み: Icebergテーブルを作成し、Oracleデータとの結合(JOIN)を含むOracle SQLクエリの実行結果を、Icebergテーブルに直接書き込めます。
- インテリジェントなパフォーマンス最適化: IcebergテーブルがOracleのオプティマイザでネイティブに扱われるようになり、Oracleの高度なクエリ最適化機能をIcebergのワークロードにも活用できます。Icebergのメタデータを利用して不要なデータの読み取りを回避するほか、Lake Cacheを使用することで、キャッシュされたIcebergデータに対してExadataストレージからの読み取りに匹敵するパフォーマンスを実現できます。さらに、Data Lake Acceleratorにより、大規模なデータスキャンに必要なI/O処理とコンピュート・リソースを柔軟に拡張できます。
複数のエンジンで利用できる共通のオープン・テーブル形式
最新のレイクハウス環境では、単一のエンジンやクラウドだけを使用するケースはほとんどありません。例えば、Databricksでデータを準備し、Snowflakeでデータ・プロダクトを管理し、AWS Glueでデータレイクを管理しながら、AI Lakehouseで分析を実行するといった構成が考えられます。Icebergを利用することで、対応する複数のエンジンが同じテーブルを共有できるため、エンジンごとにデータを個別にエクスポートする必要がなくなります。
データファイルはオブジェクト・ストレージにそのまま保持されます。Icebergのメタデータには、テーブルのスキーマ、データファイル、スナップショットなどの情報が記録され、カタログではテーブル名とメタデータの保存場所が管理されます。AI Lakehouseは、これらの情報を利用することで、データをOracleのテーブルに取り込むことなく、Icebergテーブルに対して直接クエリを実行できます。
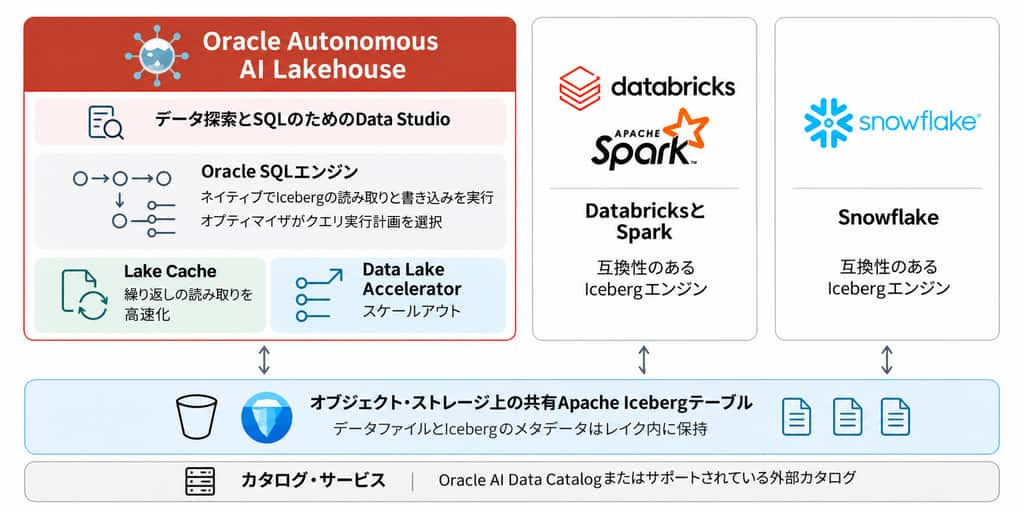
AI Lakehouseは共有Icebergデータの読み手にも書き手にもなります。機能は各エンジンと設定に依存します。
カタログに一度接続するだけで、テーブルを簡単に検出
Icebergテーブルは、特定のクエリエンジンだけで利用するものではありません。ユーザーは、Oracle AI Data Catalogまたはサポート対象の外部カタログを使用して、複数のエンジンで共有するテーブルを管理できます。Data Studioは、これらのデータを検索・検出し、操作するためのビジュアルな作業環境を提供します。一方、AI Lakehouseは、Oracle SQLを使用したデータの読み取りや結合(JOIN)、クエリ結果の新しいIcebergテーブルへの書き込みを可能にします。データファイルはオブジェクト・ストレージにそのまま保持されるため、データを移動することなく、他の対応エンジンからも引き続き利用できます。
読み取りに対応しているカタログ連携は、以下のとおりです。
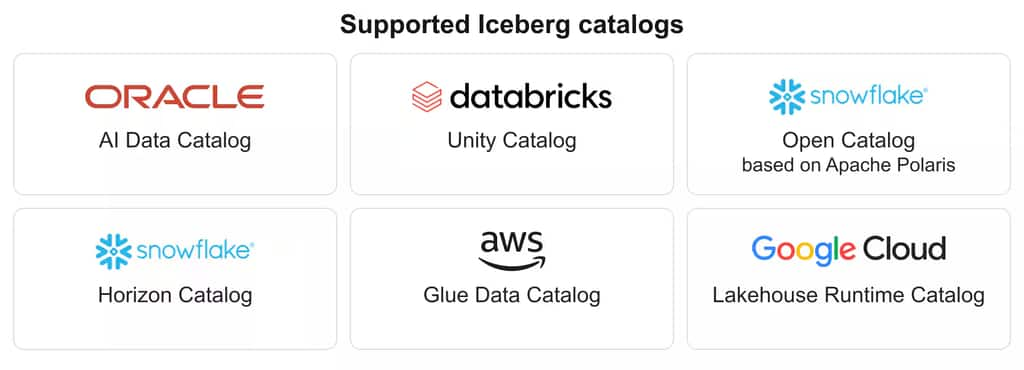
Iceberg読み取りの対応カタログ。書き込み対応は、カタログ、ストレージ、認証、リリースによって異なります。
カタログ・フェデレーションを利用することで、テーブルごとに外部テーブルを個別に定義する必要がなくなります。カタログに一度接続するだけで、複数のネームスペースにまたがる数百から数千ものテーブルのうち、アクセス権限があり、サポート対象となっているテーブルを利用できるようになります。新しいテーブルが追加された場合も、カタログをリフレッシュすることで検出できるようになります。なお、従来どおり、外部テーブルを個別に定義する方法も引き続き利用できます。
また、カタログ名を指定する「@」サフィックスを使用すると、1つのSQLクエリで、Oracle内のデータと複数の接続先カタログにあるIcebergテーブルを組み合わせて利用できます。例えば、複数のプラットフォームにデータが分散している小売企業を考えてみましょう。最新の注文データはOracle、顧客データはOracle AI Data Catalog、商品データはSnowflake Open Catalog、顧客セグメント情報はDatabricks Unity Catalogで管理されているとします。以下のSQLクエリでは、これら4つのデータソースを結合(JOIN)し、まとめて分析できます。
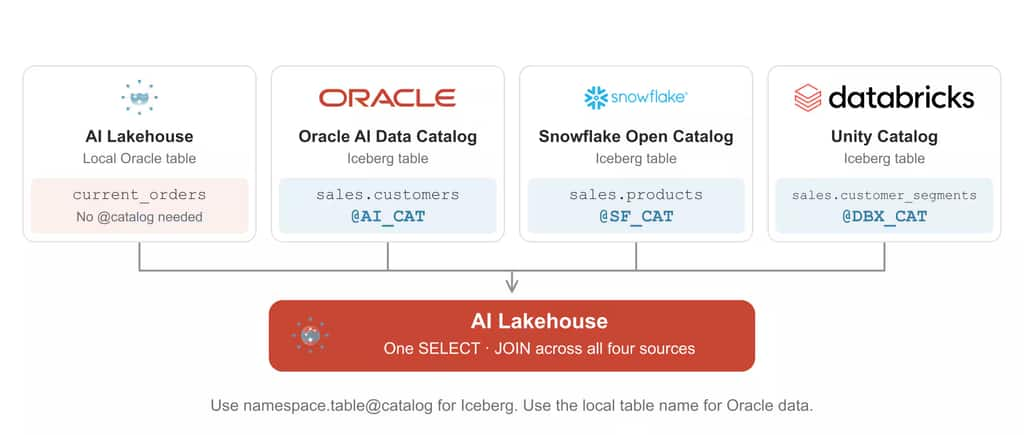
1つのSELECTで、Oracleのローカルデータと3カタログのIcebergテーブルを結合します。
SELECT o.order_id, c.customer_name,
       p.category, s.segment, o.order_total
FROM current_orders o
JOIN sales.customers@AI_CAT c
  ON c.customer_id = o.customer_id
JOIN sales.products@SF_CAT p
  ON p.product_id = o.product_id
JOIN sales.customer_segments@DBX_CAT s
  ON s.customer_id = o.customer_id;
表、列、接続名は説明用です。互換テーブルと、必要なカタログおよびストレージ権限による接続を前提とします。
Data Studioでカタログと表を参照し、SQL Worksheetでクエリできます。SQLではnamespace.table@catalogで共有テーブルを識別し、カタログとストレージの権限に従います。
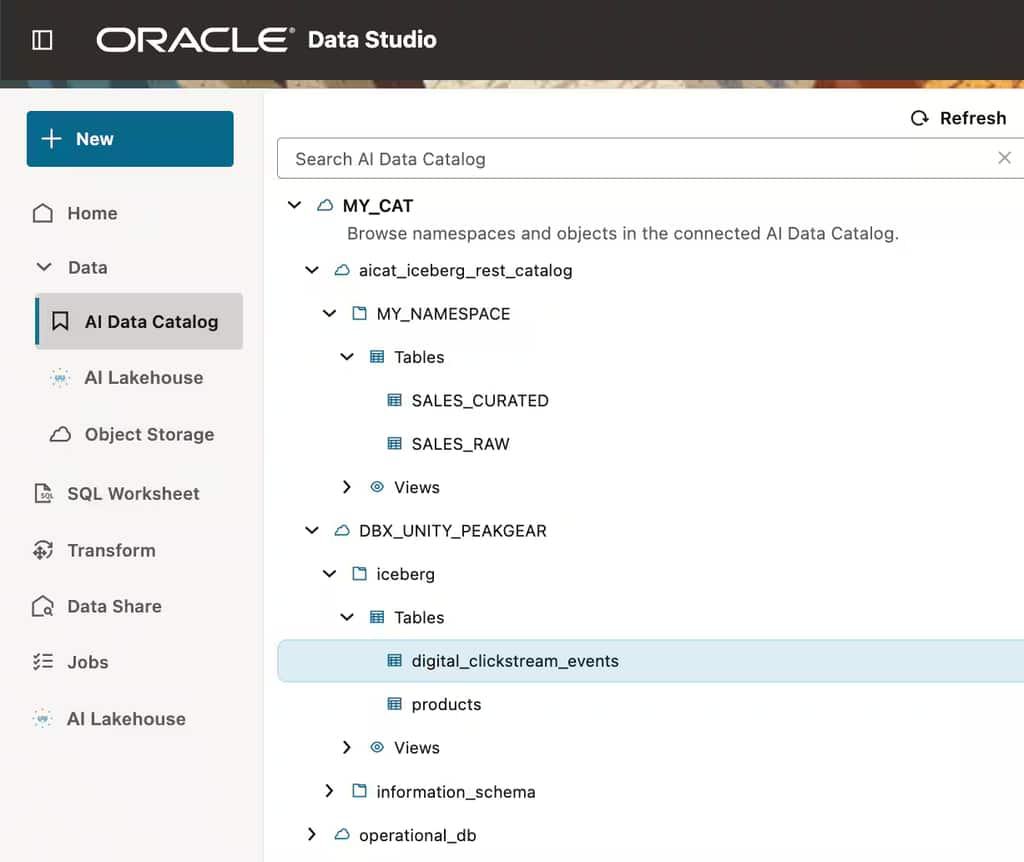
Data Studioのカタログ参照画面(AI Lakehouseのブランド表記に合わせて調整したもの)
より幅広いIcebergテーブルの読み取りに対応
AI Lakehouseでは、Icebergの対応機能を拡充し、他のエンジンで作成・管理された、より幅広いIcebergテーブルに対してクエリを実行できるようにしています。また、タイムトラベル機能を使用すると、過去のスナップショット(保存されている特定時点のデータ)を参照してクエリを実行できます。さらに、パーティション・プルーニングにより、クエリに関係のないデータの読み取りを省略できるため、処理の効率化とパフォーマンスの向上が期待できます。以下の表では、AI Lakehouseが対応する主なIcebergの機能を紹介します。
| 機能 | 利用上の意味 |
|---|---|
| タイムトラベル | 時刻やスナップショットIDで、保持された過去の状態をクエリできます。 |
| パーティションの絞り込み | Icebergメタデータで無関係なパーティションを省きます。 |
Oracleは、Apache Icebergとオープン・スタンダードへの対応に積極的に取り組んでいます。今後のリリースに向けて、Icebergのさまざまな機能の追加・拡充を進めており、仕様やエコシステムの進化に合わせて、継続的にサポート範囲を拡大していく予定です。Oracleの目標は、お客様がデータのオープン性を維持し、複数の対応エンジン間でデータを柔軟に活用できる環境を確保しながら、Icebergの新機能を取り入れられるようにすることです。
なお、Icebergテーブルの互換性は、テーブルのバージョン番号だけで決まるものではありません。テーブルで使用されている機能と、利用するリリースでの対応状況によって決まります。
Oracleの読み取り一貫性をIcebergテーブルにも提供
読み取り一貫性(Read Consistency)は、長年にわたりOracleの大きな強みの1つです。Oracle AI Lakehouseでは、この強みをIcebergテーブルにも拡張し、SQL文単位およびトランザクション単位で一貫性のあるデータの読み取りを実現します。1つのSQLクエリでは、同じ時点のテーブルのスナップショットを参照するため、一貫性のあるデータを取得できます。また、サポート対象の読み取り専用トランザクション内で複数のクエリを実行する場合も、他のエンジンがデータを更新している間、同じスナップショットを参照し続けることができます。これにより、お客様はオープンなIcebergテーブルを複数のエンジンで共有しながら、Oracleで使い慣れた読み取り一貫性の仕組みを活用し、信頼性の高いレポート作成やデータ分析を実行できます。
例えば、1つのトランザクション内で同じSQLクエリを2回実行するケースを考えてみましょう。1回目と2回目のクエリの間に、別のエンジンがIcebergテーブルを更新し、新しいスナップショットを公開したとします。
トランザクション単位の読み取り一貫性が有効な場合、Oracle AI Lakehouseは2回のクエリで同じ結果を返します。 他のエンジンが共有テーブルの更新を続けていても、両方のクエリが同じスナップショットを参照するため、一貫した分析結果を得ることができます。
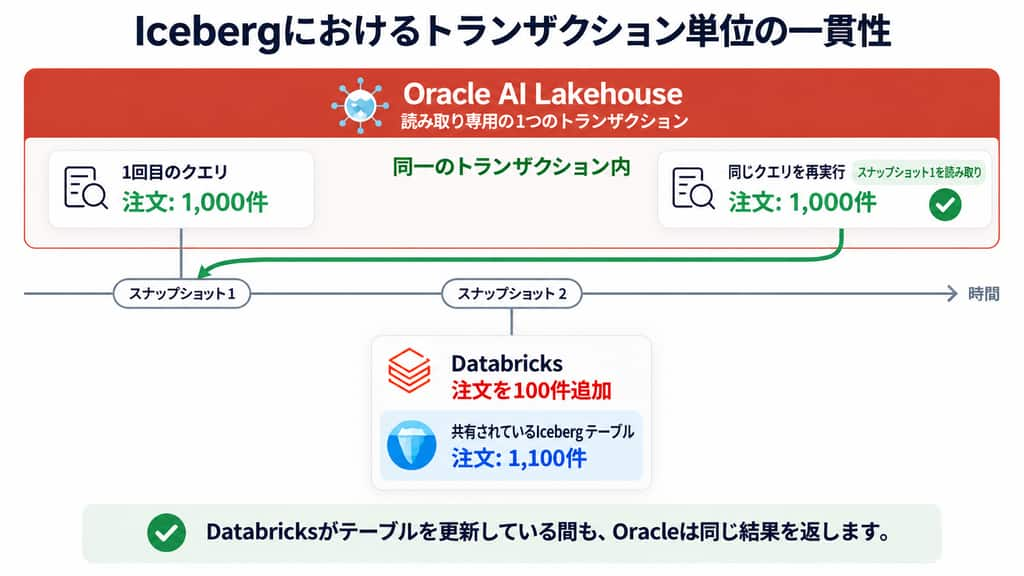
対応する読み取り専用トランザクション内では、両クエリが同じIcebergスナップショットを読みます。
Icebergテーブルを作り、Oracle SQLの結果を公開する
Oracleの現在の注文とIcebergの顧客区分を結合し、新しい共有売上Icebergテーブルに公開できます。
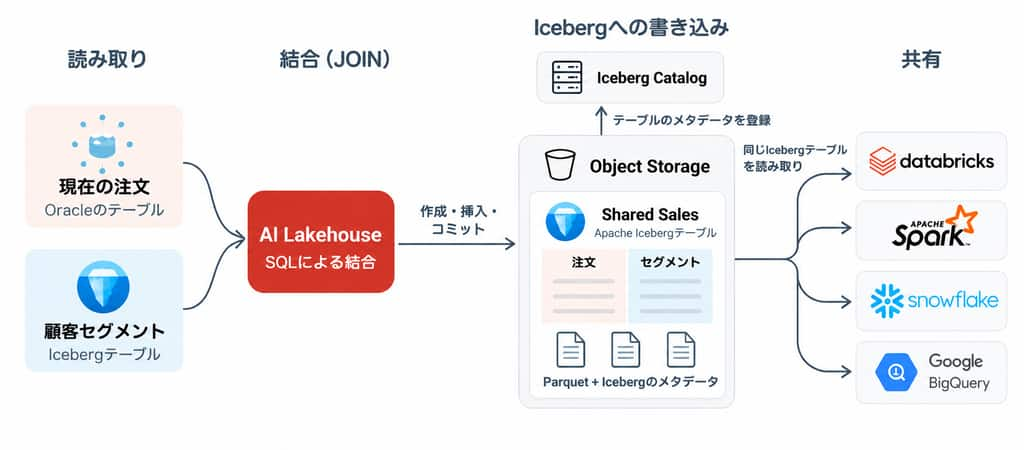
Oracleの注文とIcebergの顧客区分を結合し、互換エンジン向けのShared Salesテーブルを公開します。
まずsales.shared_salesを作ります。ソース表とsales名前空間が既存で、LAKEHOUSE_CATALOGに必要なカタログとストレージの書き込み権限がある前提です。<bucket>は設定したS3互換ストレージに置き換えます。
CREATE ICEBERG TABLE sales.shared_sales (
  order_id INT,
  customer_id INT,
  segment STRING,
  order_total DECIMAL(12, 2)
)
WITHIN CATALOG LAKEHOUSE_CATALOG
STORAGE LOCATION 's3://<bucket>/sales/shared_sales/';
次にcurrent_ordersとsales.customer_segmentsの結合結果を挿入します。選択列は出力先スキーマと一致させます。
INSERT INTO sales.shared_sales@LAKEHOUSE_CATALOG
SELECT o.order_id, o.customer_id, c.segment, o.order_total
FROM current_orders o
JOIN sales.customer_segments@LAKEHOUSE_CATALOG c
  ON c.customer_id = o.customer_id;
COMMIT;
AI Lakehouseは、ParquetファイルとIcebergメタデータをオブジェクトストレージへ書き込みます。COMMITは、新しいスナップショットをカタログ経由で公開し、互換性のあるエンジンからクエリできるようにします。AI Lakehouse自身も、メタデータを更新して、他のエンジンによる互換性のある変更を読み取れます。
Icebergの性能を高度化する
メタデータを活用する読み取り、Oracleの計画作成、キャッシュ、分散処理を組み合わせ、不要な読み取りを省き、残りを効率化します。
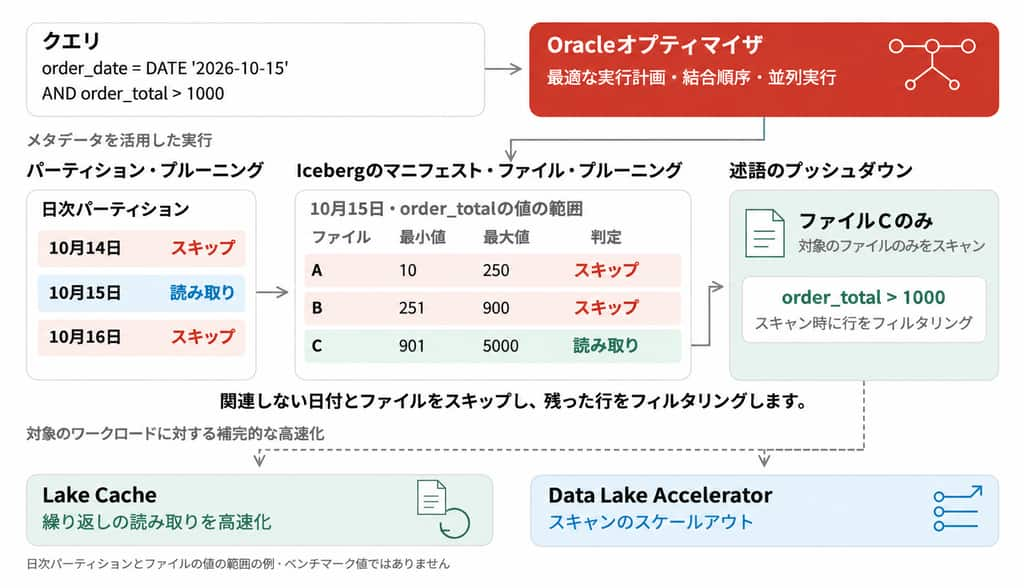
これは仕組みを説明するための例であり、ベンチマーク結果ではありません。パーティション・プルーニングとマニフェスト・プルーニングによって不要なデータの読み取りを回避します。さらに、Oracleオプティマイザ、Lake Cache、Data Lake Acceleratorがそれぞれ異なる役割を担い、さまざまなパフォーマンス要件に対応します。
- メタデータを活用したプルーニングと述語のプッシュダウンにより、不要なデータ処理を削減: Icebergのパーティション・メタデータを利用して、クエリの検索条件に一致しないパーティションを読み取り対象から除外します。また、Icebergのマニフェストに保存されているファイルごとの最小値・最大値の統計情報を評価し、不要なデータファイルを読み取る前に除外します。さらに、述語のプッシュダウンによって、残りの検索条件をデータのスキャン時に適用します。カタログやメタデータのキャッシュも活用することで、リモート環境への繰り返しのアクセスを減らし、処理を効率化します。
- Oracleオプティマイザによる高度な最適化の対象に: Oracleが長年培ってきた高度なクエリ最適化技術を活用できます。これには、効率的な結合(JOIN)順序の決定、検索条件の適切な適用、並列実行などが含まれます。オプティマイザは、Icebergのメタデータや統計情報を利用して、効率的な実行計画を選択します。Icebergテーブルだけを参照するクエリはもちろん、Oracleのテーブルと組み合わせるクエリも最適化できます。
- Lake CacheによるExadata並みの性能を実現: 頻繁にアクセスするIcebergデータをExadataストレージにキャッシュすることで、オブジェクト・ストレージから繰り返しデータを読み取る必要がなくなります。高速なローカルアクセスにより、ネットワーク遅延の影響を抑え、定期的に実行するダッシュボード、レポート、データ分析などの処理を高速化できます。元のIcebergテーブルは引き続きデータレイク内に保持されるため、他の対応エンジンからも共有して利用できます。
- Data Lake AcceleratorによるI/O処理とコンピュート・リソースの拡張: 対象となるIcebergデータのスキャン処理に対して、Oracleが管理するリソースを追加し、オブジェクト・ストレージ上のファイルを並列に読み取り・処理します。I/O帯域幅、コンピュート・リソース、ネットワーク容量を必要に応じて柔軟に拡張できるため、お客様が別途処理エンジンを構築・管理することなく、大規模なデータスキャンに対応できます。
- クラスタリングとコンパクションによるIcebergデータの配置最適化: 他のエンジンが書き込んだデータも含め、共有Icebergテーブルを効率的に管理できるよう、クラスタリングとコンパクションの機能追加を進めています。データを効率的に配置することは、クエリのパフォーマンス向上において重要です。クラスタリングは、値が近いデータをまとめて配置することで、マニフェストに記録された最小値・最大値の統計情報を活用しやすくし、不要なファイルの読み取りを削減します。一方、コンパクションは、小さなParquetファイルをより大きなファイルにまとめることで、ファイルを開く際の処理負荷を減らし、データスキャンの効率を向上させます。
業務データとオープンなレイクハウスのデータを統合
お客様にとっての大きなメリットは、売上予測、ダッシュボード、AIアプリケーション向けのデータ準備など、さまざまな用途で活用できる共通の売上データを整備できることです。さらに、AI Lakehouseでは、Oracleで管理されている最新の顧客データや在庫データと、Icebergを通じて公開されている過去の履歴データ、顧客の行動データ、パートナー企業のデータなどを組み合わせて分析できます。これにより、データが異なるシステムやプラットフォームに分散していても、それらを組み合わせて活用し、より幅広い分析やAIアプリケーションに役立てることができます。
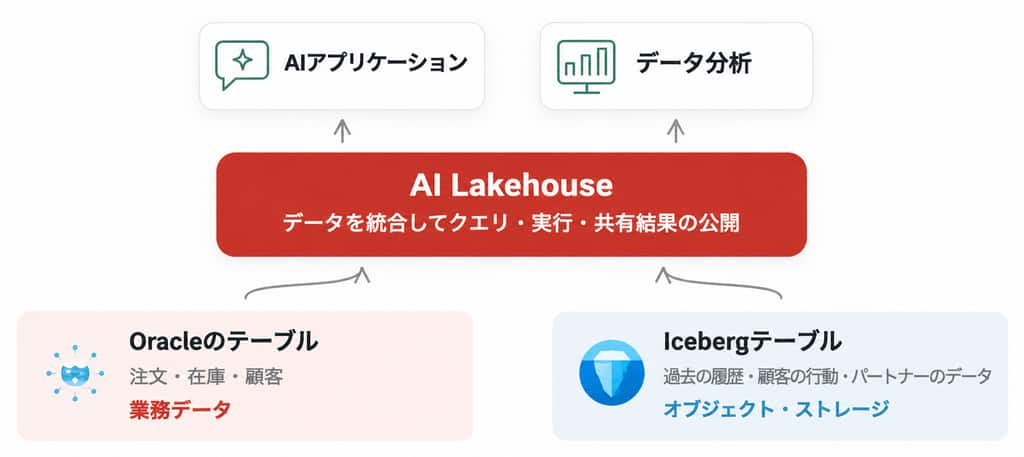
両テーブルはそれぞれのストレージに残ります。AI Lakehouseで一緒にクエリし、派生結果を再利用用に公開できます。
アプリケーションは、複数のソースを一緒にクエリできます。共通のデータセットが必要な場合は、公開済みのIceberg結果を再利用することもできます。結果は、新しい派生テーブルを作成し公開され、どちらかのソースデータセットを移動するものではありません。
OracleテーブルとIcebergテーブルは、異なる要件を補完します。Oracleテーブルは、トランザクションワークロード、強制される関係制約、一貫して低遅延なアクセスに適しています。Icebergは、オブジェクトストレージに残して、複数のエンジンで共有する分析データに適しています。
ワークロードに適した保存モデルを選び、両方にOracle SQLを使えます。
共有Icebergデータプロダクトの利用を始める
まず、サポート対象のカタログに接続し、必要なストレージへのアクセス権限を設定します。Data Studioでは、アクセス権限のあるIcebergテーブルを参照し、Oracleのデータと組み合わせてクエリを実行できます。また、クエリの実行結果を他のエンジンと共有する場合は、前述のCREATE、INSERT、COMMITの手順に従って、共有Icebergテーブルにデータを書き込むことができます。
サポート対象の構成を確認し、実際に操作を試すには、以下のリソースをご活用ください。