
※ 本記事は、Juan Loaiza、Maria Colganによる”Announcing: Oracle Deep Trust AI architecture“を翻訳したものです。
2026年10月27日
企業では、質問への回答、知見の生成、アプリケーション開発、そして人に代わる操作の実行に、AIを急速に取り入れています。
生産性やイノベーションを大きく高められる可能性があります。ただし、企業がAIの結果を信頼できることが前提です。
AIが事実にないことを答えたり、指示を誤解したり、セキュリティ上の欠陥があるアプリケーションを作ったり、開示すべきでないデータにアクセスしたりすると、どうなるでしょうか。企業システムでは、こうした間違いが重大な結果を招くことがあります。
AIの信頼性を高めるには、モデルの性能や安全上の制約を強化するだけでは不十分です。AIがもたらす新しいリスクを想定していない構成に、単にAIを追加するわけにはいきません。AI、データ、アプリケーション開発を、最初から連携するように設計する必要があります。
これが、Oracle Deep Trust AI Architectureの考え方です。データとアプリケーション開発の層の深い部分に信頼性の仕組みを組み込み、どのAIモデル、アプリケーション、エージェントを使っても、一貫して適用できるようにします。
リスクを抑えながらAIの活用を速める、Deep Trust AI Architecture
AIで生産性とイノベーションを高め、リスクを減らすための、実践的な設計指針です。ソフトウェア基盤、データ、データアクセス、アプリケーション開発という、4つの重要な層に信頼性を組み込みます。層ごとに異なるリスクへ対応し、全体として、信頼できるAIの一貫した基盤を作ります。
考え方は、広く使われているMaximum Availability Architecture (MAA)と似ています。MAAでは、障害が起きても稼働を続けるシステムを設計する、実績ある指針を提供します。Deep Trust AI Architectureでも同様に、後付けではなく、最初から信頼性を構成に組み込みます。各アプリケーションの内部に埋め込むのではなく、その基盤で適用するため、既存のアプリケーションも、これから作るものも保護できます。
各層を、詳しく見ていきます。
ソフトウェア基盤:AIを使うサイバー攻撃に先回りする
攻撃側も防御側も、AIによってサイバーセキュリティへの取り組み方が変わっています。
以前は、企業向けソフトウェアの脆弱性を発見して悪用するには、多くの労力と専門知識が必要でした。AIによって、その障壁が下がっています。技術力が限られる攻撃者でも、新たな脆弱性の発見や公開済みの弱点の悪用をAIに支援させ、格段に速く攻撃できます。その結果、甚大な被害を受ける可能性があります。
先回りするには、まず最新の脅威に対するパッチを、基盤に適用し続ける必要があります。理想は、脆弱性が公開される前に、自動で行うことです。
Oracle Autonomous AI Database (ADB)では、それを実現します。データベースエンジン、OS、Exadataストレージ、ファームウェアを含む、ソフトウェアとハードウェアの全体に、最新のセキュリティ更新を自動適用します。ローリングパッチにより、アプリケーションの処理を動かしたまま、基盤を部分ごとに更新します。
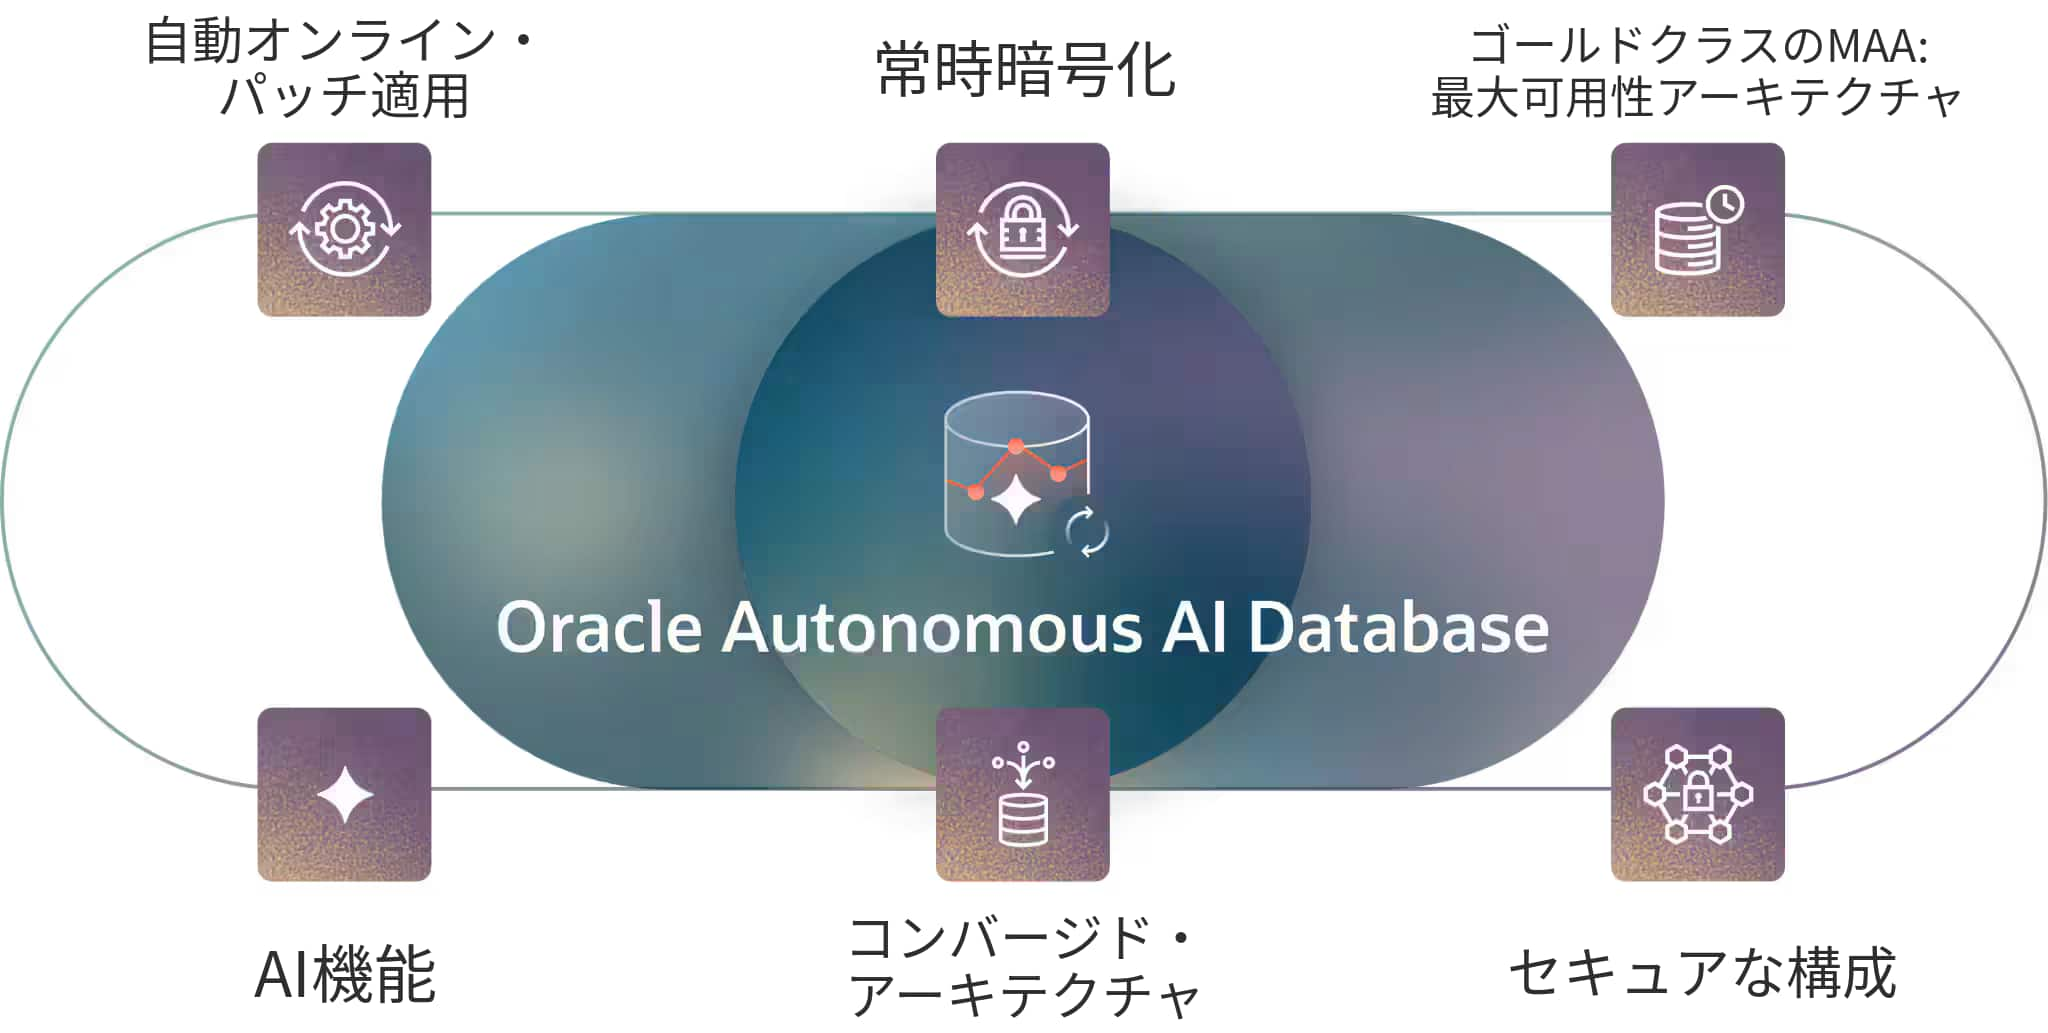
Autonomous AI Databaseでは、常時有効な暗号化で、保存中と通信中のデータを保護します。コンバージドな構成により、あらゆるデータや処理の種類に適しています。
データの信頼性:保存先でセキュリティと業務ルールを適用する
AI時代には、データのプライバシーが一層重要です。機密情報が漏れると、金銭、法的責任、評判の面で、深刻な結果を招く可能性があります。そのため、AIで生成したアプリケーションでも、組織のセキュリティとプライバシーの方針を、常に正しく適用する必要があります。
しかし、それは簡単ではありません。
アクセスルールは複雑で、ユーザーごとに細かく異なる場合があります。たとえば、管理職は部下の人事評価や報酬を見られても、医療給付や社会保障番号は見られない、といった条件です。
AI時代にデータのプライバシーを守る
現在、多くのアクセスルールやプライバシールールは、アプリケーション内の独自コードで実装しています。ここに新たなリスクがあります。組織の方針を守るようAIに指示しても、生成した何千行ものコードで、すべてのルールを完璧に実装したとは限りません。ルールが抜ける、ある画面だけに適用する、特定のユーザーに誤って適用する、といった可能性があります。
さらに大きな課題もあります。アプリケーション内の制御でデータを守れるのは、そのアプリケーションを経由する場合だけです。AIエージェントは、MCPサーバーや自然言語からSQLへの変換などを使い、データへ直接アクセスするようになっています。アプリケーションを通らずデータベースへ要求すると、アプリケーション層だけで実装したプライバシールールも迂回できてしまいます。
このため、アプリケーションやエージェントが迂回できない、データ層そのものでセキュリティを適用する必要があります。
Oracle Deep Data Securityでは、エンドユーザーのデータアクセスルールを、Oracle AI Database内に直接定義できます。どのアプリケーションやエージェントが要求しても、データベース側で、そのルールを適用します。企業のディレクトリが発行する暗号署名付きトークンからユーザーのIDを検証し、利用可能なデータを判断します。
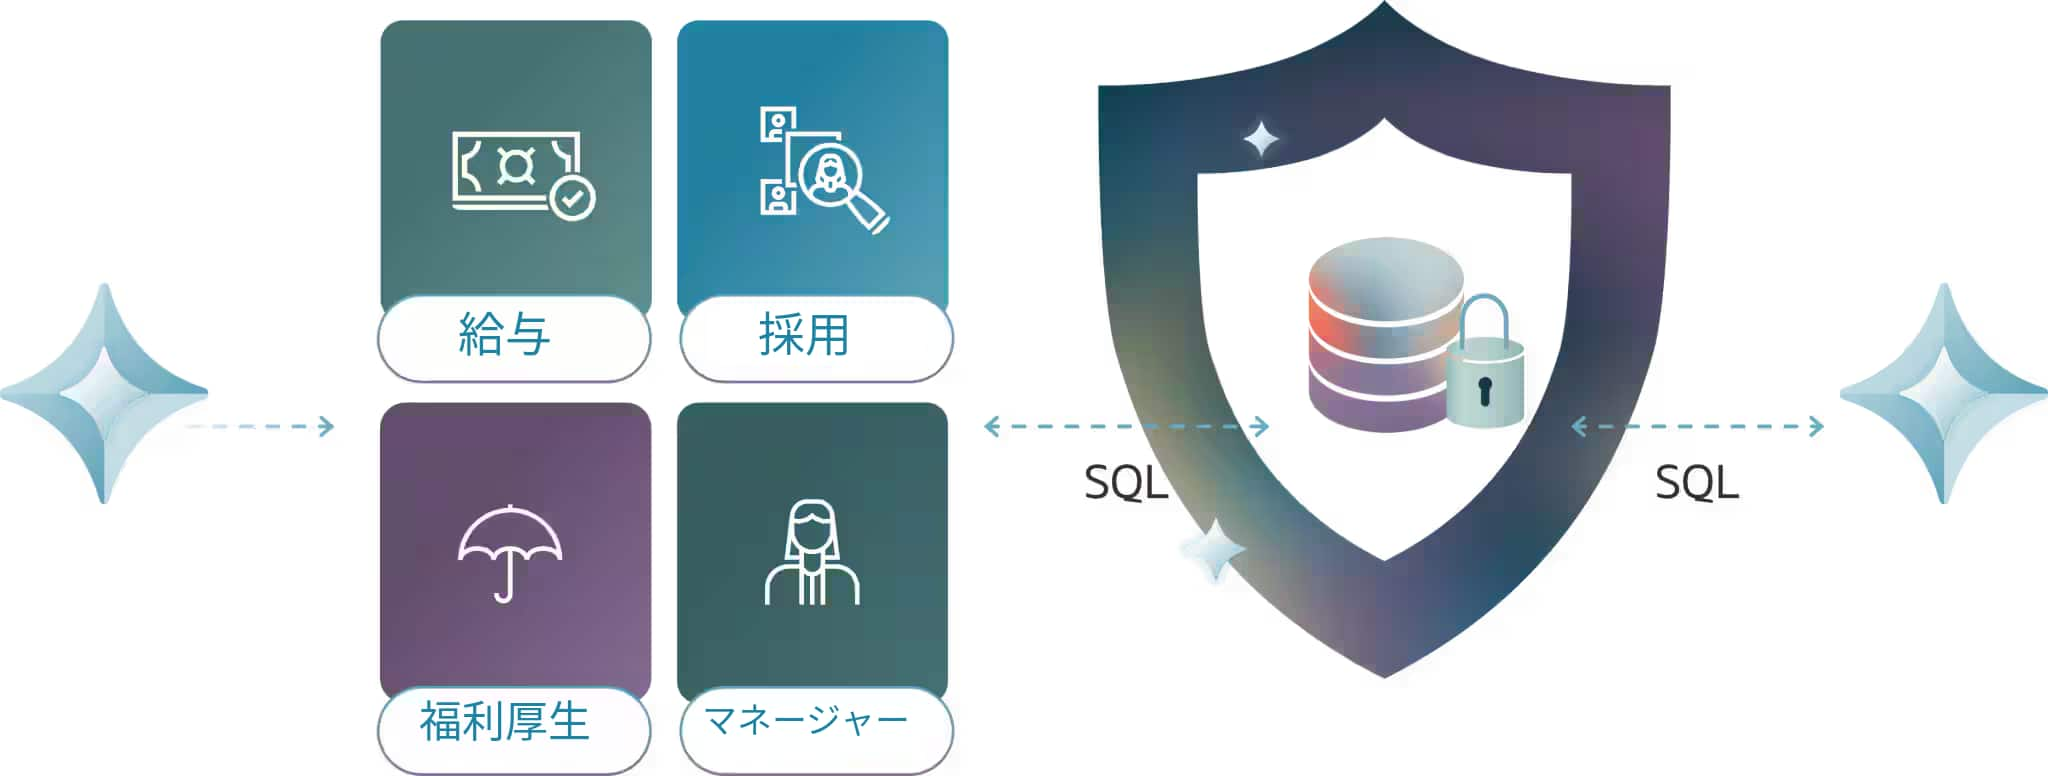
プライバシーだけでなく、AIエージェントやAI生成アプリケーションに、データの業務ルールを破らせないことも重要です。
Oracle SQL Assertionsで、ルールをデータベース内で直接適用し、誤った操作や矛盾するデータの記録を防げます。
たとえば、多くの組織では、従業員の支出限度額を定めています。SQL Assertionでその上限を直接適用し、アプリケーションやAIエージェントが許可額を超える経費を計上しようとしたら、データベースで拒否できます。
CREATE ASSERTION prevent_excess_charges

CHECK (
 NOT EXISTS (

 SELECT 1
 FROM expenses exp, expense_limits lim

 WHERE exp.employee_title = lim.employee_title
 AND exp.expense_value > lim.expense_limit ));
これらは、Deep Trust AI Architectureの基本原則の例です。重要なセキュリティ、プライバシー、業務ルールをデータ層に置き、どのアプリケーション、モデル、エージェントがアクセスしても、一貫して適用します。
これらを含むOracle AI Databaseのセキュリティ機能で、AI時代のデータを保護できます。
データアクセス:AIに企業データをどう扱わせるかを制御する
AI生成アプリケーションとAIエージェントのアクセス
AI時代のもう1つの大きな課題は、アプリケーションやエージェントの企業データへのアクセス方法を制御することです。基幹システムで任意のSQLを使わせると、大きなリスクになり得ます。タスクに必要な量以上のデータを要求する、定めた業務フローを迂回する、想定外の変更をする、といった可能性があります。悪意ある者にエージェントが操られると、危険はさらに増します。
Oracle Trusted Data APIでは、より安全な方法を提供します。無制限のSQLアクセスではなく、発注書全体のような、論理的な業務オブジェクトを対象に、管理された読み書きを公開します。
こうした上位の業務オブジェクトについて、データベース側で更新ルールと整合性を守り、将来の変更にも対応します。
必要な業務オブジェクトへのアクセスを与え、元のテーブルへの無制限のSQLアクセスは与えない、という原則です。
AIの回答の正確さを高める
アプリケーションのデータアクセスにはTrusted Data APIsが適しています。一方、業務利用者にとっては、自然言語からSQLへの変換 (NL2SQL)という、新しい利用方法が広がります。SQLやデータ構造を理解しなくても、自然言語で直接質問し、回答を得られます。
ただし、自然言語には本質的に曖昧さがあり、表現も限定されません。AIが、常に正しく解釈するとは限りません。質問や業務上の背景を誤解すると、間違った回答を返す可能性があります。
誤解や間違いを減らすには、AIに、業務とデータの両方を理解させる必要があります。
Oracle Deep NL2SQLでは、組織の業務知識をトピックとサブトピックに整理し、質問を正しく解釈するための情報をAIに渡します。各トピックで業務分野を説明し、関連する用語やルールを定め、その分野の質問に答えるためのデータを特定します。
しかし、使うべきデータが分かるだけでは不十分です。
その意味、構造、使い方も理解する必要があります。これが、データに関する知識です。スキーマだけでは読み取りにくい場合が多いため、Deep NL2SQLでは、幅広いメタデータから必要な背景を補います。SQL Annotationsで、表、列、ビュー、プロシージャの意味や目的を説明します。Analytic Viewsでは、ディメンション、ファクト、メジャー、業務指標を記述します。コメント、制約、ビュー、オントロジー、データのドキュメントからも補足できます。
質問を受けると、業務知識とデータ知識の両方を使い、問いを明確にし、必要なデータを特定して、適切なSQLを生成します。
それでも、情報を詳しく渡しただけで、間違いをなくせるわけではありません。
Deep NL2SQLでは、Continuous Feedback Learning(継続的なフィードバック学習)とKnowledge Change Verification(ナレッジ変更の検証)という、2つの独自機能で対応します。
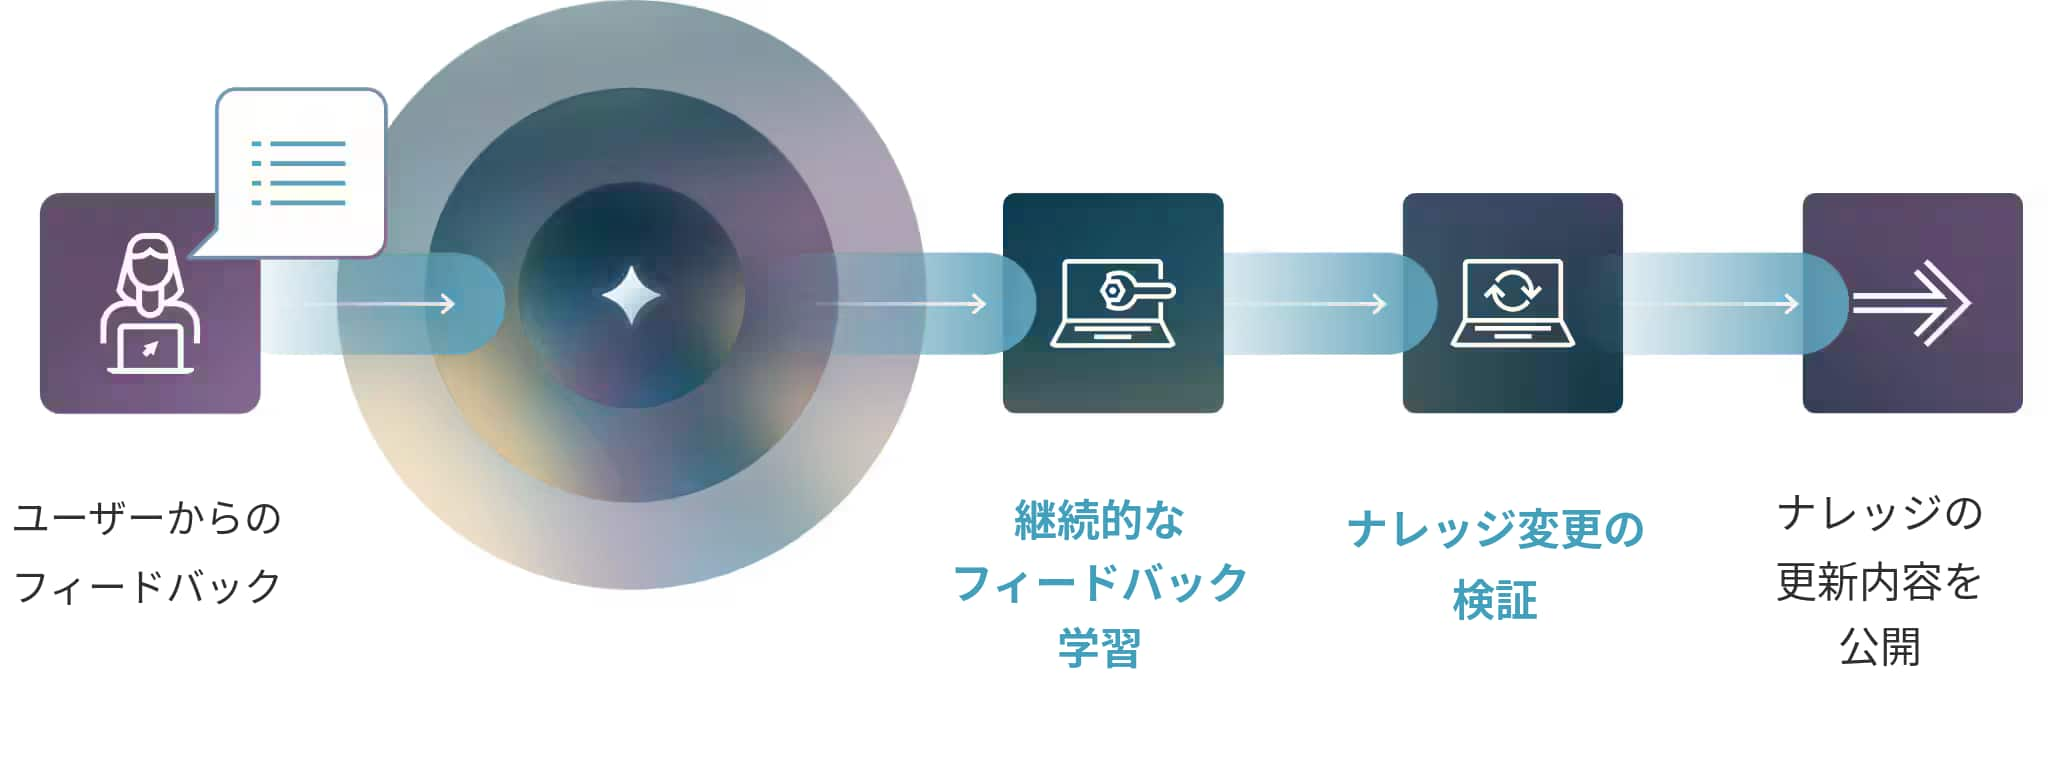
継続的なフィードバック学習では、利用者が誤答を指摘し、修正案を提示できます。知識の専門家が専用のAIエージェントの支援を受け、原因を調べて、関連する業務知識やデータ知識を更新します。
ただし、1つの回答を直す変更が、ほかの回答に悪影響を与えることがあります。ナレッジ変更の検証では、知識の変更を公開する前に、検証済みの「ゴールド回答」を再検証します。間違いから学び、知識を修正し、本番へ反映する前に変更を確かめる、管理された改善サイクルを作ります。
アプリケーション開発:実装の仕組みではなく、機能をAIに作らせる
最後の層は、信頼できるアプリケーション開発です。
企業向けアプリケーションの作り方は多様であり、ここまで説明した基盤、データ、データアクセスの層は、どの方法も支えられます。ここではローコード開発に絞り、理解しやすいよう、たとえを使って説明します。
アプリケーションは、データベースのファイルを直接読み書きしません。SQLで使いたいデータを指定し、SQLエンジンで実行します。同時実行、セキュリティ、可用性、拡張性、将来の変更への対応は、企業で実績を重ね、堅牢化した何百万行ものデータベースコードに実装されています。新しいクエリを生成するたびに、これらの基盤をAIで作り直すのは、合理的ではありません。
Oracle APEX AI App Generatorでは、AI生成アプリケーションにも同じ考え方を適用します。何千行もの独自コードではなく、利用者が自然言語で記述したアプリケーションの説明を、オープンで宣言的な言語のAPEXlangへ変換します。
APEXエンジンでその定義を実行し、企業利用に必要なセキュリティ、拡張性、可用性、変更への対応を提供します。
重要なのは、この役割分担です。APEXlangには何を行うアプリケーションかを記述し、実現するための信頼できる基盤は、APEXエンジンで提供します。AIには機能を生成させ、企業利用に必要な信頼性は、実績あるエンジンで支えるため、より単純で信頼性の高い方法になります。VS Code、Codex、Oracle APEX、AIエージェントからの直接操作など、普段の開発環境で利用できます。
主なポイント
AIでアプリケーションを作ったり、データにアクセスしたりするたびに、企業利用に必要な信頼性の仕組みを実装し直すべきではありません。構成そのものに、最初から組み込むべきです。
そうすることで、リスクを抑えながら、AIの活用を速め、安心して新しい取り組みを進め、生産性の向上につなげられます。
まず、「自分の組織では、AIで生成したソリューションを全面的に信頼できるだろうか」と問いかけてみてください。
まだそうでなければ、今から行動を始めてください。Oracleを動かす場所なら、主要なハイパースケーラーでもオンプレミスでも、Oracle Deep Trust AI Architectureを利用できます。