※ 本記事は、Tirthankar Lahiri, Shasank Chavanによる”Oracle Deep NL2SQL: Knowledge-Driven, Feedback-Improved SQL“を翻訳したものです。
2026年11月4日
自然言語からSQLへの変換は、ユーザーがデータと直接会話できるようにする強力なAI機能です。開発者のアプリケーション構築や、業務ユーザーの洞察の発見、予測の生成、より良い意思決定を支援します。現在の基盤モデルは、適切な文脈があれば、自然言語をSQLに非常にうまく変換します。
問題は、その文脈です。実際の企業のスキーマは、LLMはもちろん、人間にも分かりやすく設計されていることがほとんどありません。規模が大きく複雑で、分かりにくい名前や内部の慣習が多く、データが実際に意味することを捉えるための文脈が不足しがちです。最良のモデルでも推測を余儀なくされ、スキーマを知るアプリケーションの専門家だけが、信頼できる正しいSQLを作成できます。
そのため、現在のスキーマ依存のNL2SQLソリューションは、実環境で一貫して高い精度を出すことに苦労しています。回答が重要な経営判断を左右するなら、「時々正しい」だけでは、事業を託せません。スキーマの文脈不足以外にも、既存のNL2SQLには次の問題があります。
- 言語の曖昧さへの対応が不十分です。人の言語は混沌としています。
- エンドユーザーの用語や専門用語、アプリケーションの指標、業務ルールに関する詳細な知識がありません。ほとんどのモデルは、それらを知りません。
- 人のフィードバックを結果の改善に生かしていません。NL2SQLシステムは、ユーザーの意図、何が間違ったか、より良い回答はどのようなものかを、ユーザーから学ぶ必要があります。
eコマースアプリケーションに対する「カリフォルニアで売れ行きが上位の、レベル2の商品カテゴリは何ですか」という一見単純な質問でも、標準的なNL2SQLで実行すると、これらの限界がすべて表面化することがあります。
- 曖昧さ: 「上位」は何件か、「売れ行き」は販売個数、受注、利益、売上のどれか、期間は年初来、前四半期、前年のどれかなど、多様な定義があります。
- 専門用語: 「レベル2の商品カテゴリ」は一般用語ではなく、アプリケーション固有の用語です。
- 指標: 利益や売上などの指標は、アプリケーションのドキュメントにだけ定義され、スキーマ内では適切に定義されていない場合があります。
- ルール: たとえば販売済みと認める条件が、返品されておらず返金可能期間も過ぎていることだとしても、その知識がスキーマにない場合があります。
- フィードバック: 1回きりの不十分な応答では、システムが失敗から学び、将来繰り返さないようにする機会がありません。
Oracle Deep NL2SQLの紹介
従来型のNL2SQLとは異なり、OracleのDeep NL2SQLエージェントは、統合された知識エンジニアリングのワークベンチとフィードバック駆動のワークフローでこれらの限界に対応し、実際の企業アプリケーションに信頼できるNL2SQLを提供します。
主な特長は次のとおりです。
- 知識エンジニアリングのワークベンチで構築するビジネスナレッジグラフが、正確なSQL生成に必要な追加の文脈でスキーマを拡張します。
- フィードバック駆動のワークフローが、言語の曖昧さの解消と知識の反復的な改善を支え、時間とともにエージェントの精度を高めます。
- 検証済みの自然言語からSQLへの変換を含む組込みの回帰テストにより、知識を変更してもシステムの精度が低下しないようにします。
本記事ではOracle Deep NL2SQLエージェントを詳しく紹介し、知識ベースと代表的な「ゴールド」SQL文の集合を用意するために必要な事前作業を行えば、データとの会話で100%に近い精度を実現できるようになったことを説明します。
Deep NL2SQLの仕組み
Deep NL2SQLの出発点は、信頼できる回答には、構文的に正しいSQL以上のものが必要だという単純な前提です。問合せの生成前に、曖昧な用語を明確にし、適切な業務定義やデータ間の関係を見つけ、検証済みの知識を参照して、ユーザーの質問の真意を理解しようとします。そのため、最初の手順はビジネスナレッジグラフの構築です。
ビジネスナレッジグラフ
ビジネスナレッジグラフは、想定する質問や質問カテゴリに答えるために必要な情報に対応する「トピック」に、企業の知識を整理します。たとえば一般的なデータウェアハウスのワークロードでは、製品売上、顧客注文、製品レビュー、在庫などの情報がトピックになります。「前四半期の売上合計はいくらか」は製品売上に、「2025年に評価が最も悪かった商品を5つ挙げて」(2026年?)は製品レビューに振り分けられます。
トピックは階層構造にもできます。ルートの知識トピックに、多数の業務領域の子トピックに共通する企業知識を持たせ、各子トピックの下にさらに詳細なトピックを設けられます。子トピックは親トピックの知識を継承します。
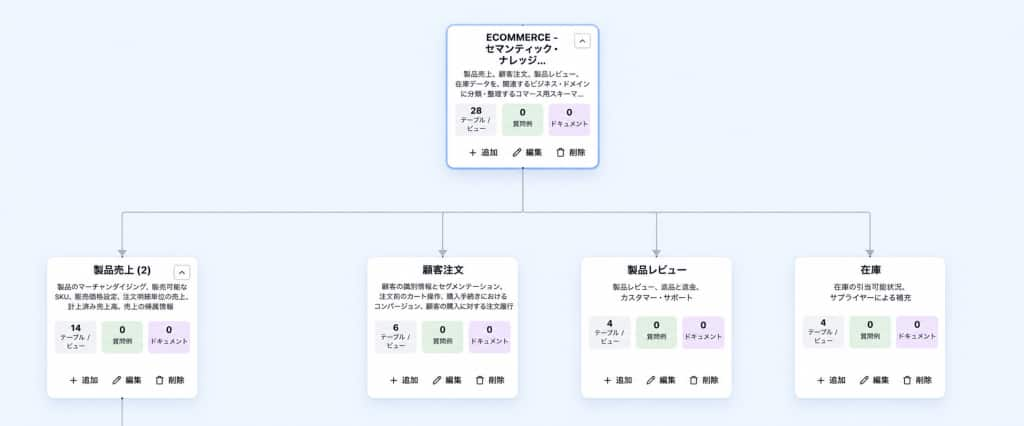
各知識トピックには、その範囲の質問を解釈し、回答するための情報を含めます。内容の例は次のとおりです。
- 関連するデータベースのスキーマ、表、ビュー、列、関係
- 表、列、値、想定する利用方法を説明する注釈やコメント
- 業務用語集と指標の定義
- 対応するSQL文を含む、または含まない自然言語の質問例
- 組織に蓄積された知識やアプリケーション固有の知識を含む文書
たとえば、製品売上(PRODUCT SALES)の知識トピックには次のものを含められます。
- 製品(PRODUCT)表と 注文(ORDER)表
- 「戦略」のような概念や「利益」のような指標の業務上の定義
- 売上計算時に返品商品を除外する指示
- 「最も利益率の高い商品は何か」など、このトピックに該当する質問例
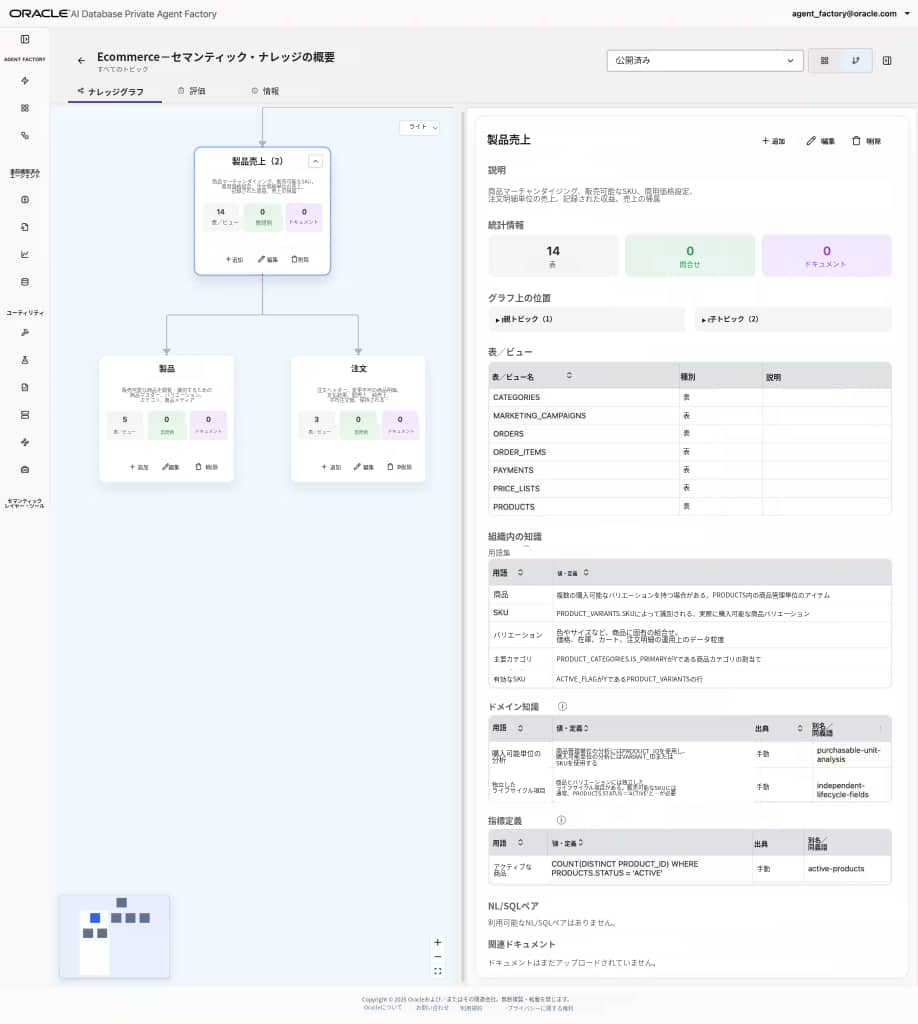
ビジネスナレッジグラフにより、SQL生成モデルに渡す無関係な情報量を大幅に減らせます。エージェントに企業のスキーマ全体を見せる代わりに、ベクトル、テキスト、グラフを含む高度なデータベースネイティブの検索技術を使い、質問への回答に必要なデータと知識を過不足なく含む可能性が最も高いトピックを特定します。
ビジネスナレッジグラフの評価
ビジネスナレッジグラフは、作成後も固定されるものではありません。データベースの表や業務定義が変わったり、エージェントにより高度な質問をさせるために新しいトピックが加わったりします。したがって、変更のたびに正確さを継続評価できるワークフローを確立することが重要です。
NL2SQLには、そのための回帰テストのワークフローが組み込まれています。流れを説明します。
- まず、自然言語の質問と、それに対応する検証済みSQLの集合を、Deep NL2SQLの回帰テストスイートに登録できます。これを「ゴールド」セットと呼びます。回帰テストでは、これらの質問を毎回実行します。
- ビジネスナレッジグラフへの変更は、全ユーザーに見える正式な公開済みグラフに含めても安全と判断されるまで、未公開状態で保持されます。
- 評価ワークフローを起動し、未公開のグラフを使ってゴールドセットをDeep NL2SQLに実行させ、回答を生成できます。
- 回答が期待する集合と一致すれば、変更は安全とみなせます。未公開グラフを公開済み状態に切り替え、変更を全ユーザーに反映できます。
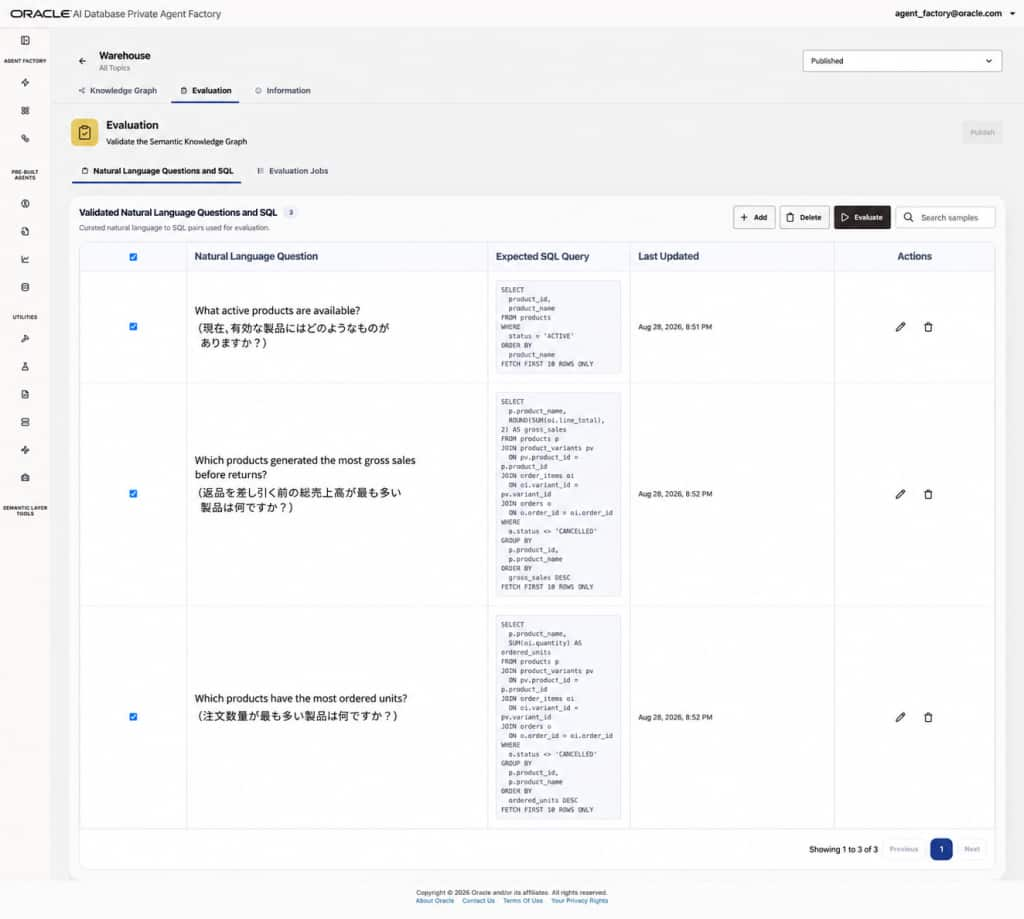
ワークベンチは、ビジネスナレッジグラフのごく小さな変更でも、期待する動作に影響しないことを確かめるベストプラクティスを定着させます。ユーザーはシステムに100%の信頼を期待するため、応答の一貫性と決定性を促すことが不可欠です。
フィードバック駆動のNL2SQLと人の関与
ビジネスナレッジグラフを作成し、テストと十分な検証を終えると、Deep NL2SQLで質問に答えられます。ただし、この段階でも信頼性をさらに組み込めます。中核となるのは、エージェントとユーザーの会話のすべての段階で、人の関与(human-in-the-loop)を通じてフィードバックを求め、回答の正確さと信頼を確保する機能です。その流れを説明します。
質問を受けると、エージェントはまず知識を集め、曖昧さを解消して、質問を十分に理解しようとします。最初に質問をビジネスナレッジグラフの1つ以上のトピックに対応付け、そこに含まれる知識で質問の意図が完全に明らかになるかを評価します。十分でないと判断すると、ためらわず業務ユーザーに確認の質問をします。
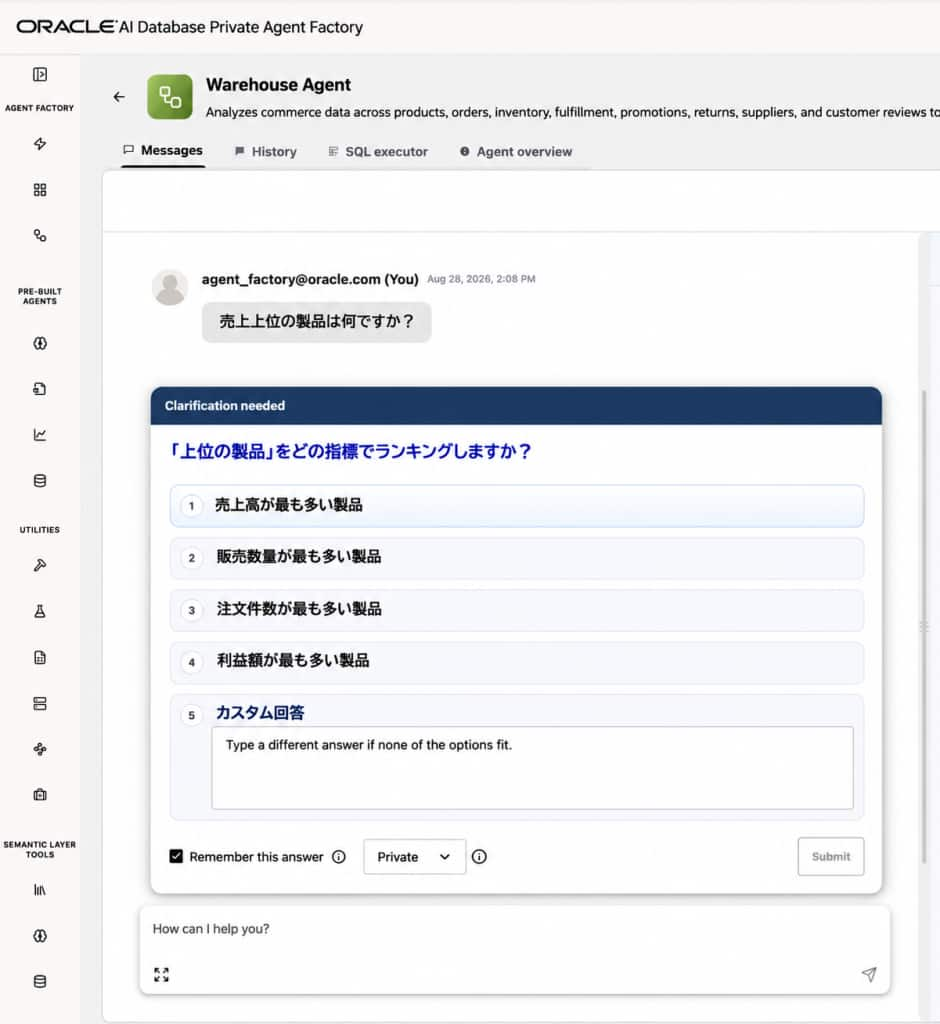
注 – 説明のため画面上の問いかけを日本語に置き換えています
ビジネスナレッジグラフの知識と人の関与を組み合わせて質問を理解したら、SQL生成を始めます。Deep NL2SQLは、質問の分解、問合せ計画、探索的データ分析、SQLの生成と実行、振り返りと検証を行う、高度な推論型エージェントです。質問に答える際の懸念を解消するため、すべての手順で人の関与を組み込むことがあります。たとえば「注文済み」をどのステータスで定義するかを決める際、グラフの文脈が不足していれば、ユーザーに明確化を求めます。
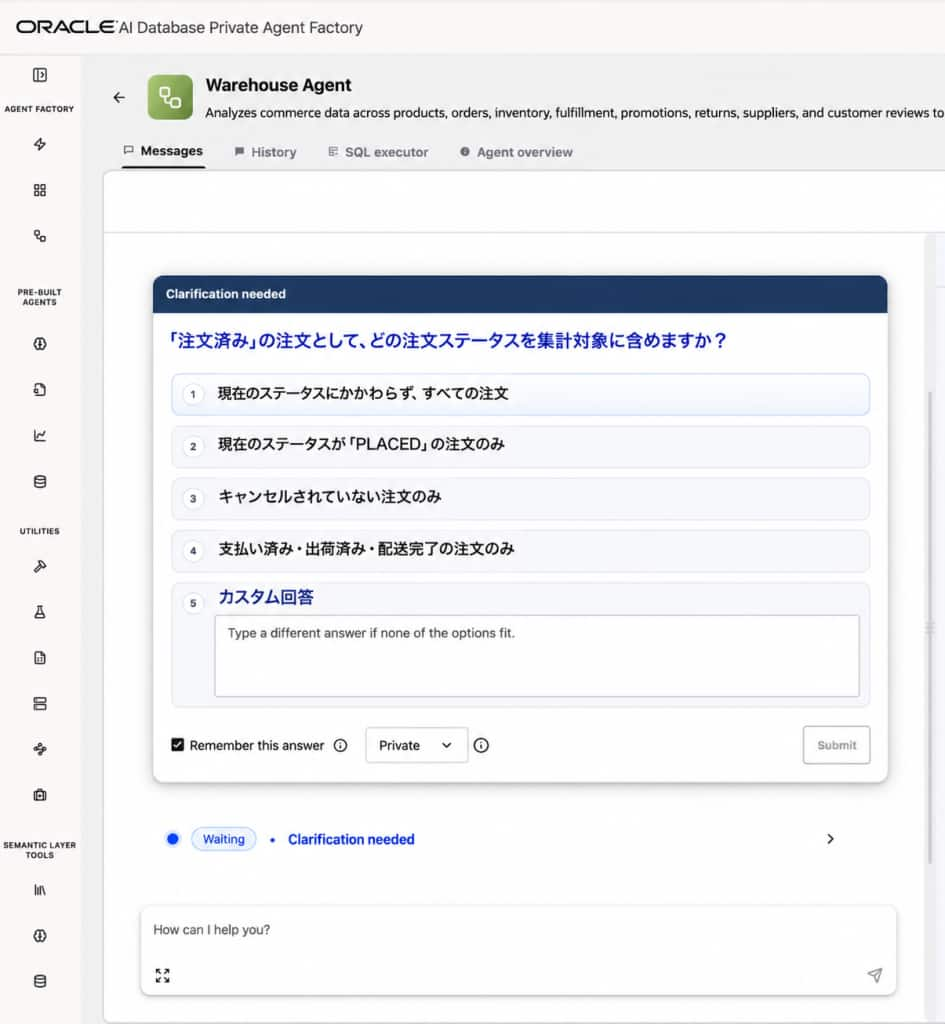
Deep NL2SQLは、生成した最終SQLを自ら見直し、前提やグラフから取り込んだ知識を振り返ったうえで、最終回答をユーザーに返します。SQLには、回答生成に至る考え方や推論のすべてが添えられ、回答を十分理解するための情報を提供します。
この段階でも信頼性を考慮しています。ユーザーは結果を高評価または低評価でき、それがバックエンドで処理する追加のフィードバックになります。
フィードバックを取り込んでシステムを改善する
会話中に蓄積したすべてのフィードバックは記録、ログ化され、エージェント設計者が後で検討できます。理想的には、これをビジネスナレッジグラフに追加し、将来は同じ確認質問をせずに済むようにします。得られた知識を、学習済みの知識にするのです。グラフに追加した知識は、ほかのユーザーも利用できます。また、Deep NL2SQLの評価ワークベンチを使えば、ユーザーに公開する前に安全に変更を取り込めます。
まとめ
従来のNL2SQLとは異なり、Deep NL2SQLは信頼を中核に設計されています。ビジネスナレッジグラフを通じ、企業知識を問合せ可能な意味領域に整理し、人の関与によるフィードバックで信頼できる精度を支えます。さらに、ナレッジグラフとその評価ワークフローを作成、検証、保守するワークベンチを提供します。フィードバックを、管理された再利用可能な知識として安全に取り込み、回答の一貫性、透明性、信頼を保ちながらシステムを改善できます。Deep NL2SQLなら、安心してデータと会話し、信頼できる回答を得られます。