
※ 本記事は、Bertrand Matthelieによる”Activate AI Agents on your entire enterprise data estate with innovations in Oracle Autonomous AI Lakehouse“を翻訳したものです。
2026年10月27日
HyperFRAME Researchは、「レイクハウスは、もはや分析の基盤だけではない。企業のAIに情報を供給し、動かす、意思決定の中核になりつつある」と述べています。
従来の分析では、業務システムから別の分析基盤へデータをコピーすることが一般的でした。この方法では、遅延や費用が増え、セキュリティ制御も分散する場合があります。AIエージェントには、OracleとOracle以外のデータベース、Apache Icebergテーブル、オブジェクトストレージ、外部カタログ、アプリケーションにある、現在の企業データへの高速なアクセスが必要です。
ただし、アクセスできるだけでは足りません。適切に判断し、信頼できる操作を実行するには、データの業務上の意味、情報源をまたぐ関係、組織のルールや方針を理解する必要があります。その背景がなければ、もっともらしくても、業務上は間違った回答になる可能性があります。
Oracle Autonomous AI Lakehouseでは、Oracle以外も含む情報源の現在のデータに、AI、業務知識、統一したガバナンスを適用できます。SnowflakeやDatabricksなど、他社の基盤も対象です。オープンな構成で既存のデータ基盤やツールと連携し、利用者やAIエージェントが保存先のままアクセス・分析できるため、別環境へのコピーや移動を減らせます。データは移さず、その場所でAIを使えます。
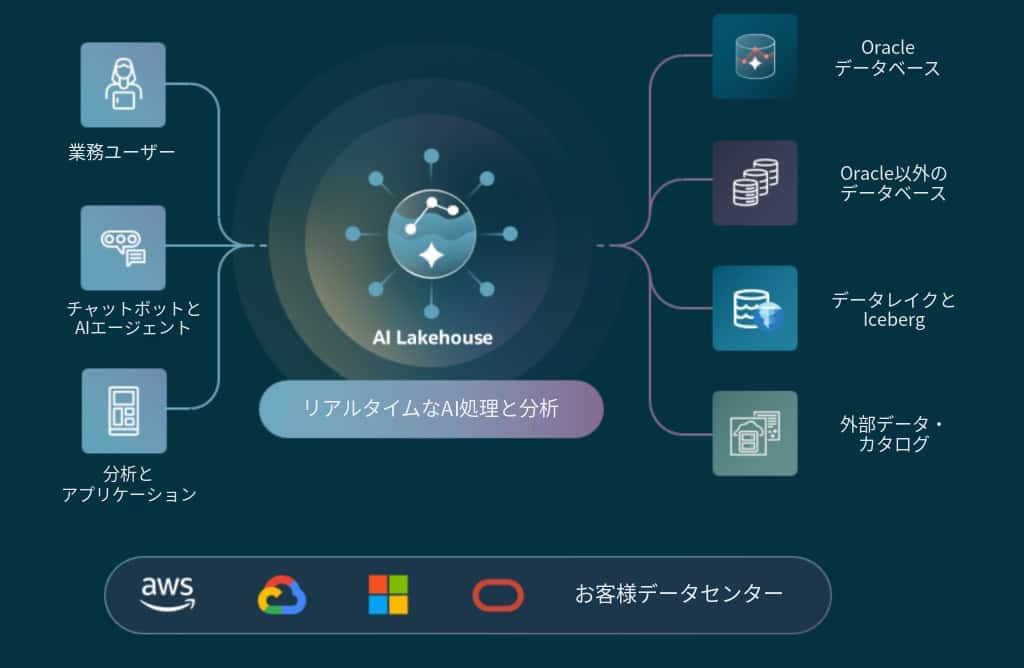
Autonomous AI Lakehouseは、Oracle Cloud Infrastructure (OCI)、Amazon Web Services (AWS)、Microsoft Azure、Google Cloud、Oracle Exadata Cloud@Customer、およびOCI Dedicated Regionで利用できます。
新機能と機能の拡充
Oracleは本日、業務知識を利用者やAIエージェントに伝え、多次元シミュレーションを行い、企業のデータ環境全体のガバナンスを強化するための新機能と拡充を発表しました。主に、次の3分野です:
- ビジネスを理解するエージェント型AI: 現在の企業データを、その業務上の意味とともに理解できるようにします
- Lakehouse 360〜統合データ活用基盤: 分析、AI、データエンジニアリング、業務シミュレーションを、一貫したレイクハウスの操作環境で扱います
- 信頼性とガバナンスを備えたAI: ロール別の制御と、情報源をまたぐデータの来歴を使い、アクセス管理を支援します
各分野の新機能と拡充を、詳しく説明します。
ビジネスを理解するエージェント型AI:
AI Data Catalog
AI Data Catalogでは、OracleとOracle以外のデータベース、外部カタログ、Icebergテーブル、オブジェクトストレージ上のデータを、コピーせず参照対象に追加し、企業全体を一元的に把握できます。AWS Glue、Databricks Unity Catalog、Snowflake Horizon Catalogなどに接続し、分散した情報源の発見、業務上の定義、来歴、ガバナンスをまとめて扱えます。Oracleエンジンの機能を使い、AI Data Catalog経由で、これらの現在のデータに問い合わせられます。(訳注: 詳細はこちら)
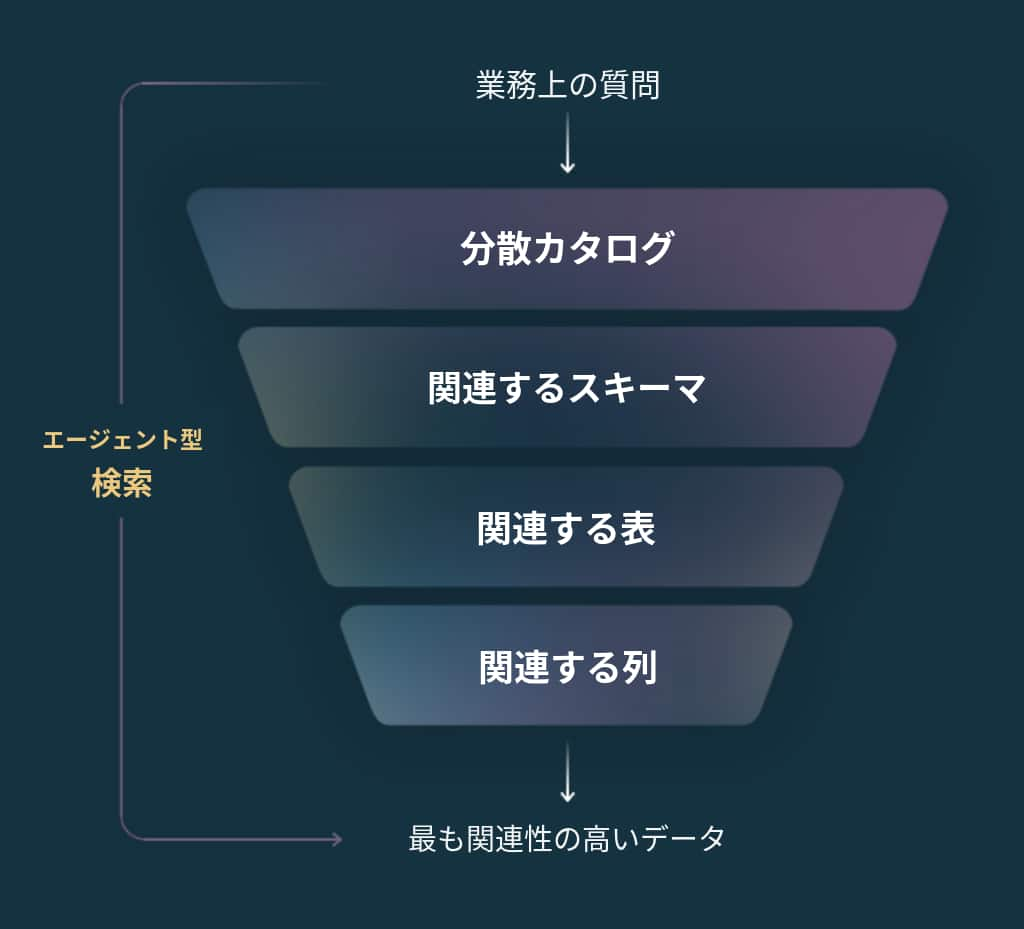
AI Data Catalogでは、来歴(リネージ)、処理のパターン、関係性、機密データに関する情報、業務上の意味、検索の手掛かりを使い、メタデータを継続的に充実させます。エージェントによる検索と対象の絞り込みで、大規模で複雑な環境でも、質問や業務に関係するデータ資産を探しやすくします。階層的に絞り込む際は、カタログ、スキーマ、テーブル、列へと段階的に対象を狭め、業務上の意味や関係から、各質問に必要な情報を特定します。必要な背景に集中することで、データの発見、自然言語の分析、エージェントの処理の質と速度を改善し、処理するメタデータを抑えて費用も減らしやすくなります。(訳注: 詳細はこちら)
ビジネス・セマンティック・レイヤー (Business Semantic Layer)
ビジネス・セマンティック・レイヤーでは、接続したすべての情報源に、業務上の意味を追加・充実させ、利用者、アプリケーション、AIエージェントで共通の解釈基盤を使えます。アノテーション (注釈)の作成、既存のOracle Database SQLアノテーションの取り込み、AIで充実させたテーブルや列の説明の生成ができます。共通の業務定義と補足情報を使い、情報源、分析ツール、エージェントのワークフローをまたいで、一貫してデータを解釈しやすくなります。
AIが提案するOracle Analytic Viewsを使い、複雑な多次元・階層データモデルも定義できます。ディメンション、メジャー、指標、階層、計算、KPIを記録し、結合、集計、階層ロジック、業務計算を、再利用可能なAnalytic Viewsにまとめることで、SQLを簡素化できます。
Apache Ossieへの対応により、互換システムのセマンティックモデルを取り込み、既存の業務定義をレイクハウスのデータに再利用できます。モデルを作り直す負担を減らし、分析、BI、AIツールで業務上の意味をそろえやすくなります。これらの機能により、Select AI、NL2SQL、AIの検索、分析結果の正確さと一貫性を高め、既存のOracle Autonomous AI Databaseのセマンティックモデルへの投資を生かして、より広いレイクハウスデータに利用できます。 (訳注: 詳細はこちら)
Icebergデータの標準対応を拡充
Autonomous AI Lakehouseでは、Oracle AI DatabaseのSQL、AI、分析、企業向けデータ管理を、オープンなApache Icebergのデータにも利用できます。標準のIceberg対応を強化し、外部カタログやOracle AI Data Catalog経由でのアクセスの性能と機能を拡充しました。問い合わせや分析だけでなく、使い慣れたOracle SQLで、Icebergテーブルの作成、データ投入、更新、削除も行えます。OracleとIcebergで共通の分析モデルを使い、AI分析、エージェントのワークフロー、再利用可能なデータプロダクトの基盤として、積極的に活用できます。 (訳注: 詳細はこちら)
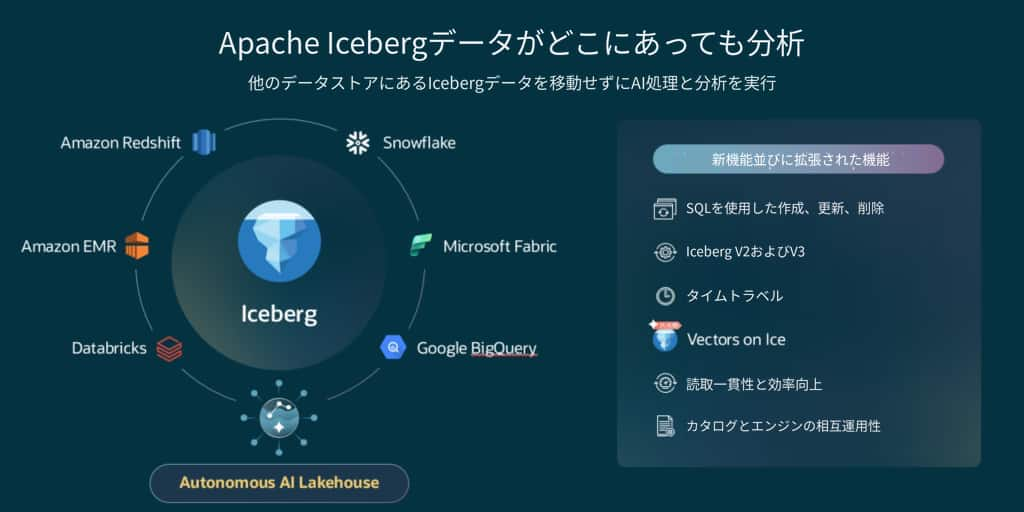
既存の対応カタログで管理するIceberg表を利用でき、カタログ、オブジェクトストレージ、Iceberg対応エンジンの選択も維持できます。Iceberg V2/V3への対応拡充で、オープンなレイクハウス環境との互換性も広がります。Vectors on Iceなどの既存機能を補い、Icebergデータのリレーショナル分析と、ベクトルを使うAI処理を組み合わせられます。
Oracleのクエリ最適化では、Icebergのメタデータやデータファイルの統計情報を使います。Puffinファイルに格納したコンパクトな統計も利用し、効率のよい実行計画を選んで、負荷の高い全表走査を避けやすくします。
Oracle ZFSやHitachiなど、オンプレミスのオブジェクトストアにも対応し、自社環境にデータを置く必要がある場合の選択肢を広げます。既存のIceberg環境を維持したまま、同じデータに性能、信頼性、AI機能を適用し、不要なコピーや移行を避けられます。AI Data Catalogでアクセスを管理し、最適化した書き込み、トランザクションの復旧、タイムトラベルで、更新、変更の調査、復旧を支えます。 (訳注: 詳細はこちら)
Live AI Hub
Live AI HubでAutonomous AI Lakehouseを、企業データと、その解釈に必要な業務知識に接続します。対応するOracleとOracle以外のデータベース、アプリケーション、オブジェクトストアに、その場所のまま一元的に問合せができます。AI Data Catalog、外部カタログ、オントロジー、文書などの情報を使い、Select AIやエージェントが自然言語の質問を理解し、業務の意味に沿ったSQLを生成しやすくします。接続、アクセスポリシー、認証情報は、AI Data Catalogで一元管理します。OracleのSQLエンジンで、複数の接続先へのクエリを処理・最適化し、分散した企業データにもAIと分析を適用します。既存のOracleデータを、予め別のAI基盤へ移さなくても、分析とエージェント型AIを拡張し、投資を生かせます。 (訳注: 詳細はこちら)
構築済みエージェントと独自のAIエージェント
Oracle AI Database Private Agent Factoryで提供する構築済みエージェントと、NL2SQL、データサイエンス、知識検索、詳細調査、構造化データ分析用のアシスタントを利用できます。対応するアクセス制御を使い、レイクハウスデータにアクセスする独自のエージェントや処理も、短期間で構築できます。機密データを別のAI基盤へ先に移さずに、知見の生成や業務フローを支援できます。
Lakehouse 360〜統合データ活用基盤:分析、AI、データエンジニアリング、業務シミュレーション
Data Studio (datastudio.oracle.com):
Data Studioでは、OCIアカウントから利用する、複数のOracleデータベースとレイクハウス情報源に共通の、AI支援付きワークスペースを提供します。データの発見、アクセス、準備、分析、管理を、1つの場所で行えます。統合したカタログとData Transformのパイプライン機能で、AI検索による企業データの探索、100超の情報源への接続、データベースリソースの管理ができます。分断されたツールを切り替えずに、分析、AI、データエンジニアリング、運用、業務シミュレーションをまたいだ作業を支援します。
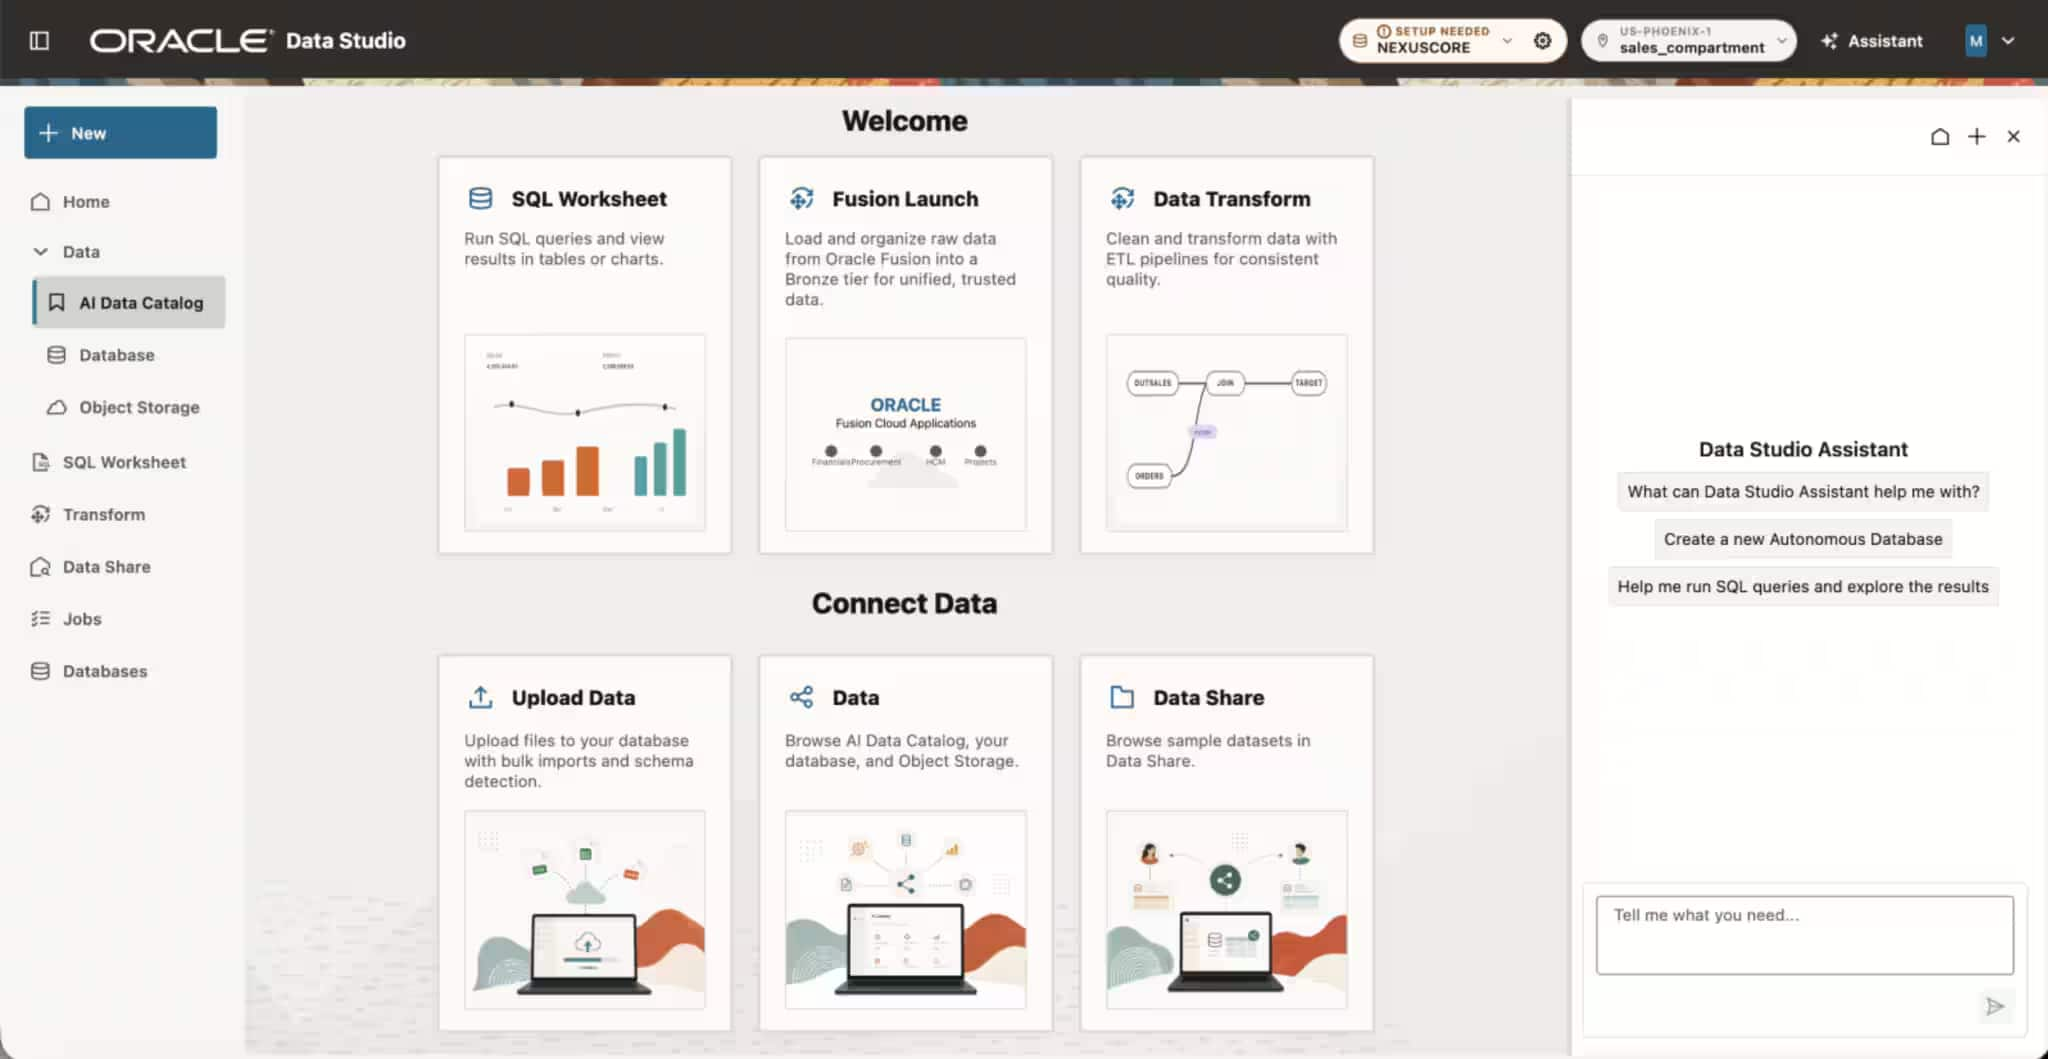
自然言語、SQL、Pythonでデータを扱えます。Select AIを搭載した組込みのAI Assistantで、会話による問合せや、どのようなデータ統合を実現したいかを自然言語で伝え実行したり、Data FlowsとWorkflowsの作成・改善、ジョブの監視や不具合調査、データベースとOCIの状態確認、製品ドキュメントの案内を利用できます。分析担当者、データエンジニア、DBA、データサイエンティスト、業務利用者が、共通のAI支援環境で、データ、ワークフロー、運用を扱えます。 (訳注: 詳細はこちら)
AIを活用したデータエンジニアリング
業務データなどのレイクハウスデータを、管理された再利用可能なデータプロダクトへ変換する、AI支援付きのローコードパイプラインを構築できます。Spectra Data Extractを使う新しいFusion連携では、変換・公開用のデータ抽出を効率化します。Data StudioのAI Assistantに自然言語で依頼し、Transformパイプラインを作成できます。Oracle AI Databaseの機能で、業務・アプリケーション・レイクハウスのデータを洗浄、結合、補足、公開し、別処理のためにデータベースから書き出さずに済みます。 (訳注: 詳細はこちら)
データエンジニアは、Bronze、Silver、Gold層からなるメダリオンパターンで、分析、AI、業務シミュレーション用のデータを整備できます。大規模なレイクハウス処理では、TransformでSparkパイプラインを構築し、Oracle AI Data Platform Workbench SparkやAmazon EMRを通じて実行を調整できます。
ビジネス・シミュレーション・エンジン (Business Simulation Engine)
Oracle Essbaseを基にしたエンジンを導入し、実績ある多次元シミュレーション、計画、予測、仮定に基づく分析を、レイクハウス内で利用できます。レイクハウスのデータからモデルを作り、動的な階層集計、高度な計算、配賦でシナリオを組み立て、結果をOracle AI DatabaseやApache Icebergテーブルへ書き戻せます。売上、需要、価格、能力、原価、リスクなどの前提が変わった場合の、潜在的な業務への影響を評価できます。
業務利用者は、自然言語で質問し、シミュレーションレポートを生成し、Oracle Smart Viewで使い慣れたExcelの分析を行えます。複雑な階層や多次元計算はエンジンで管理し、AIで、スキーマやレイクハウスの情報から、適したEssbaseキューブを提案できます。計画・シミュレーションモデルの作成を効率化しやすくなります。 (訳注: 詳細はこちら)
Data Lake AcceleratorとLake Cache
Object Storageデータへのクエリ処理を、柔軟に拡張し、費用効率よく高速化できます。最新の改善では、100TBのデータを使った当社のTPC-DSベンチマークで、性能が3倍になりました。Data Lake Acceleratorの最大クラスターサイズも32ノードから100ノードへ増え、より大きなデータへの問い合わせに対応できます。
Lake Cacheでは、Object Storageから繰り返し読む必要を減らし、Exadataの性能を利用します。よく使うデータをExadataのフラッシュにキャッシュし、後のクエリで、リモート読み取りの代わりに再利用できます。
ベンチマークでは、リモートデータへのアクセスが最大8倍高速になりました。Icebergテーブルに対するTPC-DSクエリでは、Lake Cacheなしの96秒から、使用時は17秒へ短縮しました。Data Lake Acceleratorと組み合わせ、柔軟なクエリ処理能力と、高速な外部データアクセスを利用できます。
信頼性とガバナンスを備えたAI
セキュリティとガバナンスの一元化
AI Data Catalogのロール別アクセス制御で、オンプレミスとクラウドの情報源をまたいで、アクセスとガバナンスを管理できます。**分散したOracleデータベース、一部のOracle以外の情報源、Icebergテーブルに対し、エンドユーザーとエージェントのオブジェクト単位のポリシーを適用できます。たとえば、バケット全体へ広く権限を与えず、個別のIcebergテーブルを許可し、作業に必要なデータオブジェクトだけを利用させられます。
多数のデータベース、数千のテーブル、多様な利用者を抱えるお客さまに、特に有用です。AI Data Catalogを、発見とアクセスについての共通した管理層として使うことで、情報源ごとに別々のポリシーを管理する負担を減らせます。接続と認証情報を一元管理して、管理作業を減らし、レイクハウス経由で利用できるデータをカタログのポリシーで制御します。これらは、元の情報源で適用するアクセス制御を置き換えず、併用します。
データ・リネージの自動取得
利用者とエージェントは、どこから来て、どう変わり、どこで使われているかを、最初から最後まで追跡できます。データベースの操作、Data Transformのパイプライン、Sparkジョブ、連携したレイクハウスの処理から来歴を収集し、アプリケーション、データベース、データレイク、外部カタログ間の移動と変化を示します。
OpenLineageなどのオープン標準を取り入れ、幅広いデータ環境で来歴を把握できます。Spark、Airflow、dbt、Databricks、Snowflake、BigQueryなど、オープンソースや商用製品間で、来歴のイベントを取得・交換できます。リネージグラフでは、結合、絞り込み、業務ルール、独自ロジックなどの複雑な変換を可視化し、出所の追跡、変更の影響分析、問題の調査を効率化します。AIの用途では、利用者、ガバナンス担当者、監査担当者が、データの出所を調べ、生成結果を評価し、分析、NL2SQL、エージェントの処理に使ったデータを理解するための根拠になります。 (訳注: 詳細はこちら)
認証情報の払い出し (Credential vending)
AI Data Catalogのアクセスポリシーに基づき、問合せエンジンやAIエージェントに、Icebergテーブルを読み書きするための、一時的で表単位の認証情報を渡します。Spark、Trinoなどの対応エンジンやエージェントの処理から、Object Storageにあり、AI Data Catalogや対応する外部カタログで管理する、許可済みのテーブルを使えます。オープンなレイクハウスの相互運用性を保ち、自社のアクセスポリシーを適用しながら、範囲が広く有効期間の長い認証情報への依存を減らせます。
データ・アクセスから、業務の実行へ
AIの用途は、回答を得るところから、業務フローで実際に行動するところへと広がっています。回答は判断材料になりますが、行動は、その後に起こることを変えます。
Autonomous AI Lakehouseの最新機能で、業務知識に基づくエージェント、多次元シミュレーション、企業データ全体の一貫した管理を支援し、この変化を後押しします。
これらは、Oracle AI Databaseの問合せ最適化、組込みAI、リレーショナルデータ、JSON、ベクトルなどを単一エンジンで扱うコンバージドな構成を基盤としています。高い同時実行性能、Exadataの性能、信頼性を使い、既存のシステム、レイクハウス、カタログ、ツールを維持したまま、分析とAIの規模を広げられます。
すべてのデータに、どこに存在していても、AIとOracleの力をもたらします。
Autonomous AI Lakehouseを、ぜひご覧ください:
上記は、当社の製品の一般的な方向性を説明するもので、情報提供のみを目的とし、いかなる契約にも組み込むことはできません。コードや機能の提供を約束するものではなく、購入判断の根拠とすべきではありません。Oracle製品について説明した機能の開発、リリース、時期、価格は変更される可能性があり、Oracle Corporationの独自の裁量に委ねられます。