※ 本記事は、Rohit Sahaによる”Building open, reliable data products in AI Data Platform with Apache Iceberg“を翻訳したものです。
2026年11月1日
企業のデータチームには、信頼性の高いデータ製品を構築すると同時に、多様化する分析エンジンやAI処理、日々の運用要件に対応することが求められています。しかし、従来のデータレイクのテーブルでは、こうした対応が難しい場合があります。複数の処理による同時更新の管理が複雑になったり、スキーマ(データ構造)の変更が既存の処理に影響を及ぼしたりするためです。また、プラットフォーム間でデータを移動・コピーすることで、本来は不要な手間やコストも発生します。
Oracle AI Data PlatformがApache Icebergテーブルをサポートするようになりました。これらの要件に対応するために設計されたオープンなテーブル形式によって、データ管理機能を拡張します。Icebergは、ACIDトランザクション、スナップショット、スキーマ進化、拡張性のあるメタデータ管理により、分析とAIのワークロードに長期的に対応できる、信頼できるデータプロダクトの構築を支援します。マネージドIcebergテーブルと外部Icebergテーブルは、これらの機能をガバナンスの下で管理されたAI Data Platform環境に取り込み、企業全体でのデータプロダクトの作成、運用、共有を可能にします。
Icebergを選ぶ理由
現代のデータ製品には、大量のデータを保存するだけでなく、さまざまな機能が求められます。複数の処理から同時にデータを更新しても正しく処理できること、同じ条件で分析すれば同じ結果を再現できること、変化するビジネス要件に対応できること、そして複数の分析環境やAI環境からデータを利用できることが必要です。
Apache Icebergは、データレイクストレージ内でデータファイル、テーブルメタデータ、変更をどのように整理するかを定義する、オープンなテーブル形式です。Oracle AI Data Platformでは、Icebergテーブルが、このストレージ層にデータベースのような信頼性をもたらします。ACIDトランザクションは、挿入、更新、削除、マージをアトミックな操作にし、スナップショット分離は、パイプラインが新しいデータを書き込んでいる間も、読み取り側が一貫したバージョンのテーブルを参照できるようにします。
コミットされた変更ごとに、テーブルのスナップショットが作成されます。チームは、特定の過去のバージョンをクエリして、分析の再現、データ品質の問題の調査、時系列での結果の比較、正常と確認済みの状態へのテーブルの復元を行えます。Icebergはまた、大規模テーブル向けに設計されたメタデータ、隠しパーティショニング、データとワークロードの増大に伴ってファイル配置を効率的に保つ保守操作によって、規模の拡大に対応します。
Delta Lakeに加えてIcebergを利用する理由
Apache IcebergとDelta Lakeは、データレイクやレイクハウスのアーキテクチャで、大規模なデータストレージを扱うためのオープンなテーブル形式です。どちらもACIDトランザクション、スキーマ進化、バージョン履歴、タイムトラベルを提供し、信頼性の高いテーブルを大規模に管理することを支援します。重要な違いは、中核機能ではなく、それぞれの形式がサポートするために設計された環境とアクセスパターンにあります。
Apache Icebergは、スナップショットとマニフェストファイルに基づくメタデータアーキテクチャを使用します。これにより、エンジンはクエリに関連するファイルを効率的に特定でき、スキーマとパーティションの進化がサポートされ、同じテーブルを複数の処理環境で継続して利用しやすくなります。この設計は、分散した分析環境とAI環境に対応する必要がある、オープンなデータプロダクトに適しています。
Delta Lakeは、トランザクションログとチェックポイントを通じてテーブルの変更を記録します。Sparkを中心とする環境に深く定着しており、チームは成熟したDeltaベースのパイプラインを活用できます。Delta Lakeは相互運用性を拡大してきましたが、ネイティブな利用体験が最も充実しているのは、引き続きSparkエコシステム内です。
| ユースケース | データ形式 |
|---|---|
| 共通のオープンなテーブル形式を必要とする、プラットフォーム横断の分析 | Apache Iceberg |
| AI Data PlatformとAutonomous Databaseを通じてアクセスするデータプロダクト | Apache Iceberg |
| 移植可能なアクセスと、変化に対応できるパーティション戦略を必要とする、長期利用のデータプロダクト | Apache Iceberg |
| Sparkを中心とする既存のパイプライン、分析、運用慣行 | Delta Lake |
| Deltaネイティブのガバナンスとエンジニアリングツールをすでに標準としているワークロード | Delta Lake |
Icebergは、単一の処理環境を超えて運用することを想定したデータプロダクトに、オープンなテーブルの選択肢を追加します。AI Data Platformはマネージドテーブルや外部テーブルにIcebergを使用でき、同じデータプロダクトは、Autonomous Databaseを含む互換性のあるエンジンやサービスからも引き続きアクセスできます。Delta Lakeは、すでに運用上の標準となっている既存のワークロードを引き続き支えられます。Icebergは、プラットフォームを横断した再利用とオープンなアクセスが主要な要件となるワークロードに向けて、アーキテクチャを拡張します。
重要なのは、2つの形式は共存できるということです。テーブル形式は、データプロダクトの想定利用者と運用環境に合わせて選択する必要があります。
AIと分析のユースケース
AI Data Platformは、分析、データサイエンス、機械学習、AIアプリケーション向けに、ガバナンスの下で管理されるデータプロダクトをチームが構築できるようにします。アナリストは、整備された顧客、製品、財務、業務のデータを利用できます。データサイエンティストは学習用データセットや特徴量データセットを開発でき、AIアプリケーションは承認済みの業務データを使用して、関連性があり、追跡可能な応答を提供できます。
たとえば、サービスエージェントは、注文、製品、アカウントに関するコンテキストを取得できます。財務エージェントは、承認済みの業務データを分析して差異を説明でき、分析コパイロットは、整備された企業のテーブルを使用して質問に回答できます。これらの利用体験は、明確に定義されたスキーマ、管理された変更、適切なガバナンスを備えた、信頼できるデータプロダクトに依存しています。
Icebergは、これらのデータプロダクトをAI Data Platformで実装するための、テーブル形式の選択肢の1つです。特に価値を発揮するのは、複数の処理エンジンから同じデータプロダクトにアクセスするシナリオです。AI Data Platformで作成または管理されたIcebergテーブルは、データエンジニアリング、分析、AIのワークロードを支えると同時に、サポート対象の統合機能を通じて、Autonomous Databaseなどの互換性のあるエンジンやサービスからも利用できます。
これにより、チームはデータプロダクトを一度構築すれば、環境ごとに別のコピーを作成することなく、複数の利用側で再利用できます。Icebergは、その水準の相互運用性を必要とするワークロードに向けて、オープンでプラットフォーム横断のテーブル形式によって、AIと分析のユースケースを拡張します。
マネージドIcebergテーブルと外部Icebergテーブルの作成
AI Data Platformは、Apache Icebergテーブルを扱うために、次の2つの方法をサポートします。
- AI Data Platformで構築するデータプロダクト用に、新しいマネージドテーブルを作成する
- 既存のIcebergテーブルを外部テーブルとして登録する
マネージドIcebergテーブルは、AI Data Platformがデータプロダクトの作成と保守の主要な環境となる場合に適した選択肢です。チームは、SQLまたはAI Data Platformのインターフェースを使用して、標準カタログのスキーマ内にテーブルを作成し、列とパーティション戦略を定義したうえで、挿入、マージ、パイプラインを通じてデータをロードできます。AI Data Platformは、テーブル定義と基盤データのライフサイクルを管理するため、マネージドテーブルは、整備されたブロンズ、シルバー、ゴールドのデータセットに適しています。
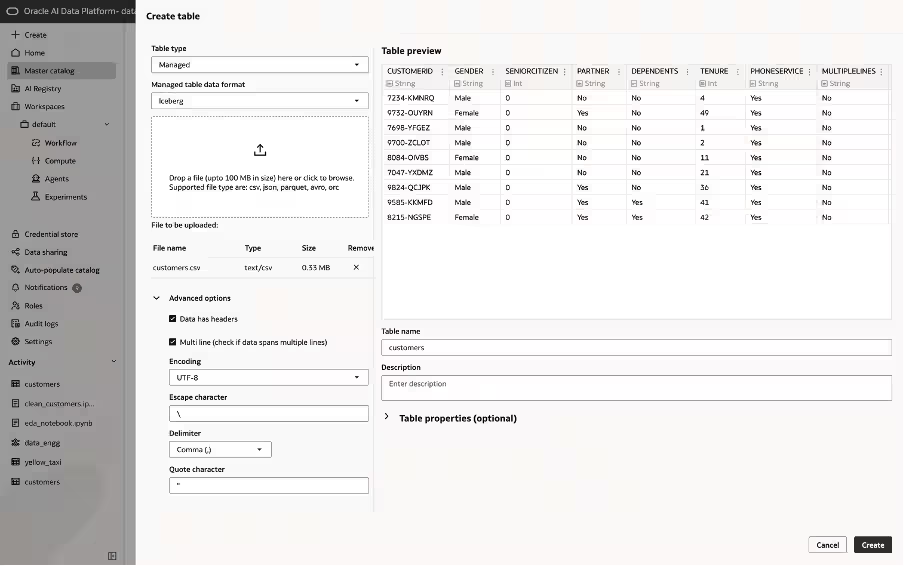
マネージドIcebergテーブルの作成
外部Icebergテーブルは、AI Data Platformの外部にすでに存在するデータを扱うために設計されています。チームは、そのデータを新しい場所にコピーするのではなく、既存のIcebergテーブルを登録し、AI Data Platformを通じて利用します。これは、Icebergデータがすでに別のエンジンやプラットフォームで管理されており、複数の利用側から引き続き利用可能である必要がある場合に有効です。テーブルは既存のストレージの場所にとどまり、AI Data Platformは、ガバナンスの下での検出、クエリ、変換、下流での利用を可能にします。
この違いは、ライフサイクル管理で特に重要です。マネージドテーブルを削除すると、その定義と管理対象データの両方が削除されます。外部テーブルを削除すると、AI Data Platformのテーブル定義は削除されますが、基盤となるソースデータはそのまま残ります。チームは、AI Data Platformが所有するデータプロダクトにはマネージドテーブルを、共有される、または独立して運用されるIcebergデータセットには外部テーブルを、意図的に選び分ける必要があります。
作成または登録が完了すると、どちらの種類のテーブルも、挿入、更新、削除、マージ、スキーマ変更、スナップショットに基づくクエリなど、使い慣れたSQL操作をサポートします。適切なカタログ権限とスキーマ権限によって、認可されたユーザーだけが、これらのデータプロダクトを作成、変更、利用できるようにします。
増分データパイプラインの構築
更新処理が遅い、不安定である、またはテーブル全体の再構築を必要とする場合、データプロダクトの価値は低下します。Icebergは、下流のユーザーに対して一貫性があり、クエリ可能なテーブルを維持しながら、新規データや変更されたデータだけを適用する増分パイプラインを実現します。
AI Data Platformでは、チームはINSERT、UPDATE、DELETE、MERGE操作を使用して、新しいレコードをロードし、既存のレコードに修正を適用できます。たとえば、注文パイプラインは、新しい注文とステータス変更を整備されたテーブルにマージし、顧客パイプラインは、ソースシステムの変更に合わせてアカウント属性を更新できます。各書き込みはアトミックにコミットされるため、読み取り側に見えるのは、以前の一貫したバージョンか、新たにコミットされたバージョンのいずれかであり、部分的に更新されたテーブルではありません。
このモデルは、一般的なエンジニアリングパターンをサポートします。
- 変更データキャプチャ: 業務システムから届く挿入、更新、削除を、到着に合わせて適用します。
- マイクロバッチ取り込み: 過去のデータを再構築せずに、定期的なファイルやイベントを処理します。
- 整備されたテーブルへのアップサート: ソースの変更を、顧客、製品、在庫、財務のデータプロダクトにマージします。
大量のデータを扱うワークロードでは、パイプラインの設計にテーブル保守を含める必要があります。小さなファイルや増大するメタデータは、時間とともにクエリ効率を低下させる可能性があるため、チームはIcebergの保守プロシージャを使用して、データファイルとマニフェストを書き換えることができます。これにより、データの鮮度と物理的な最適化を切り離せます。パイプラインは変更をすばやくコミットし、コンパクションとメタデータの保守は適切なスケジュールで実行できます。その結果、データエンジニアリングの運用モデルの信頼性が高まります。パイプラインは共有データプロダクトを継続的に改善でき、分析チームは安定したスナップショットをクエリでき、AIアプリケーションは完全な更新サイクルを待たずに、最新でガバナンスの下で管理されたデータ基盤を利用できます。
利用を妨げないデータの進化
業務データが変化せずにとどまることは、ほとんどありません。新製品によって新しい属性が加わり、規制要件が変わり、ソースシステムが刷新され、分析チームは同じ情報を整理するための異なる方法を必要とします。従来のデータレイクでは、こうした変更が、高コストの書き換え、壊れやすいパイプラインの更新、下流に影響を及ぼす障害を引き起こす可能性があります。
Icebergは、テーブルの論理的なスキーマ(列の名前やデータ型などの定義)と、実際のデータファイルを分けて管理します。そのため、通常はテーブル全体のデータを書き換えることなく、列の追加・削除・名前の変更・並べ替え・データ型の変更ができます。各列は位置とは関係なく識別されるため、名前を変更しても、元の列とは無関係な新しい項目として扱われることはありません。同じ列としてのつながりが保たれます。
AI Data Platformでは、要件の変化に応じて、ALTER TABLE操作でIcebergテーブルの構造を変更できます。たとえば、顧客データを扱うデータ製品に、データ利用への同意に関する設定項目を追加したり、従来のアカウント項目の名前を変更したり、より精度の高いデータ型を導入したりできます。その間も、既存のデータを利用でき、後続の分析や処理を継続できます。
スキーマ進化にも、引き続きガバナンスが必要です。データの所有者は、変更がダッシュボード、パイプライン、モデル、AIアプリケーションに与える影響を評価し、互換性を損なう変更を周知し、代表的なワークロードに対して更新を検証する必要があります。Icebergは進化に伴う運用コストを削減しますが、データプロダクトに適切な所有責任を持つ必要がなくなるわけではありません。その結果、企業データの基盤は、より適応性の高いものになります。チームは、すべてのスキーマ変更を移行プロジェクトとして扱ったり、利用側をテーブル全体の再構築まで待たせたりすることなく、データプロダクトを継続的に改善できます。
Icebergテーブルのパフォーマンスの最適化
Icebergテーブルは規模を拡大できるように設計されていますが、パフォーマンスは、データの書き込み方、整理方法、保守方法に引き続き左右されます。テーブルが大きくなるにつれて、頻繁な増分書き込みによって小さなファイルが多数作成され、メタデータも増大する可能性があります。保守を行わないと、クエリ計画の作成時間が長くなり、スキャン効率が低下し、分析ワークロードのコストが増える可能性があります。
AI Data Platformでは、チームはファイルサイズ、データの分散、メタデータを管理することで、Icebergテーブルを最適化できます。書き込み時には、目標ファイルサイズやハッシュベースの書き込み分散などのプロパティによって、並列処理により適したファイルを生成しやすくなります。パーティショニングには、一般的なクエリパターンを反映する必要があります。たとえば、イベントデータには時間ベースのパーティションを使用したり、大規模なクエリの対象を一貫して絞り込める業務ディメンションを使用したりしつつ、小さなパーティションが過剰に増えることを避けます。
Icebergの保守プロシージャは、テーブルを健全に保つための運用ツールを提供します。
- rewrite_data_filesは、小さなファイルをまとめたり、データファイルを再編成したりして、スキャン効率を改善します。
- rewrite_manifestsは、メタデータファイルを統合し、テーブルの進化に伴うクエリ計画の作成を改善します。
- テーブルプロパティでは、ファイル形式、目標ファイルサイズ、書き込み分散のデフォルト値を定義できます。
これらの操作は、ワークロードに合ったスケジュールで実行する必要があります。大量のストリーミングデータやマイクロバッチを扱うテーブルでは、頻繁なコンパクションが必要になる場合があります。一方、定期的に更新される分析用テーブルでは、大きなロードの後だけ保守が必要になる場合があります。チームは、可能な場合、取り込みと最適化を分離する必要もあります。
パフォーマンスチューニングは、繰り返し行うものです。データ量、ファイル数、クエリのレイテンシ、ワークロードの同時実行数を監視し、利用状況の変化に応じて、パーティショニング、書き込み設定、保守スケジュールを調整します。このような取り組みによって、データと需要の両方が増大しても、Icebergテーブルは大規模な分析、特徴量エンジニアリング、AIアプリケーションに対する効率性を維持できます。
タイムトラベル、ロールバック、データ保持
Icebergでは、書き込みが成功するたびに、新しいテーブルスナップショットが作成されます。これらのスナップショットは、データプロダクトの時間の経過に伴う変化を示す永続的な記録となり、チームが過去のバージョンをクエリし、不適切な書き込みから回復し、履歴データを意図的に管理できるようにします。
AI Data Platformのタイムトラベルクエリでは、特定のスナップショットや時点に存在していた状態のテーブルを読み取れます。これは、レポートの検証、モデル学習用データセットの再現、データ品質インシデントの調査、分析結果が変わった理由の説明に役立ちます。チームは、別途作成したバックアップコピーに頼るのではなく、実際に使用されたテーブルのバージョンを参照できます。
ロールバックは、この機能を復旧に拡張します。誤ったマージ、不具合のあるパイプラインの実行、意図しない更新がテーブルに反映された場合、認可された運用担当者は、以前の正常と確認済みのスナップショットにテーブルを復元できます。これにより、復旧時間が短縮され、増分パイプラインの運用リスクが低下します。
スナップショット(ある時点のテーブルの状態)は、保持する目的や期間を決めて管理する必要があります。履歴を多く残せば、監査で過去の状態を確認しやすくなり、復元できる時点も増えます。一方で、メタデータの管理負荷やストレージの使用量も増加します。Icebergには、保持期限を過ぎたスナップショットを削除する仕組みがあり、データ製品の価値や機密性に応じた保持ポリシーを適用できます。たとえば、規制の対象となる財務データは履歴を長期間保持し、大量に発生する業務イベントのデータは保持期間を短くするといった運用が可能です。
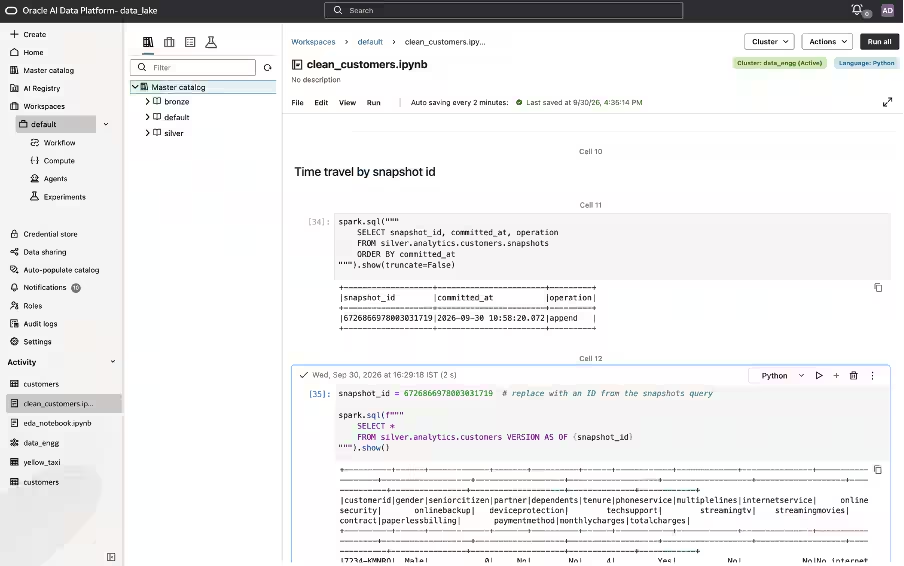
タイムトラベル
実務では、テーブルを定義する際に、履歴の保持に関する要件も決めておくとよいでしょう。過去のバージョンをいつまで利用可能にしておくか、誰が過去の状態への復元や保持期限を過ぎたスナップショットの削除を実行できるか、そして、これらの判断が後続のレポートやモデル、AIアプリケーションにどう影響するかを明確にします。こうした方針があれば、スナップショットを適切に管理し、分析結果の再現や障害からの復旧を支える基盤として活用できます。過去のファイルが管理されないまま蓄積していくことも防げます。
タイムトラベル、ロールバック、保持のサンプルコードは、こちらで確認できます。
AI Data PlatformのIcebergテーブルとAutonomous Databaseの統合
Apache Icebergにより、データセットのデータベース専用コピーをあらかじめ作成することなく、AI Data PlatformからAutonomous Databaseへデータプロダクトを共有できます。Autonomous Databaseは、AI Data PlatformのIcebergテーブルを外部テーブルとして登録し、同じテーブルメタデータとデータファイルをクエリできます。
このパターンは、AI Data Platformがデータエンジニアリング、変換、データ準備を担当し、Autonomous Databaseがデータベースユーザー、アプリケーション、レポート作成ワークロード向けのSQLアクセスを提供する場合に有効です。Icebergが共通のテーブル形式となり、各プラットフォームは、それぞれのコンピュート環境とクエリ環境を通じて、ガバナンスの下で管理されたデータプロダクトにアクセスします。
Autonomous DatabaseにIcebergテーブルを登録するには、Object Storageの格納場所に対する読み取り権限を持つOCI資格証明を作成し、DBMS_CLOUD.CREATE_EXTERNAL_TABLEを使用します。以下のコード例を参照して、Autonomous Databaseに外部テーブルを作成する方法を確認し、プレースホルダーを使用する環境の値に置き換えてください。
BEGIN
  DBMS_CLOUD.CREATE_EXTERNAL_TABLE (
    table_name      => '<ADW_EXTERNAL_TABLE_NAME>',
    credential_name => '<OCI_CREDENTIAL_NAME>',
    format          => '{
      "access_protocol": {
        "protocol_type": "iceberg",
        "protocol_config": {
          "iceberg_catalog_type": "hadoop",
          "iceberg_warehouse": "https://objectstorage.<REGION>.oraclecloud.com/n/<NAMESPACE>/b/<BUCKET>/o/<WAREHOUSE_FOLDER>",
          "iceberg_table_path": "<ICEBERG_NAMESPACE>.<ICEBERG_TABLE_NAME>"
        }
      }
    }'
  );
END;
/
この例では、各値は次の意味を持ちます。
<ADW_EXTERNAL_TABLE_NAME>は、Autonomous DatabaseのSQLユーザーに公開する名前です。<OCI_CREDENTIAL_NAME>は、Icebergウェアハウスへのアクセスを認可されたデータベース資格証明です。<WAREHOUSE_FOLDER>は、OCI Object Storage内のHadoopカタログのウェアハウスの場所です。<ICEBERG_NAMESPACE>.<ICEBERG_TABLE_NAME>は、そのウェアハウス内のIcebergテーブルを識別します。
Hadoopカタログの場所とIcebergテーブルパスの確認
AI Data PlatformのIcebergテーブルをAutonomous Databaseに登録するには、まずAI Data PlatformとOCI Object Storageから、Hadoopカタログのウェアハウスの場所とIcebergテーブルパスを取得します。
- AI Data PlatformでIcebergテーブルを開き、**Table details(テーブルの詳細)**を表示して、管理対象の格納場所を確認します。
- OCI Object Storageで、カタログが管理するオブジェクトツリーをたどり、テーブルのメタデータファイルを探します。
<catalog>.cat/<schema>.db/<table>/metadata/version-hint.text
version-hint.textの**Actions(アクション)**を開き、**View Object Details(オブジェクトの詳細の表示)**を選択します。オブジェクトのURLをコピーし、.catオブジェクトまでを含むURIの部分だけを残します。その値をiceberg_warehouseとして使用します。ウェアハウスの場所として、version-hint.textの完全なURLを使用しないでください。- AI Data Platformのスキーマとテーブル名から、iceberg_table_pathを組み立てます。Object Storageでは、スキーマは次のように表されます。
<schema_name>.db
.db内のピリオドは、%2EとしてURLエンコードする必要があります。たとえば、AI Data Platformのanalyticsという名前のスキーマは、analytics%2Edbになります。その後に、エンコードしないピリオドを挟んでテーブル名を追加します。
AI Data Platformのanalyticsスキーマ内にある、customersという名前のテーブルの場合、構成は次のようになります。
“iceberg_warehouse”: “https://objectstorage.<REGION>.oraclecloud.com/n/<NAMESPACE>/b/<BUCKET>/o/<CATALOG_ID>.cat”,
“iceberg_table_path”: “analytics%2Edb.customers”
この例では、analytics%2EdbはObject Storageのスキーマパスanalytics.dbを表し、customersはIcebergテーブル名です。カタログが管理するObject Storageの格納場所に示されている、正確な.catのURIとエンコード済みのテーブルパスを使用してください。
登録後、ユーザーは標準SQLでテーブルをクエリできます。
SELECT *
FROM <ADW_EXTERNAL_TABLE_NAME>
FETCH FIRST 100 ROWS ONLY;
これにより、役割を分担しやすくなります。AI Data Platformでオープンな形式のIcebergデータ製品を構築・維持し、Autonomous Databaseを通じて、SQLを使うユーザーやアプリケーションがそのデータを利用できるようにします。データを取り込むためのパイプラインを別途用意する必要はありません。両方の環境で、データベースの認証情報、Object Storageへのアクセス権限、Icebergのウェアハウスの保存先パスを、一貫した方針で管理することが重要です。
結論:作るのは一度だけ、あらゆる場所で利用する
Apache Icebergは、分析、AI、業務上の利用者に長期的に対応する必要があるデータプロダクトに、オープンで信頼性の高い基盤を提供します。AI Data Platformでは、マネージドIcebergテーブルと外部Icebergテーブルが、ガバナンスの下で管理された環境で、ACIDトランザクション、スナップショット、増分処理、スキーマ進化、パフォーマンス維持のための保守を組み合わせます。
チームは、AI Data Platformで新しいデータプロダクトを作成し、不要な複製を行わずに既存のIcebergデータセットを拡張し、Autonomous Databaseなどのプラットフォームと同じオープンなテーブルを共有できます。これにより、各ワークロードに適した計算エンジンを使用する柔軟性を維持しながら、データエンジニアリング、分析、AI開発の間の摩擦を減らせます。その結果、より持続性のあるデータアーキテクチャが実現します。データプロダクトは、進化しても信頼性を保ち、問題が起きたときに復旧でき、企業全体で再利用可能な状態を維持します。