※ 本記事は、Kailas Jawadekarによる”Building a Document Knowledge Base with Oracle APEX and Oracle AI Vector Search“を翻訳したものです。
2026年11月8日
Oracle APEX、Oracle AI Database、AI Vector Search、RAGを使った文書ナレッジベース
複数の文書に有用な知識が蓄積されていても、必要なときに活用するのは簡単ではありません。答えを探すために、いくつものファイルを開き、関連する用語を検索し、バージョンによる記載の違いを突き合わせなければならないこともあります。そこで私たちは、文書の内容を検索して再利用しやすくするために、Document Knowledge Baseというアプリケーションを構築しました。自然な言葉で質問したり、文書を基に下書きを生成したり、文書同士を比較したりできます。
構築には、Oracle APEX、PL/SQL、Oracle AI Databaseのベクトル保存機能、AIによる推論を組み合わせました。基本的な処理は、文書群を整理し、必要な箇所を検索で取り出し、その内容を基に質問に答えたり、新しい文章を作成したりする、というものです。扱う分野にかかわらず、同じ流れを利用できます。たとえば、サポート記事、開発者ガイド、運用手順書、製品ドキュメントなどを対象にできます。
主なポイント
- DOCX文書を取り込み、元のファイルとメタデータに加え、分割した文章(チャンク)と、その特徴を数値で表した埋め込みを保存します。
- Oracle AI Vector SearchとRAGを使い、それぞれの質問に答えるための根拠資料を検索して取得します。
- 回答を確認しやすいように、元の資料に基づいて答え、参照したファイル名と見出しを示すようモデルに指示します。
- 検索で取得した文章とプロンプトテンプレートを使い、後から編集できる下書きなどを生成します。
- 選択した文書を、モデルに渡せる情報量の範囲内で比較します。比較結果に記載されていない項目の意味を判断する前に、必要な内容を比較対象に含められているかを確認します。
生成された結果は、必ず確認してください。表の内容や長い文章を十分に取り込めていなかったり、埋め込みが作成されていなかったり、検索で取得する範囲が限られていたりすると、回答に必要な根拠が抜けることがあります。回答、下書き、比較結果を、元の文書と照合してください。
実装の範囲
Document Knowledge Baseは、簡単な構成の社内プロジェクトとして作ったもので、本番環境に導入したものではありません。このプロジェクトでは、文書から答えを探す、文章の下書きを作る、文書を比較するという、一連の処理を再利用できる形で示しています。どの分野で使うかは、取り込む文書によって変わります。サポートの案内、開発者向けドキュメント、運用手順、新しく加わった人向けの資料、製品知識などが、その例です。これらは同じ構成を応用する場合の例であり、用途ごとに適切な文書とプロンプトを用意し、必要な内容を取り込めているかを確認する必要があります。
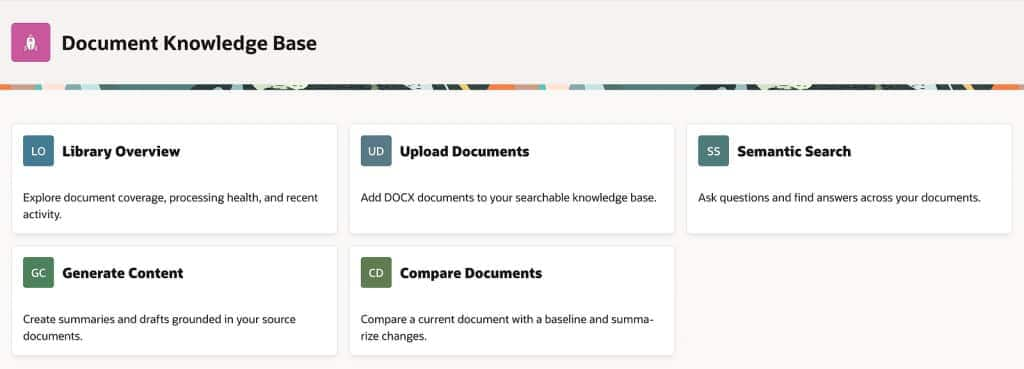
Document Knowledge Baseでは、文書のアップロード、検索、コンテンツの生成、文書比較を、1つのアプリケーションで行えます。
ユーザーができること
Document Knowledge Baseでは、主に次の3つの機能を使って作業できます。
- 質問する。 意味に基づく検索で関連する文章を取り出し、情報源への参照を付けた回答を生成できます。サポート文書を対象とするなら、たとえば「接続がタイムアウトするときは、どう調査すればよいですか」と質問できます。
- 下書きを作る。 検索で取得した内容とテンプレート内の指示を使い、要約、ナレッジ記事、返信案などを生成できます。どの題材をどの形式で書くかは、用意した文書とプロンプトで指定します。
- 文書を比較する。 比較したい文書と、基準となる文書を選び、両方の内容を根拠に、項目を整理した比較結果を生成できます。たとえば、ドキュメントの2つのバージョンを比べ、変更点を要約する場合に使えます。
現在のアップロード機能では、DOCXファイルとメタデータを追加できます。管理画面では、文書の内容をどこまで取り込めているか、取り込み処理がどの状態にあるか、埋め込みが未作成の箇所がないかを確認できます。
文書ナレッジベースのユースケース
ナレッジベースを何に役立てるかは、用意する文書と、行いたい作業に応じて決めます。次の例では、同じアーキテクチャをさまざまな用途に応用できます。ただし、用途ごとに適切な元資料とプロンプトを用意する必要があります。
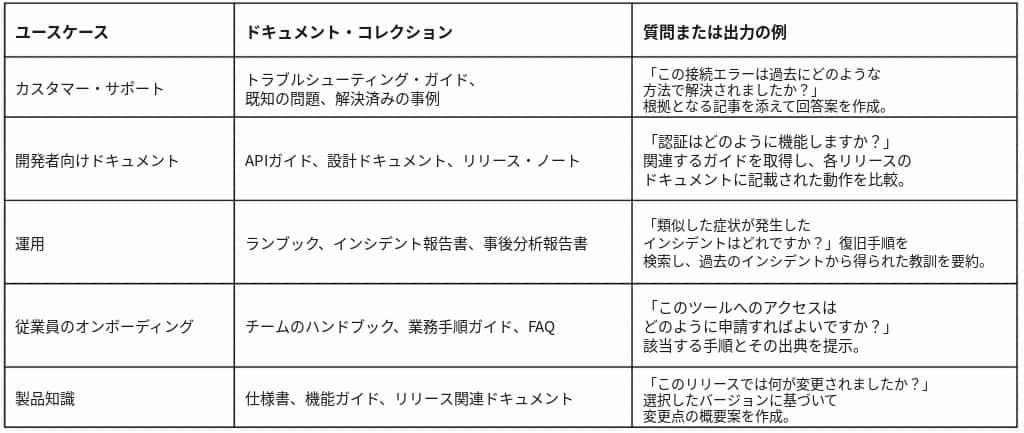
文書ナレッジベースのユースケース
アプリケーションの構成と処理の流れ
ブラウザーで使う画面、フォーム、レポートは、Oracle APEXで作成します。テキストの抽出、必要な文章の検索、プロンプトの作成、AIサービスの呼び出しには、PL/SQLパッケージを使います。データの保存にはOracle AI Databaseを利用し、リレーショナルデータと一緒にベクトルを保存して、AI Vector Searchで検索します。今回の実装では、元のDOCXファイルをBLOBとして保存するほか、ファイル名、日付、ハッシュ値、処理状態、抽出したテキスト、文書内の順序を保持したチャンク、埋め込みを、スキーマ内に格納します。さらに、検索時の質問とそのベクトル、生成した回答、再利用できるプロンプトテンプレートも保存します。レポート生成と文書比較については、作成したプロンプトと、その出力も保存します。ただし、質問への回答を生成するパッケージでは、回答のテキストを保存する一方、その生成に使ったプロンプトは保存しません。
これらのデータをOracle AI Databaseにまとめて保存すると、別のベクトルストアとの同期が不要になります。SQLで、根拠となる文章とメタデータを直接結合し、カテゴリで絞り込み、保存した生成用プロンプトと出力を取得できます。一連の処理を調べたり、保守したりしやすくなりますが、この構成だけで、文書を漏れなく抽出できることや、正確に回答できることを保証するものではありません。
アプリケーションでは、主に次の2つの流れで処理します。
文書 → テキストを抽出 → チャンクに分割 → 埋め込みベクトルを作成 → 保存
質問 → 埋め込みベクトルを作成 → 関連するチャンクを検索 → 回答を生成
このように、検索した情報を基に回答を生成する方法を、検索拡張生成(RAG)と呼びます。モデルを呼び出すたびに、元の文書から選んだ文章を渡します。アップロードした文書を使って、モデルを学習させるわけではありません。ベクトルとリレーショナルデータを同じデータベースに保存することで、意味の近さによる順位付け、メタデータによる絞り込み、文書を明示的に指定する方法を、SQLで組み合わせられます。
AIサービスを呼び出すためのラッパーでは、OpenAI互換の埋め込み用とチャット用のリクエスト形式で、OCI Generative AIのエンドポイントにアクセスするよう設定しています。接続先のURLとモデルの識別子は、設定値として指定します。APIのシークレットはAPEX Web Credentialsに保存し、REST呼び出し時に参照することで、アプリケーションのコードに書き込まずに済むようにします。ソースコードに含まれるエンドポイントのデフォルト値や、モデル名の仮の値は、セットアップのために置かれたものです。その組み合わせが現在サポートされていることを示すものではありません。利用するサービスの最新ドキュメントを参照し、対象環境で埋め込みとチャットの両方を呼び出せることを確認してください。
前提条件とセットアップ
- Oracle APEXとデータベースの対応状況。
VECTOR、TO_VECTOR、VECTOR_DISTANCEに対応するOracle Database環境で、APEXワークスペースと解析スキーマを用意します。インストールされているAPEXとデータベースのバージョンを確認してください。ソースコードからは、動作確認済みのAPEXの最小バージョンまでは分かりません。独自に作成したパッケージでは、APEX_ZIP、APEX_JSON、APEX_WEB_SERVICEを使います。 - OCI Generative AIへのアクセス。 埋め込み用とチャット用のHTTPSエンドポイントに接続できるようにし、利用権限のあるモデルID、対象リージョンでの提供状況、必要なサービス権限を確認して設定します。
EMBEDDINGS_URL、EMBEDDING_MODEL、CHAT_URL、CHAT_MODELを設定し、両方の呼び出しをテストしてください。OpenAI互換のチャットを呼び出せても、同じように埋め込みを呼び出せるとは限りません。現在のベクトル列と変換処理では1,536次元を想定しているため、文書を取り込む前に、埋め込みの次元数を診断する処理の結果を確認します。 - APEX Web Credentials。 このプロジェクトではBearerトークンを使います。HTTP Headerタイプの資格証明を作成し、ヘッダー名に
Authorization、シークレット値にBearer <API key>を設定します。Valid for URLsで、使用を認めるURLを対象サービスのプレフィックスに制限してください。WEB_CREDENTIAL_STATIC_IDには、その資格証明のStatic IDを設定します。後に示すプロジェクトの構築手順ではcredentials-for-standards-ai、元の初期データではopenai-api-keyを使っていますが、どちらかをそのままコピーするのではなく、実際のワークスペースで有効な資格証明に合わせてください。データベース環境に応じて、外部向けのネットワークアクセスも設定します。 - スキーマとページの設定、および少量のDOCXでの試行。 スキーマと、取り込み、AI、検索、回答、テンプレート、レポート、比較の各パッケージをインストールします。正常にコンパイルできることを確認し、APEXページのプロセスに接続します。まず代表的なDOCXファイルを使い、抽出したテキスト、チャンク、埋め込みを確認してから、回答をテストしてください。提供するソース一式は、そのまま1回の操作でAPEXアプリケーションを完全に導入できることまで検証したものではありません。現在のアップロード機能はDOCX専用です。PDF、HTML、Markdown、画像を扱うには、それぞれに対応した解析処理を追加する必要があります。
サポートされる認証方法とサービス設定については、OracleのWeb Credentialsのガイドと、OCI Generative AIのAPIキーとエンドポイントのドキュメントを参照してください。
文書を取り込み、検索できる形にする
ユーザーがDOCXファイルをアップロードすると、アプリケーション内に元のファイルを保存します。その際、SHA-256のハッシュ値を計算し、同じファイルを重複してアップロードしていないかを検出します。本文の段落は、APEX_ZIPとXMLTABLEを使って抽出します。続いて、見出しを検出し、テキストを約5,000文字ずつのチャンクにまとめます。各チャンクには、見出しと、どの文書から取り出したものかを示す情報を残します。
テキスト抽出には制限があります。XPathで取得するのは、本文の直下にある段落です。表のセル内の段落は取得しません。また、補助処理で取得する文字列は、XML内でひとまとまりに扱う文字列(テキストラン)1つにつき最大200文字であり、それらをまとめた段落も3,000バイトまでに制限します。そのため、長い文章では、チャンクに分割する前の段階ですでに一部の内容が欠けている可能性があります。必要な内容を取り込めているかは、元のDOCXファイルと照合して確認してください。なお、隣接するチャンク間で、同じ文章を重ねて含める処理は行っていません。
次に、各チャンクの埋め込みを作成し、VECTOR(1536, FLOAT32)型で保存します。埋め込みとは、文章の意味の近さを比較できるように、テキストを数値の並びで表したものです。これを使えば、異なる言葉で書かれていても、関連する文章を意味の近いものとして検索できます。たとえば、「サインインできない」という質問に対し、「認証の失敗」について書かれた文章が見つかることがあります。
埋め込みを作成する関数では、設定したモデルにテキストを送り、返されたJSON配列をOracleのベクトルに変換します。次のコードは、PL/SQLパッケージ内の変換処理を抜き出したものです。
l_response := embedding_response(p_text);
l_embedding_json := json_query(
  l_response, '$.data[0].embedding' returning clob);
select to_vector(l_embedding_json, 1536, float32)
into l_vector
from dual;embedding_responseでは、設定した埋め込みモデルと入力テキストを指定して、JSON形式のリクエストを作成します。文書のチャンクと質問を同じ埋め込みモデルで数値に変換し、両者のベクトルを比較できるようにします。
回答の根拠を検索し、回答を生成する
検索するたびに、質問を一度だけ埋め込みに変換し、そのベクトルを保存します。続いてSQLで、文書のチャンクを、質問とのコサイン距離が小さい順に並べます。距離が小さいほど、意味が近いと判断します。次のコードでは、ナレッジベースのテーブル名を一般的な名前に置き換え、中心となる処理を簡略化して示しています。順位を付ける前に、メタデータで対象文書を絞り込むこともできます。
select c.chunk_id, c.heading, c.chunk_text, vector_distance(c.embedding, q.query_embedding, cosine) distance from kb_doc_chunks c join kb_search_queries q on q.search_id = :search_id where c.embedding is not null order by distance fetch first :top_n rows only;選んだ文章に、ファイル名、見出し、文書の日付を添えて、プロンプトにまとめます。その中で、今回の質問に答えること、情報源を示すこと、渡された資料だけでは答えられない場合はその旨を伝えることを、モデルに指示します。生成処理には、共通の関数を使います。
l_output := kb_ai_pkg.generate_text( p_system_prompt => 'Ground every claim in provided source material.', p_prompt => l_prompt);この関数の中では、APEX_JSONを使ってチャットのリクエストを作成します。次に、APEX_WEB_SERVICE.MAKE_REST_REQUESTを使い、設定済みのWeb Credentialを指定して送信します。返された結果のchoices[0].message.contentから回答のテキストを取り出し、APEXの画面に表示します。
取得した根拠資料を、文章の生成や文書比較にも使う
新しいコンテンツを生成する場合は、検索で取得した文章に、トピック、出力の種類、テンプレート内の指示を加えます。テンプレートには、想定する読者、文章の構成、文体を指定し、元の文書から取得した文章を根拠として使います。今回の実装では、作成したプロンプトと生成したテキストを保存し、Markdown形式でダウンロードできるようにしています。
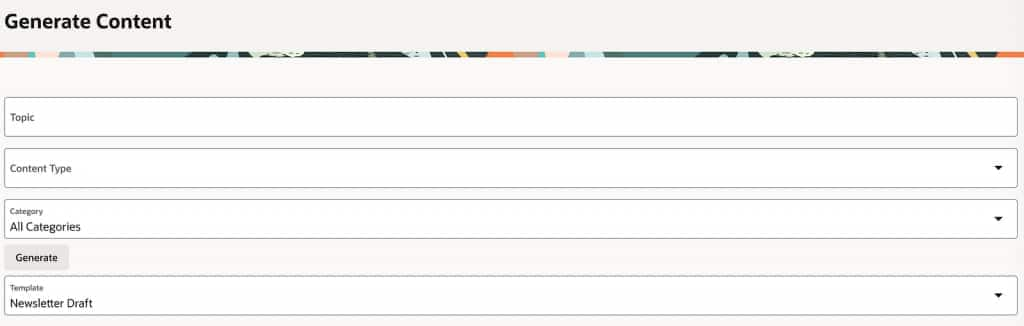
トピック、コンテンツの種類、カテゴリ、テンプレートを指定して、生成する内容を指示します。画像は、その入力フォームです。生成した下書きは、元の文書と照合して確認する必要があります。
文書比較では、「この2つの文書の間で、何が変わったか」を調べます。ユーザーは、比較対象の文書と基準となる文書を選び、情報源への参照を付けた、項目ごとの比較結果を生成できます。画面には、比較対象の文書と基準文書を選ぶ欄、必要に応じて使うカテゴリの絞り込み、比較を実行するための操作が用意されています。
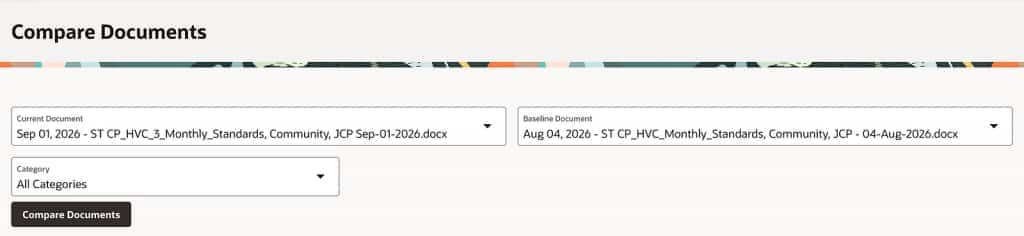
比較対象の文書と基準となる文書を選び、内容を比較します。選択欄には、この社内プロジェクトに現在取り込まれている文書を例として表示しています。
文書を比較するときは、意味の近さで検索する方法とは異なり、選んだ各文書から、決められた数までのチャンクを文書内の順番に取得します。プロンプトでは、一方を現在の文書、もう一方を基準文書と明示し、資料で裏付けられる変更点を示すように指示します。取得するのは、各文書で埋め込みを作成済みのチャンクのうち、デフォルトでは先頭から10個、最大で15個までです。カテゴリで絞り込んだ場合は、その条件にも従います。このようにモデルに渡す情報量に制限があるため、ある項目が比較結果に記載されていなくても、その項目に関する問題が解決済みだと判断することはできません。
別の用途に応用する際も、文書の保存、テキスト抽出、チャンクへの分割、埋め込みの作成、検索、生成の各処理は再利用できます。メタデータ、絞り込み条件、プロンプトは、扱う分野に合わせて決めます。たとえば、サポート情報を集めるなら製品とバージョンで、開発者向けドキュメントならAPI、言語、リリースで絞り込む、といった方法が考えられます。また、元資料のファイル形式に対応した解析処理と、文書群に適したアクセス制御も必要です。現在のアップロード機能で扱えるのは、DOCXファイルです。
適切な回答を得るには、モデルに渡す根拠資料が重要です。現在の抽出処理では主に本文の段落を取り込むため、必要な内容を取得できているかを確認するときは、特に表や長い文章に注意してください。類似度スコアだけで、記載内容が事実として正しいか、最新かどうかまでは確認できません。生成した回答は、引き続き元資料と照合する必要があります。
Document Knowledge Baseでは、文書の追加、質問、下書きの作成、元資料の比較を、一連の作業として行えます。文書、メタデータ、ベクトル、再利用できるプロンプト、生成したデータをOracle Databaseにまとめて保存することで、使い慣れたSQLの結合や絞り込みを使いながら、これらの作業を進められます。次に行うべきことは、代表的な文書を使い、抽出と検索が適切にできているかを検証することです。利用範囲を広げる前に、生成した出力も元資料と照合して確認してください。
画像は、実際に動作するDocument Knowledge Baseの画面です。コードは、一般化したkb_という名前を使った簡略例であり、それだけでインストールできるスクリプトではありません。
関連資料:Oracle APEXのWebサービスAPI、Oracleのベクトル距離関数。
よくある質問
このアプリケーションで何ができますか
DOCXの文書群を検索し、その内容を、質問への回答、下書きの生成、選んだ文書同士の比較に再利用できます。たとえば、サポートチームではトラブルシューティングの手順を探し、開発チームではAPIの概要を下書きし、新しく加わった人を支援する担当者は、従業員が必要な手順を見つけるのを手助けできます。実際にどのように使えるかは、用意する文書とプロンプトによって変わります。
どのファイル形式に対応していますか
現在のアップロード機能とテキスト抽出処理で扱えるのは、DOCXです。PDF、HTML、Markdown、スキャン画像の読み取りや、DOCX内の表を漏れなく抽出する処理は実装していません。別の形式に対応するには、解析処理を追加し、必要な内容を取り込めるか検証する必要があります。
このアプリケーションではRAGをどのように使いますか
質問を埋め込みに変換し、保存したチャンクを意味の近い順に並べ、選んだ文章をモデルへの入力情報として渡します。そのうえで、元資料に基づいて答え、情報源への参照を示すようモデルに指示します。一方、文書比較ではこの検索方法を使わず、明示的に選んだ2つの文書から、取得数に上限を設けて、文書内の順番どおりにチャンクを取り出します。
アップロードした文書でモデルを学習させますか
アプリケーションのコードから行うのは、埋め込みの作成と文章生成の呼び出しです。モデルの学習やファインチューニングは行いません。元資料から選んだテキストは、設定した推論サービスに送信します。ただし、これはアプリケーションの実装についての説明であり、サービス提供元によるデータの保持方法や利用方法まで一律に説明するものではありません。機密文書をアップロードする前に、選択したサービスとモデル、および適用される利用条件を確認してください。
取り込める内容や回答の正確さには、どのような制限がありますか
テキストを抽出する際、表のセルは読み飛ばします。また、長いXMLのテキストランや段落は、途中で切り詰められる場合があります。チャンク同士の内容にも重なりを持たせていません。埋め込みを作成できていない箇所がある場合や、メタデータで絞り込んだ場合、検索や比較で取得する範囲を限定した場合にも、必要な根拠を取りこぼすことがあります。意味が似ていることや、情報源を引用していることだけで、内容の正しさや新しさを確認できるわけではありません。必要な内容を抽出できているかを確かめ、生成した回答、下書き、比較結果を、いずれも元の文書と照合してください。