※ 本記事は、Gaurav Chadha, Kosta Stojiljkovicによる”Oracle Live AI Hub: AI on live data, wherever it lives“を翻訳したものです。
2026年11月2日
企業データが一か所だけに存在することは、ほとんどありません。顧客関係はCRMアプリケーション、取引は業務データベース、製品の活動はさらに別のシステムで管理されます。業務上の質問は、日常的にそれらすべてにまたがります。
一般的な解決策は、分析用にデータをコピー、変換、集約するETLパイプラインの構築です。しかし、継続的な保守が必要で、定期更新の間には古い情報を使うこともあります。新しい質問のたびに、別のソース、変換、管理すべきパイプラインが増えるかもしれません。
Oracle Autonomous AI Lakehouseは、Live AI Hubでこの課題に対応します。接続先システムで利用できる最新データを、集約して保存し直さずに、1つの分析へ取り込みます。分散データをOracle SQLでクエリし、自然言語で質問し、同じ接続情報にAIエージェントからもアクセスできます。
仕組みを説明し、販売の質問について、接続から回答確認までをたどります。
Live AI Hubがデータのある場所へ分析を届ける
Oracle Live AI Hubは、クラウドとオンプレミスのOracle Database、他のサポート対象データベース、業務アプリケーション、オブジェクトストアへ接続します。共通のOracle SQLインターフェースを通じ、CRM上の顧客情報、Oracle Database上の購買履歴、MySQL上の製品利用状況を、1つのクエリで組み合わせられます。
ソースデータベースをアップグレードせずに、サポート対象の既存データベースへAI機能を適用できます。Oracleが管理する組み込みコネクタにより、対応するリモートソースへ、追加のコネクタ費用なしで接続できます。
Oracle Autonomous AI Lakehouseがハブとして、接続先全体のクエリ実行を調整します。各ソースの機能に応じ、サポートされる副問い合わせをソース側へ送って実行します。絞り込みや集計をデータの近くで行えるため、システム間で移す情報量が減ります。ハブは、ソース間の結合など、残りの処理を完了して統合結果を返します。
ローカルビューは、リモートデータに、使い慣れた名前、管理されたアクセス、一貫した構造を与えます。Select AIは、ビューに関連付けられたメタデータと業務上の意味を使って、自然言語の質問からSQLを生成します。同じ接続データをSQLクエリ、ダッシュボード、AIエージェントで利用でき、ユーザーとアプリケーションが企業内の複数システムの情報へアクセスできます。
アナリストは、質問ごとに新しいパイプラインを作らずに、条件を変えて分析をやり直せます。「ライブ」とは、クエリの実行時点で各接続ソースが提供する情報を照会する意味です。レコードや要約がどれだけ新しいかは、ソース自身の更新スケジュールにも左右されます。
どの商談に注力すべきか
営業チームが、どの未完了商談に注力するかを決める場面を考えます。商談金額が出発点になりますが、顧客関係、製品の定着状況、未解決のサポート問題も把握する必要があります。
情報は次の4システムに分散しています。
| ソース | 提供する情報 |
|---|---|
| クラウドのOracle DB | 購買履歴、過去の収益 |
| オンプレミスのOracle DB | サポート案件の状態と優先度 |
| MySQL | 最近の製品利用状況 |
| HubSpot | 未完了の商談と金額 |
良好な購買履歴と製品の定着は、有望な商談を示す可能性があります。一方、未解決の高優先度サポート案件があれば、営業の話をする時期が変わるかもしれません。
各システムの利用可能な最新情報で、これらを合わせて判断します。
Data Studioでソースを接続する
Data Studio(datastudio.oracle.com)は、ソースの接続、データ探索、分析を行う統合環境です。まず、ハブになるAutonomous AI LakehouseインスタンスへData Studioを接続します。
権限を持つユーザーが、リモート接続とビューを作成します。以下の例では、プライベートデータベースリンクとビューは、同じハブスキーマに属しています。
クラウドOracle、オンプレミスOracle、MySQL、HubSpotの順に進めます。
クラウドのOracle DBから始める
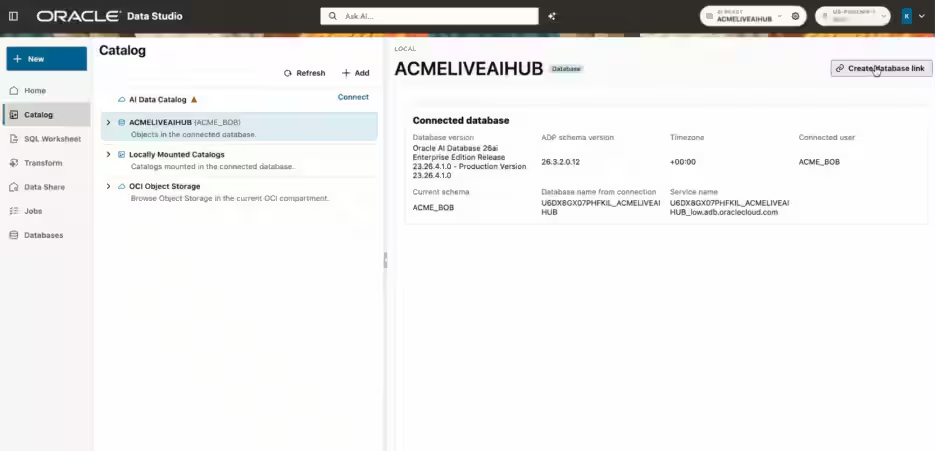
接続したハブDBを選び、Create database linkを実行します。
購買履歴を持つクラウドOracleの場合:
- リンクをCLOUD_ORACLE_LINKと名付けます。
- ホスト名、リスナーポート、サービス名を入力します。
- 購買データを読めるリモートDBアカウントの資格証明を選択、または作成します。
- リンクを作成し、小さなクエリで確認します。
資格証明が、リモートDBへのアクセスに使うアカウントを決めます。
オンプレミスOracleとMySQLを追加する
サポート案件を格納したオンプレミスのOracle Databaseにも、同じデータベースリンク方式で接続します。まず、ルーティング、DNS名前解決、リスナーポートへのアクセスを含め、ハブからデータベースへのネットワーク到達を確立します。
リモートのホスト名、ポート、サービス名と、サポートデータを読み取る権限を持つアカウントの資格証明を使って、ONPREM_ORACLE_LINKを作成します。
MySQLでは、ホスト名、ポート、データベース名、読み取り用の資格証明を使ってMYSQL_LINKを作成します。サポート対象のMySQLソースとの接続は、Oracle管理の異種データベース接続機能が処理します。DBMS_CLOUD_ADMIN.CREATE_DATABASE_LINKで作成する場合、ゲートウェイ構成にはmysqlなどのソース種別と、パブリックまたはプライベートエンドポイントに必要な設定を含めます。[2]
分析前に、それぞれに接続して数件を取得して確認します。
OAuthでHubSpotに接続する
HubSpotへの接続では、通常の接続設定に加えて、アプリケーションの認証と、APIデータをリレーショナル形式にマッピングするための設定が必要です。接続は、以下の手順で行います。
- 商談データの読み取りに必要なスコープを指定して、HubSpotのOAuthアプリケーションを認証します。その後、クライアントID、クライアント・シークレット、リフレッシュ・トークンを取得します。
- SQL Worksheetで
DBMS_CLOUD.CREATE_CREDENTIALを使用し、HUBSPOT_OAUTH_CREDという名前のOAuth認証情報を作成します。 DBMS_CLOUD_ADMIN.CREATE_DATABASE_LINKを使用して、作成した認証情報を参照するHUBSPOT_LINKというデータベース・リンクを作成します。接続先としてHubSpotのエンドポイント(api.hubapi.com)、ポート番号(443)を指定します。さらに、使用するコネクタに必要なHubSpotゲートウェイのオプション、トークンURI、提供されるリレーショナル・モデルを設定します。- コネクタを通じて公開されているHubSpotのオブジェクトに対して簡単な読み取りクエリを実行し、正常にデータを取得できることを確認します。
コネクタの組み込み関係モデルは、サポート対象のアプリケーションデータを、表と列として公開します。これにより、クエリ前にアプリケーションAPIを対応付ける作業を減らせます。
データを使いやすくするビューを作る
各データソースへの接続が完了したら、リモートのデータベースやアプリケーションのオブジェクトを参照するローカル・ビューを作成します。これらのビューでは、分析に必要な項目やビジネス上のデータ構造を定義できます。実際にクエリを実行すると、ビューを通じて接続先のリモートデータが参照されるため、データをローカルにコピーすることなく利用できます。
下の例では、説明用のテーブル名と列名を使用しています。また、次の条件を前提としています。HubSpotのデータは正規化されたリレーショナル・モデルにマッピングされており、例に示す商談データの項目を参照できること、すべての金額が米ドル(USD)で管理されていること、各データソースの顧客情報が共通のCUSTOMER_IDで関連付けられていること、です。
まず、クラウド上のOracle Databaseに保存されている購買履歴を集計するビューを作成します。
CREATE OR REPLACE VIEW customer_revenue AS
SELECT customer_id,
       SUM(revenue_amount_usd) AS historical_revenue_usd
FROM sales.customer_revenue@CLOUD_ORACLE_LINK
GROUP BY customer_id;
次に、MySQL上の利用状況の要約を公開します。この例では、ソースに顧客ごとの現在の要約が1件ずつあることを前提とします。
CREATE OR REPLACE VIEW mysql_product_usage AS
SELECT "customer_id" AS customer_id,
       "active_users_30d" AS active_users_30d
FROM "analytics"."product_usage"@MYSQL_LINK;
分析に必要なサポート列を公開します。
CREATE OR REPLACE VIEW onprem_support_cases AS
SELECT customer_id, case_status, priority
FROM support.support_cases@ONPREM_ORACLE_LINK;
最後に、HubSpotの未完了商談のビューを作ります。
CREATE OR REPLACE VIEW hubspot_open_deals AS
SELECT customer_id, deal_name, deal_value_usd
FROM crm.deals@HUBSPOT_LINK
WHERE deal_status = 'OPEN';
収益ビューは顧客ごとに1行を生成し、利用状況ビューは顧客ごとに1つの要約を公開します。これらの関係を明示することで、結合時に収益や利用数が重複して増えるのを防ぎやすくなります。
通常のビューなので、レコードのコピーでなくクエリ定義を保存します。[3]
ビューに業務上の意味を追加する
分かりやすい名前は、人がデータを理解する助けになります。自然言語からのクエリ生成にも、列の意味、オブジェクトの関係、業務用語と格納値の対応という文脈が役立ちます。
この文脈を、ハブのビューと列に注釈(Annotation/アノテーション)として保存します。Data StudioのAIによる自動注釈には、データの意味を1クリックで説明する機能もあります。
この分析で使うSelect AIプロファイルでは、object_listに4つのビューを含め、“annotations”: “true”で注釈取得を有効にします。Select AIは、その注釈を、SQL生成用に設定された言語モデルへ渡すメタデータに含められます。[6]
「過去の収益」「最近の製品定着」「未解決の高優先度案件」という表現が、クエリのオブジェクトと値に結び付きます。
自然言語で質問する
設定後、Data StudioのAI Assistantで質問します。
過去30日に50人以上のアクティブユーザーがいる顧客の未完了商談はどれですか。商談名、金額、過去の収益、アクティブユーザー数、未解決の高優先度サポート案件数を表示し、商談金額の降順で並べてください。
アシスタントは、利用できるオブジェクトのメタデータと業務の注釈を使ってSQLの下書きを作成します。アナリストは、生成されたSQLを確認し、必要なら修正して、SQL Worksheetで実行します。
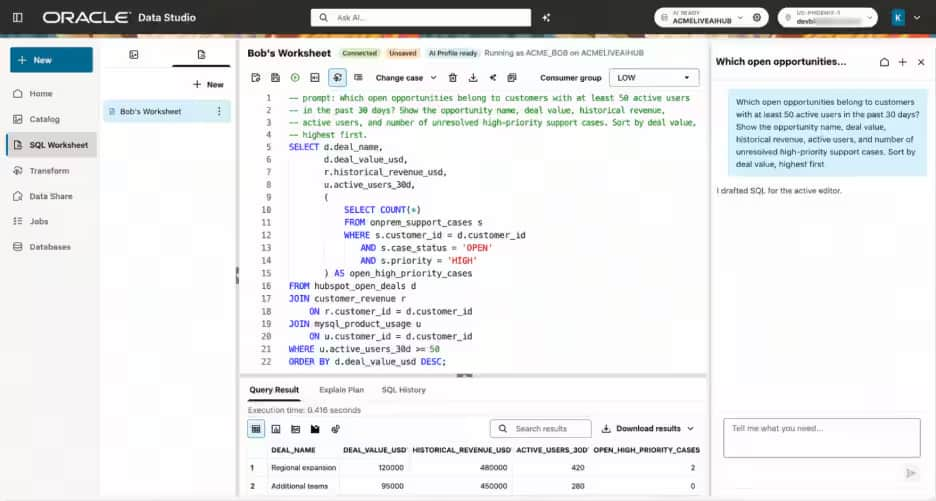
サポート案件を数えるクエリ例:
SELECT d.deal_name,
       d.deal_value_usd,
       r.historical_revenue_usd,
       u.active_users_30d,
       (
           SELECT COUNT(*)
           FROM onprem_support_cases s
           WHERE s.customer_id = d.customer_id
             AND s.case_status = 'OPEN'
             AND s.priority = 'HIGH'
       ) AS open_high_priority_cases
FROM hubspot_open_deals d
JOIN customer_revenue r
    ON r.customer_id = d.customer_id
JOIN mysql_product_usage u
    ON u.customer_id = d.customer_id
WHERE u.active_users_30d >= 50
ORDER BY d.deal_value_usd DESC;
このクエリは、HubSpotの未完了商談を、過去の購買収益とMySQLの利用状況に結合します。サポートの副問い合わせは、商談の行数を増やすことなく、関連する案件を数えます。
結果の例:
| 商談 | 商談金額(米ドル) | 過去の収益(米ドル) | 過去30日の利用者数 | 未解決の高優先度案件 |
|---|---|---|---|---|
| 地域展開 | 120,000 | 480,000 | 420 | 2 |
| チーム追加 | 95,000 | 450,000 | 280 | 0 |
1つ目の商談は、商談金額が大きく、製品の利用状況も良好ですが、未解決のサポート案件が2件あります。そのため、追加導入や契約拡大についてお客様と話し合う前に、サポート部門と状況を確認する必要があるかもしれません。一方、2つ目の商談については、アクセス可能なサポートデータの範囲では、該当する優先度の高いサポート案件は見つかりませんでした。
Live AI Hubは、複数のデータソースにまたがるクエリの実行を統合的に管理します。 また、対応している処理については、接続先のデータソース側で実行することもできます。これにより、分析担当者は、意思決定に必要な情報を1つのクエリ結果として取得できます。
さらに、分析担当者は、「取引金額は大きいものの、製品の利用状況が低い顧客は誰か?」「未現在進行中の商談のうち、未解決のサポート問題を抱えているものはどれか?」と新しい視点で分析を進めることができます。一度設定した接続とビューをそのまま活用できるため、新たなデータパイプラインを構築することなく、さまざまな観点からデータを分析できます。
接続先の認証情報とビューを使用したアクセス制御
分散したデータを接続して活用する際には、誰がどのデータにアクセスできるかを適切に管理することも重要です。Live AI Hubでは、リモート接続に使用する認証情報と、ローカル・ビューに設定するアクセス権限を組み合わせることで、データへのアクセスを制御できます。
接続先の認証情報によって、取得できるデータを制御。 データベース・リンクの認証情報は、接続先のデータベースで使用するアカウントを識別します。一方、HubSpotのOAuth認証情報は、認証されたアプリケーションと、そのアプリケーションに付与されたアクセス権限(スコープ)を表します。実際にアクセスできるデータは、それぞれの接続先で認証されたアカウントやアプリケーションに付与された権限によって決まります。また、チームごとに必要なアクセス権限が異なる場合は、個別の認証情報やプライベートなデータベース・リンクを使用して、アクセス範囲を分けることもできます。
ビューによって、ユーザーに公開するデータを制御。 ビューを使用すると、ユーザーに公開する列を必要なものだけに限定したり、承認された条件で行を絞り込んだりできます。また、詳細なレコードを直接公開する代わりに、集計結果だけを提供することも可能です。作成したビューに対して、適切なデータベース・ユーザーやロールにSELECT権限を付与することで、アクセスできるユーザーを制御できます。
AIプロファイルは、SQLを生成する際に必要なコンテキスト情報を提供します。 一方、実際のデータへのアクセスは、データベースに設定された権限と、リモート接続で使用する認証情報に付与された権限によって制御されます。つまり、AIプロファイルがSQLの生成を支援する一方で、データへのアクセス権限はデータベースと接続先のセキュリティ設定によって適切に管理されます。
この仕組みは、AIエージェントにも適用できます。AIエージェントには、必要な権限だけを付与したLive AI HubのユーザーIDで認証させ、利用を許可されたビューやクエリ・インタフェースを通じてデータにアクセスさせることができます。これにより、AIエージェントにも適切なアクセス制御を適用しながら、複数のデータソースにまたがる情報を安全に活用できます。
ビジネス上の疑問を起点にデータ分析を進める
Live AI Hubを使用すると、ビジネス上の疑問や課題を出発点として、接続された最新のデータを活用しながら分析を進めることができます。データへのアクセス権限、顧客データ間の関連付け、ビジネス上のデータの意味や定義をあらかじめ設定しておけば、分析担当者は、分析のたびに新しいデータパイプラインを構築する必要がありません。さまざまなデータを柔軟に組み合わせ、異なる視点から分析を行うことができます。
AIエージェントも、Live AI Hubを通じてアクセス権限を付与することで、同様に幅広いデータを活用できます。例えば、営業支援AIエージェントは、商談情報に加えて、顧客の購買履歴、最近の製品利用状況、未解決のサポート案件などを組み合わせて評価できます。これにより、なぜその顧客への対応を優先すべきなのか、あるいは商談を進める前にサポート部門への引き継ぎが必要なのかといった判断について、データに基づいた根拠を示すことができます。
Oracle Autonomous AI LakehouseのLive AI Hubを活用することで、データの収集や連携に必要なインフラの構築・管理にかかる手間を削減し、ビジネス上の重要な問いを考え、その答えを理解して意思決定に活かすことに、より多くの時間を使えるようになります。
関連資料
Autonomous AI Lakehouseの新機能で全データ資産にAIエージェントを活用する