※ 本記事は、Adrian Scottによる”Don’t build – articulate data pipelines with Autonomous AI Lakehouse“を翻訳したものです。
2026年10月29日
注釈、対話型AIアシスタント、画像ベクトルを使い、Autonomous AI Lakehouseでデータパイプラインを作成して問合せします。
欲しいパイプラインを言葉で伝え、生成データの意味をAIに記述させ、結果を自然言語で質問します。各段階が、次の段階の精度向上につながります。
メタデータが新たなボトルネックに
生成AIによって自然言語でデータベースに質問しやすくなりましたが、正しい答えを得ることまで容易になったわけではありません。SLS_FCTという表のAMT、QTY、STAT_CDという列を見ても、モデルは意味を推測するしかありません。誤って推測すると、実行できて数値も返すものの、気付かないうちに間違った結果になるSQLを生成する可能性があります。パイプラインを作るAIも同様で、データが何を表すかを理解してこそ、結合、絞り込み、集計を正しく行えます。
AI生成SQLとパイプラインの品質は、利用できるメタデータに大きく依存します。Autonomous AI Lakehouseのパイプライン作成機能Oracle Data Transformsは、相互に補強し合う3つのAI機能で対応します。
- 注釈: 表と列に業務上の意味を付け、データフローで引き継ぎ、新規テーブルの説明をAIで生成します。
- AIアシスタント: 会話での説明から、データフローとワークフローを作成、改善、実行します。
- 画像とテキストのベクトル埋め込み: 非構造化コンテンツを、同じパイプライン内で類似検索できるデータに変えます。
この記事では、他の機能の土台となる注釈から説明します。次にAIアシスタント、注釈とアシスタントの組み合わせによる自然言語クエリ(NL2SQL)の改善、画像ベクトルによって視覚データをパイプラインへ取り込む方法を紹介します。
記事全体を通じて、オンライン小売企業の1つの例を使用します。この企業は、どのカテゴリの商品が最も返品されるのか、その理由は何か、外見が似た商品に同じ問題があるかを知りたいと考えています。製品画像を含む製品カタログ、注文明細表、自由記述の返品理由を含む返品表を使用します。
Data Transformsを使う理由
Data TransformsはAutonomous AI Lakehouseに組み込まれており、インストールは不要です。アプリケーション、データベース、ファイル、オブジェクトストレージからのロード、ノーコードのデータフロー設計やSQLによる変換、ワークフローとしての編成、スケジュール、すべての実行の監視まで、1つのツールとコンソールで扱えます。変換はLakehouse内で実行するため、データを別エンジンへ取り出して戻すことはありません。
Oracle Fusion、NetSuite、SalesforceなどのSaaS、主要クラウドのウェアハウスとレイクハウス、Apache Icebergなどの公開形式にも接続します。ツールと受け渡しが減り、実行内容、失敗、その理由を一か所で確認できます。
以下のAI機能はその基盤を活用します。Data Transformsは各パイプラインのソース、出力先、来歴を把握しているため、業務メタデータの取得、伝播、生成に適しています。
1 注釈:自ら意味を説明するデータ
注釈とは
注釈(Annotation/アノテーション)はOracle AI Databaseの機能で、26aiと、19cのRelease Update 19.28以降で利用できます。表、列、ビュー、マテリアライズドビュー、索引に付ける名前で、任意の値を持たせられます。単一の自由記述コメントとは異なり、1つのオブジェクトに複数の注釈を付けられるため、表示名、説明、単位、同義語、利用上の注意を別々に記録できます。注釈はデータベース内に保存されるので、メタデータを読むすべてのツールが同じ定義を参照します。
ALTER TABLE order_lines MODIFY (
  amt ANNOTATIONS (
    ADD display     'Net sales amount',
    ADD description 'Line amount after discounts, before tax, in USD'
  )
);
Data Transformsの注釈
パイプライン全体で、次の注釈による情報拡充をサポートします。
- 取り込む: データエンティティの構造とともに表や列の注釈定義をインポートし、ソースの意味を引き継げます。
- 編集する: DDLを書かず、テーブル定義で作成、編集、削除できます。
- 伝える: 元列を出力列へ対応付ける際に注釈も引き継ぎ、
AMTの説明をNET_SALESの説明にできます。 - AIで生成する: 出力テーブルの注釈をAIで作成できます。
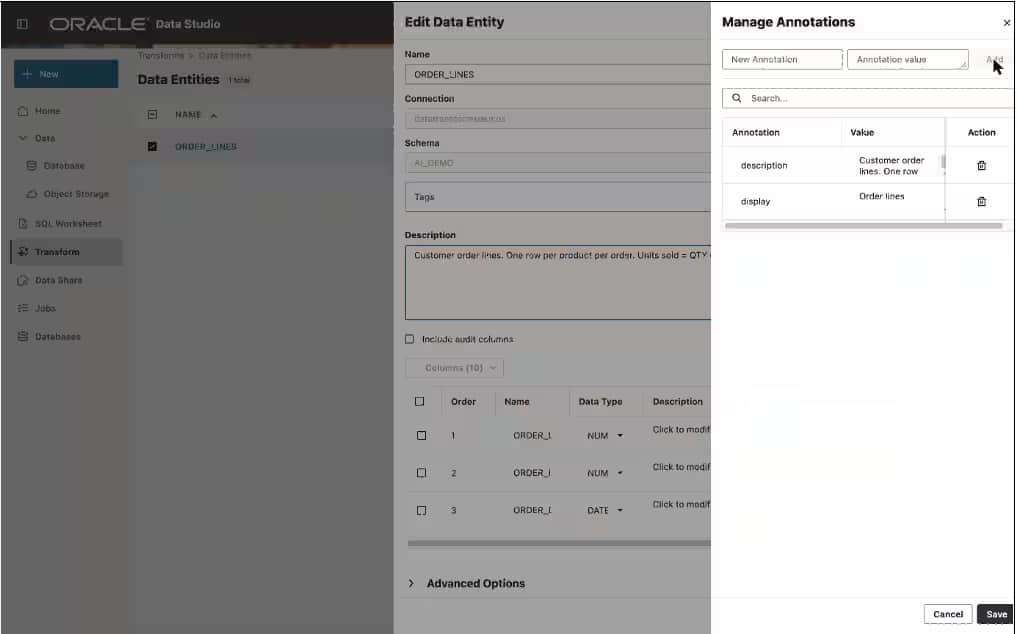
図1:データエンティティの列の注釈の表示と編集。
出力先にAI生成の注釈が必要な理由
出力先テーブルは、メタデータが失われやすい場所です。注文明細と返品を結合し、過去12か月に絞り、カテゴリ別の返品率を計算すると、新しいRETURNS_BY_CATEGORY表ができます。そこには、ソースには存在しない可能性のあるRETURN_RATE、RETURNED_UNITS、TOP_REASONといった列が生まれます。誰も説明を書かなければ、分析のために作った表ほどメタデータが乏しくなってしまいます。
データフロー自体には、すでにこれらの列の意味が含まれています。RETURN_RATEが12か月の期間でカテゴリ別に集計した返品数量÷販売数量であり、TOP_REASONが最も多い返品理由であることが分かります。生成注釈は、テーブル作成の時点で各列の導出方法を記録できるため、数か月後に誰かがパイプラインを逆解析する必要を減らします。
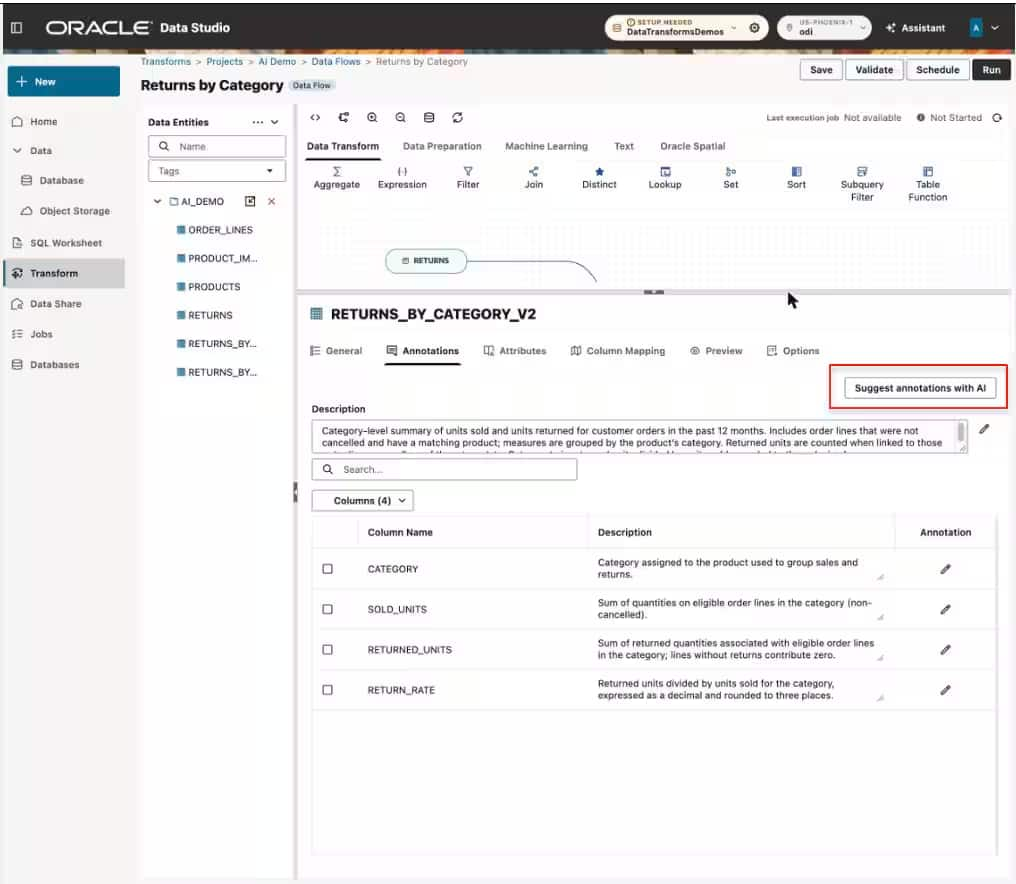
図2:データフローから導出した、出力テーブルのAI生成注釈。
2 AIアシスタント:パイプラインを説明し、設計を確認する
できること
Oracle AI Database Assistantの一部であるAIアシスタントは、自然言語でデータ統合を作成、実行します。目的を会話で説明すると、データフローやワークフローを作り、フィードバックに沿って修正し、実行できます。
Data StudioのホームページのAI Assistantカード、AI Assistantアイコン、またはヘッダーのAsk AIボックスから、サイドパネルを開きます。会話しながら、キャンバスに生成された設計を確認できます。変更は自動的に適用されるのではなく、事前に提案され、ユーザーが確認したうえで適用されます。利用するAIサービスを定義したAI Profileが必要で、Database Settingsで設定します。
会話で返品パイプラインを作る
小売企業では、次のように始められます。
ORDER_LINESとRETURNSを注文明細IDで結合し、過去12か月を対象に、製品カテゴリ別の返品率と返品数量を計算するデータフローを作って、RETURNS_BY_CATEGORYにロードしてください。
結合、フィルタ、集計、出力先がキャンバスに生成されます。同僚との仕事のように確認し、同じように会話で修正します。
カテゴリごとの最も多い返品理由も追加し、出荷前に取り消された注文を除外してください。
このフローを、注文ロード後に毎晩動くワークフローに入れてください。
生成されるのは、通常のData Transformsのデータフローとワークフローです。他のものと同様に、表示、編集、バージョン管理、スケジュールが可能です。アシスタントは初稿と反復修正を速めますが、完成したものは、内容を調べて変更できる透明なパイプラインとして残ります。
既存機能では、SQLを貼り付けると解析して同等のフローをキャンバスに生成できます。アシスタントはこの考え方をSQLから自然言語へ広げます。
3 相互作用:注釈がAIの各段階を改善する
注釈とアシスタントは単独でも有用ですが、組み合わせると、作成したパイプラインが次のパイプラインと出力へのクエリを改善する循環が生まれます。
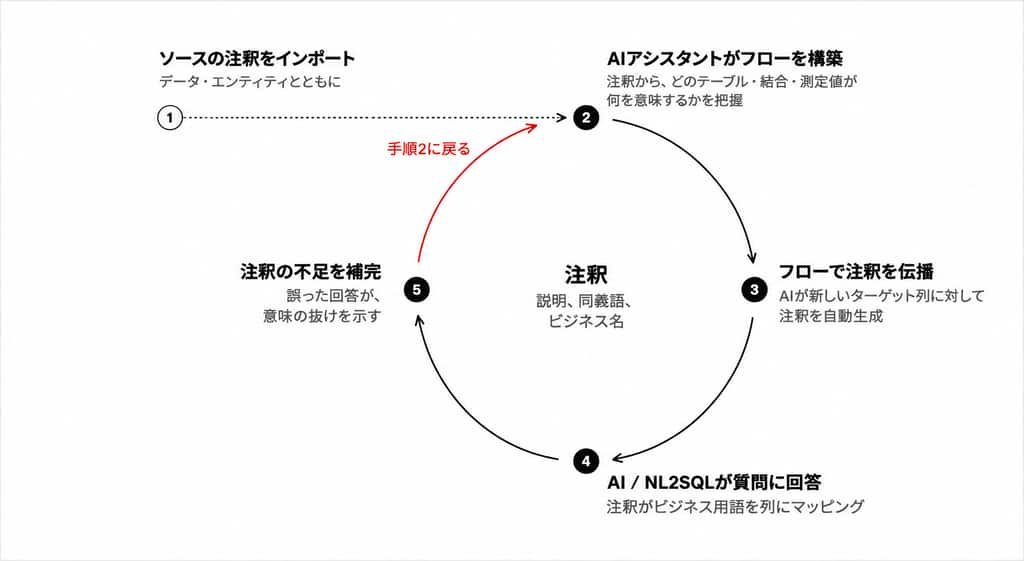
図3:良いメタデータが良いフローを生み、良いフローが良いメタデータを生みます。
良い注釈がフロー作成を助ける
アシスタントが「カテゴリ別の純売上を計算して」と依頼されると、どの列が純売上かを決める必要があります。AMTに「値引き後、税引き前の明細金額、米ドル」、GROSS_AMTに「定価×数量」と注釈があれば、選択は明確です。
注釈がなければ推測になります。どのキーで結合するか、どの状態コードが取消を意味するか、どの日付が出荷日ではなく注文日か、という判断にも同じことが当てはまります。
良いフローが良い注釈を生む
循環は逆方向にも働きます。AIでも人でも作成した各フローが、ソース側の注釈を伝え、新列の注釈を生成できます。パイプラインが増えるほど説明が充実し、派生テーブルだけ文書化が不足する状況を防げます。
良い注釈がNL2SQLの精度を高める
効果が表れるのは、誰かが質問したときです。Autonomous AI Lakehouseの自然言語SQL機能であるSelect AIは、スキーマメタデータを基に言語モデルへのプロンプトを作成します。AIプロファイルには、含める情報を制御する3つの属性があります。コメント、制約(結合方法を伝える主キーと外部キー)、注釈です。注釈を有効にすると、各表と列の業務上の意味が、質問とともに送信されます。
BEGIN
  DBMS_CLOUD_AI.CREATE_PROFILE(
    profile_name => 'RETAIL_NL2SQL',
    attributes   => '{"provider": "oci",
                      "credential_name": "OCI_CRED",
                      "object_list": [{"owner": "RETAIL", "name": "RETURNS_BY_CATEGORY"}],
                      "annotations": "true",
                      "comments": "true",
                      "constraints": "true"}');
END;
SQL WorksheetのGenerate SQL with AIダイアログやSelect AIで、次のように質問できます。
返品率が最も高い3カテゴリと、それぞれの最も多い返品理由は何ですか。
RETURN_RATEとTOP_REASONにはフローが作成した時点で注釈があるため、モデルは、RETURN_RATEがすでに比率であり合計すべきでないこと、TOP_REASONが報告する理由であることを理解できます。Oracleが公開した小さな例では、分かりにくい列名だけで注釈がないと、Select AIは列を誤認し、誤ったディメンションで集計し、有効な質問に空の結果を返しました。注釈を追加すると、同じ質問に正しい答えが返りました。
取り込み、伝播、生成というパイプラインでの作業が、最終的な自然言語操作を信頼しやすくします。注釈は、単に情報を記録するためのものではなく、AIを活用したクエリツールが処理を行ううえで欠かせない入力情報です。
4 画像のベクトル埋め込み
ベクトル埋め込みとは
小売企業のデータすべてが、行と列に収まるわけではありません。製品カタログには写真があり、返品テーブルには自由記述の理由があります。ベクトル埋め込みにより、このコンテンツを意味を表す数値ベクトルに変換します。似た画像や文章はベクトル空間で近くに配置され、類似検索で見つけられるようになります。
データフローのText Embedding VectorとImage Embedding Vector演算子が対応します。Data FlowエディタのDatabase Functions と Machine Learningにあり、どちらもOCI Generative AIを呼び出します。
使い方
- OCI資格証明と埋め込みモデルの推論エンドポイントで、OCI Generative AI接続を作成します。
- 画像ソースの後にImage Embedding Vectorを追加します。画像はBLOBでも、OCI Object Storageのファイル参照列でも構いません。後者では取得用のObject Storage接続を選びます。
cohere.embed-v4.0やCohereの画像埋め込みv3モデルを選び、画像列をinput_imageへ対応付けます。- 出力先へロードします。各行には、Lakehouseテーブル内に
VECTOR型のVECTOR_EMBEDDING列が付きます。名前は変更可能です。
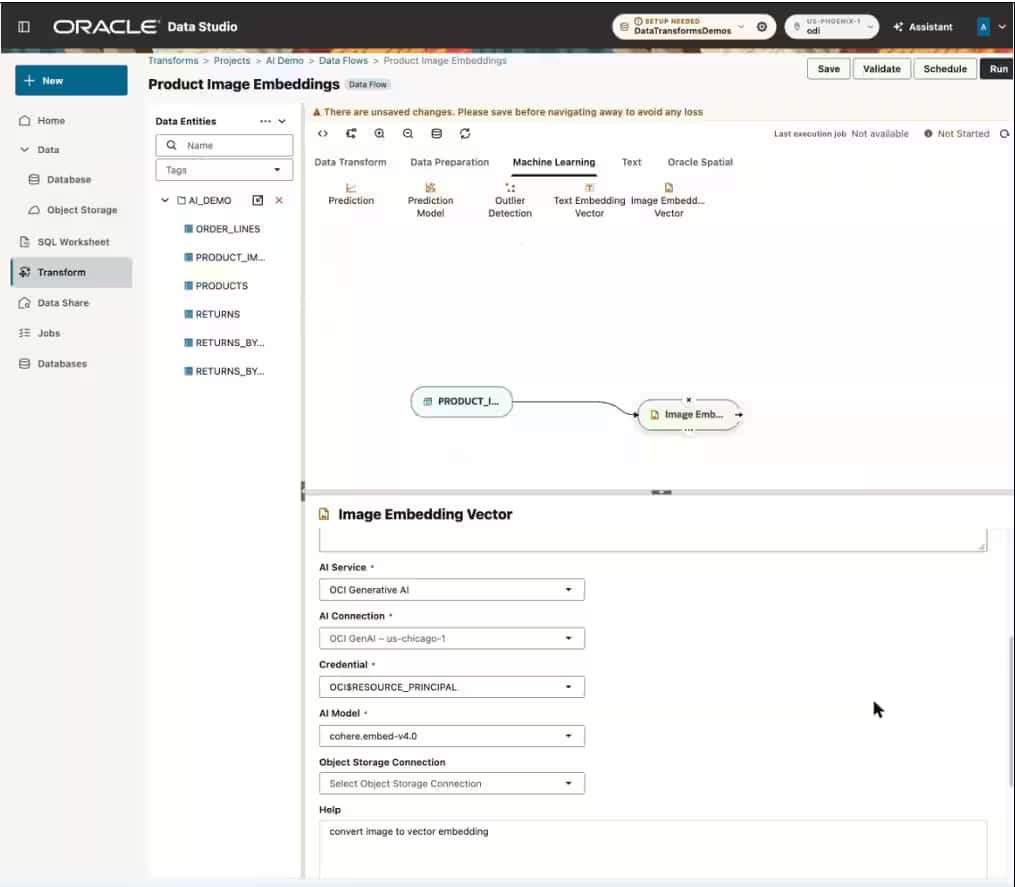
図4:データフローでの画像の埋め込みを生成
重要な理由
埋め込みをパイプライン内で生成するため、カタログと足並みをそろえられます。新製品には次の定期実行でベクトルが生成され、別のMLサービスを運用する必要はありません。ベクトルが関係データと一緒に保存されるため、類似検索と通常のSQLを組み合わせられます。この小売企業なら、返品率が最も高い商品に外見が似ている商品を、次のように見つけられます。
SELECT p.product_name, r.return_rate
FROM   product_image_vectors p
JOIN   returns_by_product r ON r.product_id = p.product_id
ORDER  BY VECTOR_DISTANCE(
         p.vector_embedding,
         (SELECT vector_embedding FROM product_image_vectors
          WHERE product_id = :most_returned_product),
         COSINE)
FETCH FIRST 10 ROWS ONLY;
視覚的な類似性は、構造化データだけでは分からないことを説明できます。外見が似た商品は、仕入先、素材、サイズの傾向を共有し、同じ返品問題を持っている可能性があります。ほかにも、製品カタログの重複検出、画像検索、推薦に利用できます。テキスト埋め込み演算子は返品理由でも同様に働き、「小さめ」「きつすぎる」「一つ大きいサイズを注文」といった、共通の語がなくても意味が近い理由をまとめられます。
ベクトル列にも注釈が有用です。生成モデルと元列を記録すると、別モデルのベクトルを誤比較するのを防ぎ、AIに列の意味を伝えられます。
全体を組み合わせる
Data Transformsのパイプラインでは、各段階でAIを活用できます。AIアシスタントは、説明を、確認して変更できる動作するデータフローとワークフローに変えます。注釈はソースからフロー全体へ業務上の意味を伝え、フローが作成する列の説明をAIが補います。埋め込み演算子は、画像とテキストを構造化データと同じパイプラインに取り込みます。結果に対する自然言語クエリは、依存するメタデータが途中で整備されるため、より正確になる可能性があります。
別のメタデータツール、AIサービス連携、ベクトルパイプラインを追加する必要はありません。すべて組み込みのパイプライン作成機能に含まれます。
注釈を後付けでなくパイプラインの一部として扱い、ソースと一緒に取り込み、フローで伝播、生成し、Select AIプロファイルで有効にしてください。追加の文脈は下流の各AI機能に役立ちます。
datastudio.oracle.comで、Oracle Autonomous AI Lakehouseのパイプライン作成を始めてください。