※ 本記事は、Vishal Dhimanによる”Bundles Demystified: A Practical Path to Oracle AI Data Platform Infrastructure as Code (IaC)“を翻訳したものです。
2026年11月1日
開発環境で動く顧客離反予測の学習ワークフローは、QA環境や本番環境でも問題なく動くべきです。ノートブックとワークフローのロジックは同じでも、必要なコンピュート容量は異なる場合があります。環境ごとにワークフローを作り直す必要があるのでしょうか。
Oracle AI Data PlatformのワークベンチにあるBundlesを使えば、1つまたは複数のワークフローやエージェントを一度パッケージ化し、環境ごとの違いを定義して、さまざまな環境へ円滑に展開できます。Bundleは、あらかじめ決められた構造を持ち、中身を確認できるフォルダーです。ワークスペース内のどこにでも作成でき、Gitで管理する親フォルダーの下に置けば、チームでのレビューやバージョン管理も行えます。
これは、Infrastructure as Code(IaC:インフラストラクチャの構成をコードで管理する方法)を実践するための手段です。リソース定義と環境設定をファイルとして管理し、Bundlesの画面、CLI、AIプラグインからパッケージを公開します。最初からすべての定義を手書きする必要はありません。
この記事では、典型的な顧客離反予測のワークフローを例に、開発環境とQA環境では小さいコンピュートを使い、本番環境では承認済みの大きなコンピュートを再利用する、一般的な使い方を説明します。そのほかの例も紹介します。以下の図に、顧客離反予測のユースケースを示します。
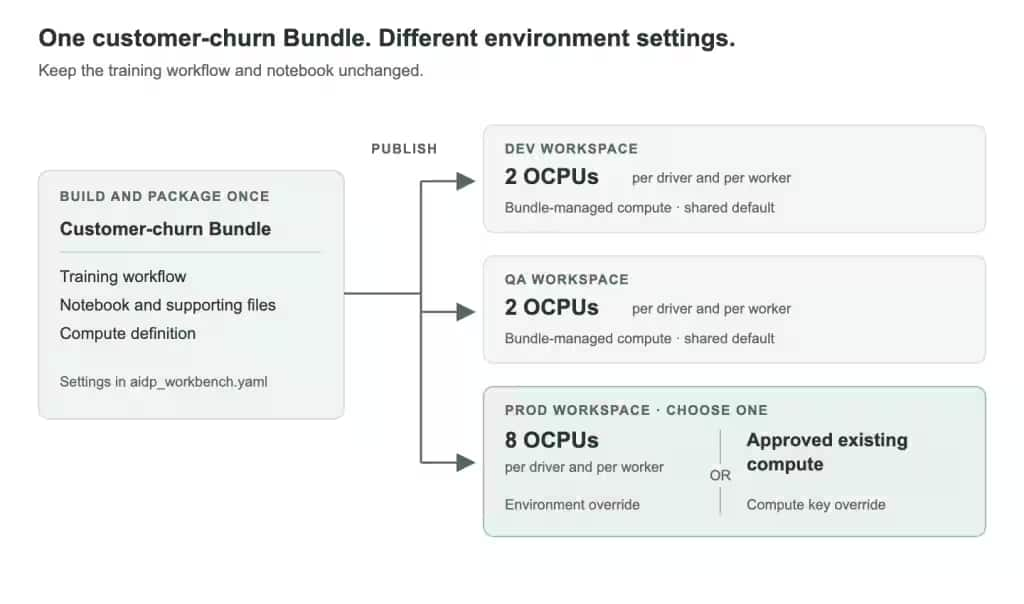
1つのBundleに、環境別の設定を用意します。本番環境の2つの選択肢は代替案であり、2つのリソースを両方作成するという意味ではありません。
Bundleの中身
顧客離反予測の例を詳しく見る前に、まずBundleとは何かを確認しましょう。Bundleは、決められた構造を持つフォルダーであり、特別なバイナリパッケージではありません。YAMLファイルとJSONファイルが公開するリソースを記述し、アーティファクトには、そのリソースが使うコードや補助ファイルが含まれます。したがって、公開の単位は個々のノートブックやファイルではなく、Bundleフォルダー全体です。
Bundleの内容は、4つの異なる役割に分かれます。
| Bundleの構成要素 | 格納場所 | 記述する内容 |
|---|---|---|
| マニフェスト | aidp_workbench.yaml | Bundleに名前を付け、ワークフロージョブやエージェントを列挙し、共通設定と環境別設定を保持します。 |
| リソース記述ファイル | jobs/またはagentflows/ | 公開するリソースを定義します。ワークフロージョブの記述ファイルは、タスク、ノートブックのパス、パラメータ、コンピュートへの参照を記述します。エージェントの記述ファイルは、エージェント定義と設定を保持します。 |
| 依存リソースの記述ファイル | 例:jobs/dependencies/ | パッケージ内のジョブやエージェントが必要とするリソースを定義します。コンピュートの記述ファイルには、シェイプ、OCPU数、メモリ、ワーカー数などを記録します。リソース記述ファイルは、設定を重複して書かずに、この依存リソースを参照します。 |
| アーティファクト | artifacts/ | パッケージ内のリソースが参照するノートブック、スクリプト、ライブラリなどのファイルを格納します。公開されたリソースは、実行時にこれらのファイルを使用します。 |
これらのファイルを合わせると、何を公開するか、何が必要か、どの設定が環境によって変わるかという3つの実用的な問いに答えられます。エディタで内容を確認、編集でき、構成ファイルを通じて環境ごとの設定の違いを管理できます。
最小限のBundleフォルダーから始める
ワークフロージョブやエージェントを公開するBundleに最低限必要なのは、最上位のaidp_workbench.yaml、列挙した各リソースの完全な記述ファイル、それらが必要とするアーティファクトと依存リソースの定義です。すべてのBundleにすべてのディレクトリが必要なわけではありません。アーティファクトや同梱する依存リソースは、リソースが参照するものだけを含めてください。
コンピュートを同梱した一般的なノートブックワークフローでは、Bundleフォルダーは次の構造になります。
example_bundle/
   aidp_workbench.yaml
   artifacts/
     notebooks/
       example_notebook.ipynb
   jobs/
     example_workflow.job.json
     dependencies/
       test.compute.json
同じ構造は、AI Data Platformの画面でも確認できます。
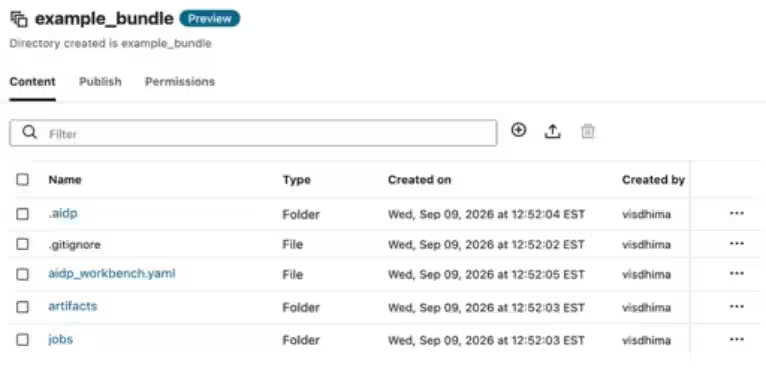
最小限のBundleを手作業で作成する場合、.aidpも.gitignoreも必須ではありません。ワークベンチは、Syncなどの操作のために.aidpメタデータを生成します。.gitignoreが関係するのは、Gitを使う場合だけです。
ファイルの内容: aidp_workbench.yaml
bundle: name: example_bundle resources: jobs: - example_workflow defaults: publish: path: "/Workspace/Shared/example_bundle" overwrite_publish_artifacts: false preserve_resource_name: false resource_name_prefix: "${bundle.name}_"ここで、resources.jobsのエントリは、*jobs/example_workflow.job.json*に対応します。この記述ファイルは、ワークフローのノートブックタスクを定義し、公開先のパスを通じてartifacts/notebooks/example_notebook.ipynbを参照します。さらに、${jobs.dependencies.test.compute.key}を使って、jobs/dependencies/test.compute.jsonで定義されたコンピュートを参照します。ノートブック自体には、任意のPythonコードを記述できます。
上のマニフェストは、初期設定であって、Bundle全体ではありません。ジョブとコンピュートの記述ファイルにも、それぞれ必須のフィールドが必要です。生成された記述ファイルを、不完全なコード断片で置き換えるのではなく、スキーマの動作例として利用してください。
ユースケース1:環境ごとにコンピュートのサイズを変える
構造を理解したところで、顧客離反予測の例に戻ります。生成されたBundleの名前がcustomer_churn_bundle、ワークフローがtrain_churn_model、コンピュートの依存リソースがtraining_computeであるとします。生成された定義は残してください。以下のコード断片は、ファイル全体の置き換えではなく、設定変更の部分だけを示しています。
開発中、チームは小さなワークロードで変更をテストします。QAでは、リリース前にワークフローを検証します。本番環境では、より大きなコンピュート容量が必要です。3つのワークフロー定義を保守する代わりに、環境ごとに値が変わる名前付き変数をBundleに用意します。
ここでいう「環境変数」は、ノートブック内のOSの環境変数ではなく、公開時に値が決まるBundleの変数です。以下のように、構成用YAMLに値を定義し、JSONから参照し、展開先の環境に応じて適切な設定値が使われるようにします。
生成済みのbundle、resources、publishの設定を残した、aidp_workbench.yamlの内容です。
defaults:
  variables:
    compute_ocpus: 2
    job_compute_key: "${jobs.dependencies.training_compute.compute.key}"

targets:
  dev:
    - aidp_ocid: "<dev_aidp_ocid>"
      workspace_key: "<dev_workspace_key>"
  qa:
    - aidp_ocid: "<qa_aidp_ocid>"
      workspace_key: "<qa_workspace_key>"
  prod:
    - aidp_ocid: "<prod_aidp_ocid>"
      workspace_key: "<prod_workspace_key>"
      variables:
compute_ocpus: 8名前付きの各環境には、aidp_ocidとworkspace_keyの両方を含める必要があります。この2つを組み合わせて、値の適用先となるAIDPインスタンスと展開先ワークスペースを識別します。プレースホルダーは、使用する環境の識別子に置き換えてください。この例では、DevとQAはデフォルト値の2を継承し、本番環境は8で上書きします。job_compute_keyは、同梱されたコンピュート依存リソースを指しており、2つ目の例で使用します。
jobs/dependencies/training_compute.compute.jsonで、固定のOCPU値を変数参照に置き換えます。以下は関連する設定部分だけを示しているため、JSON構成ファイル内の、その他の生成済みフィールドは残す必要があります。
{ "driverConfig": { "driverShapeConfig": { "ocpus": "${var.compute_ocpus}" } }, "workerConfig": { "workerShapeConfig": { "ocpus": "${var.compute_ocpus}" } } }同じ定義から、異なるコンピュートサイズが得られるようになります。
| 公開先 | ドライバーと各ワーカーのOCPU数 | 値の取得元 |
|---|---|---|
| Dev | 2 | 共通のデフォルト値 |
| QA | 2 | 共通のデフォルト値 |
| Prod | 8 | 本番環境での上書き |
同様に、必要に応じて、シェイプ、メモリ、ワーカーの設定を、選択した容量と整合させられます。ジョブが同梱されたコンピュート依存リソースを参照していれば、公開時に展開先ワークスペースへそのコンピュートを作成できます。ノートブックと学習ロジックは変更しません。
公開時には、各名前付き変数の値が、overrides(個別上書き) > environment(環境別設定) > defaults(デフォルト設定)の優先順位で決まります。つまり、その変数を定義している最も優先度の高い階層の値を使います。ある階層に定義がなければ、次の階層を参照します。
Defaultsは、aidp_workbench.yamlのdefaults.variablesにある共通値です。前述のように、Environmentの値は、展開先のaidp_ocidとworkspace_keyに一致するターゲットエントリ内のvariablesブロックから取得し、同じ変数のデフォルト値を置き換えられます。Overridesは、Bundleのローカルな.aidp/overrides.yaml内のvariablesブロックから取得し、両方より優先されます。すべてのデフォルト値を繰り返し書く必要はなく、変更する変数だけを指定します。
たとえば、ローカルの上書き設定でcompute_ocpus: 4を指定すると、本番環境への公開時でも、${var.compute_ocpus}の値は4になります。その上書きを削除すると、本番環境では環境別の値である8を使います。DevとQAは異なる値を定義していないため、デフォルト値の2を使います。いずれの場合も、JSON内の参照は同じです。一時的な値が意図せず優先されないよう、公開前にローカルの上書き設定を確認してください。変数の一般的な仕組みについては、Bundle変数のドキュメントをご覧ください。
ユースケース2:承認済みの本番用コンピュートを再利用する
次に、本番環境のプラットフォームチームが、適切なコンピュートリソースをすでに提供しているとします。ワークフローでは、同梱されたコンピュート依存リソースを新しく作成せず、その既存リソースを使うべきです。この選択も、設定で行えます。
まず、jobs/train_churn_model.job.jsonで、この依存リソースに対する各コンピュート参照を"clusterKey": "${var.job_compute_key}"に設定します。ジョブレベルのjobClustersエントリと、該当タスクのclusterエントリの両方がある場合は、どちらも更新します。これにより、ワークフローは前の例で定義した名前付きの値を使用します。
デフォルトでは、その値は同梱されたトレーニング用コンピュートの依存リソースを参照します。既存のコンピュートを再利用するには、本番ワークスペース内のBundleフォルダーにある .aidp/aidp_workbench.yaml に、そのキーを設定します。
prod:
    - aidp_ocid: "<prod_aidp_ocid>"
      workspace_key: "<prod_workspace_key>"
      variables:
         job_compute_key: "<existing_production_compute_key>"
このワークフローでは、指定したキーが同梱の依存リソースへの参照を置き換えるため、新たにその依存リソースを作成する代わりに、既存リソースが使用されます。選択したコンピュートクラスタをワークフローが使う権限を持つことを、必ず確認してください。
公開するアーティファクトとリソース名の設定
Bundlesでは、公開するリソースの名前も自由にカスタマイズできます。同じ顧客離反予測のBundleを使い、公開後のワークフロー名を確認します。前の例の変数とターゲット識別子を残したうえで、aidp_workbench.yamlを次のように設定するとします。これらの設定はvariablesではなく、publishの下に定義することに注意してください。
defaults: publish: path: "/Workspace/Shared/customer_churn_bundle" overwrite_publish_artifacts: false preserve_resource_name: false resource_name_prefix: "${bundle.name}_" targets: prod: - aidp_ocid: "<prod_aidp_ocid>" workspace_key: "<prod_workspace_key>" publish: path: "/Workspace/Production/customer_churn_bundle" overwrite_publish_artifacts: true resource_name_suffix: "_prod"次の表では、組み込みの公開設定と、テンプレートのプレースホルダーを説明します。どちらもvariablesの下に宣言する必要はありません。表には、これらの暗黙的な変数を示しています。
| 設定またはプレースホルダー | デフォルト値 | 説明 | 設定値の例 |
|---|---|---|---|
| path | /Workspace/Shared/<bundle_name> | 公開先のルート。ファイルは、その下のartifactsサブフォルダーに配置されます。${publish.path}で参照します。 | “/Workspace/Shared/churn” |
| overwrite_publish_artifacts | false | アーティファクトの内容の置き換えを許可します。falseでも、同じBundleが管理するアーティファクトは更新できます。 | 意図して置き換える場合はtrue。 |
| preserve_resource_name | true | 元のワークフロー名を保持します。falseの場合は、接頭辞、接尾辞、または両方を設定します。 | 各ワークフローの名前をカスタマイズする場合はfalse。 |
| resource_name_prefix | 名前を保持する場合は未設定。 | 記述ファイルの接頭辞トークンの位置に文字列を追加します。名前の保持がtrueの場合は省略します。 | “${bundle.name}_” |
| resource_name_suffix | 名前を保持する場合は未設定。 | 記述ファイルの接尾辞トークンの位置に文字列を追加します。名前の保持がtrueの場合は省略します。 | “_prod” |
| ${bundle.name} | bundle.nameから取得。 | 接頭辞と接尾辞で使用できる、組み込みのBundle名プレースホルダー。 | bundle.name: churnの場合はchurn。 |
| ${bundle.uuid} | プラットフォームが割り当てるBundle識別子。 | 接頭辞と接尾辞で使用できる、組み込みの一意な識別子。 | 接尾辞として“_${bundle.uuid}”。 |
この例では、新しいBundleの名前に関するデフォルト設定をpreserve_resource_name: falseに変更します。既存のBundleや移行されたBundleには異なる名前設定が残っている場合があるため、次の節のように接頭辞、接尾辞、独自の命名方法を追加して、ワークフロー名を指定する必要があります。
ワークフロー名に接頭辞と接尾辞を付ける方法
jobs/train_churn_model.job.jsonで、記述ファイルの他の部分は残したまま、nameフィールドを次のようにします。
{
  "name":  "${publish.resource_name_prefix}train_churn_model${publish.resource_name_suffix}"
}
本番環境のcustomer_churn_bundleでは、解決後の名前はcustomer_churn_bundle_train_churn_model_prodになります。接頭辞トークンだけを残すとcustomer_churn_bundle_train_churn_model、接尾辞トークンだけを残すとtrain_churn_model_prodになります。
1つのワークフローに固定の名前を使う
下流のシステム連携がcustomer_churn_trainingという名前を期待している場合は、同じ記述ファイルのフィールドを、固定の名前に置き換えます。
{ "name": "customer_churn_training" }どちらのトークンもなければ、他のリソースが設定済みの接頭辞と接尾辞を使っていても、このワークフローは固定名を維持します。名前はリソースの命名規則に従い、展開先ワークスペース内の無関係なリソースと競合しない必要があります。Sync機能は、記述ファイルの標準の接頭辞トークンと接尾辞トークンを再生成する場合があります。その後、個別の名前のカスタマイズを確認し、再適用してください。
すべてのリソースで記述ファイル内の名前を保持するには、aidp_workbench.yamlで次の公開設定を使い、該当する構成から接頭辞と接尾辞の設定を削除します。
defaults: publish: preserve_resource_name: true公開設定は、環境ごとのpublishブロックや、.aidp/overrides.yamlの最上位のpublishブロックにも指定できます。優先順位は、overrides > environment > defaultsです。
アーティファクトを上書きするタイミングを選ぶ
preserve_resource_name: falseの場合、公開先に、そのBundleが所有しないアーティファクトのデータがすでにあると、公開が失敗することがあります。ただし、そのBundleがすでに管理するアーティファクトの更新は妨げません。設定した公開先のアーティファクト内容を、意図して置き換える場合はtrueを使用します。本番環境の例では、これらのファイルは/Workspace/Production/customer_churn_bundle/artifactsの下にあります。公開先ルートの下でartifactsと並んでいる他のファイルやフォルダーは保持されます。置き換えられるアーティファクト内の手動編集が失われる可能性があるため、上書きを有効にする前に公開先を確認してください。
ユースケース3:コンピュートを後で設定するため、自動作成を無効にする
コンピュートクラスタを作成せずに、すべてのワークフローやエージェントを移行したい場合があります。たとえば、ワークフローだけを先に公開し、後からコンピュートクラスタを作成して関連付けたい場合です。
この場合は、デフォルト設定または展開先ワークスペースで、たとえばjob_compute_keyという変数を作成し、次のような任意の文字列を値に指定します。
# Define in overrides or default or target workspace variables: job_compute_key: "select_compute"次に、*.job.jsonファイルで、コンピュートキーがこの変数を使うように変更します。
"clusterKey": "${var.job_compute_key}"このBundleを公開すると、すべてのワークフローとエージェントは表示されますが、クラスタの関連付けには「select_compute」という文字列だけが表示されます。したがって、ワークフローやエージェントを実行する前に、必ずコンピュートクラスタを関連付けてから実行する必要があります。
環境変数の一般的な使い方
Bundle変数は、ワークフロージョブやエージェントのロジックを同じにしたまま、展開先ごとに変えるのが適切な値に使用します。一般的な例は、次のとおりです。
| ユースケース | Dev / QA / Prodでの典型的な値 | 変数を使用する場所 |
|---|---|---|
| コンピュート容量 | 2 / 4 / 8 OCPU | コンピュート依存リソースの記述ファイル |
| データの出力先 | CHURN_DEV / CHURN_QA / CHURN | ジョブまたはノートブックのパラメータ |
| 入力データセットの量 | 小さなサンプル / QA用の大きめのサンプル / 本番の全データ | ジョブまたはノートブックのパラメータ |
| 実行時の動作 | デバッグログ / 標準ログ / より厳格な再試行とタイムアウト | サポート対象のジョブタスクのフィールドまたはパラメータ |
| エージェントの文脈と応答スタイル | 新規契約者 / 最近更新した契約者 / 離反リスクのある高価値契約者 | サポート対象のエージェントのプロンプトまたはツールのフィールド |
| 資格証明への参照 | 展開先のCredential Storeのエントリとキー | サポート対象のエージェントのHTTPツールまたはMCPツールのフィールド |
Databricks利用者向けのBundlesの比較
Databricks Declarative Automation Bundlesも、カタログやスキーマの選択、既存コンピュートへのジョブの接続、環境別のジョブのデフォルト値の設定といった、同様の課題にカスタム変数とターゲット単位の上書きを使います。そのドキュメントでは、公開時の設定にはBundle変数を、実行ごとに変わる値にはジョブパラメータを使うという、有用な区別も示しています。そのモデルに慣れた開発者には、Databricksの変数ガイドとジョブパラメータのガイドが参考になります。
対応するAIDP Bundleのパターンは、次のとおりです。
| Databricksで使い慣れたパターン | AIDP Bundleでの対応方法 |
|---|---|
| デフォルト変数を定義し、targets.devまたはtargets.prodの下で上書きする | defaults.variablesの下に値を定義します。targets.<name>の下にaidp_ocidとworkspace_keyの両方を持つリストエントリを追加し、そのエントリのvariablesマッピングに上書きする値を置きます。 |
| ジョブパラメータのデフォルト値として${var.catalog}を使う | 生成されたワークフロージョブの記述ファイルで、${var.target_schema}などの名前付き変数を使います。 |
| あるターゲットで、タスクに既存のクラスタIDを指定する | .aidp/overrides.yamlでjob_compute_keyを上書きし、同梱された依存リソースを作成する代わりに、展開先の既存コンピュートをジョブが使うようにします。 |
| ジョブ実行時に処理日やソーステーブルを渡す | ワークフロージョブのパラメータを定義し、ジョブの実行時に値を渡します。必要に応じて、ターゲット固有のデフォルト値をBundleに保持します。 |
| 公開前に、値が解決された設定を確認する | CLIの公開コマンドを実行する前に、生成されたAIDP Bundleフォルダーと、選択したターゲットまたはローカルの上書き設定を確認します。 |
設定形式とコマンドは異なるため、DatabricksのBundleファイルをAIDPにそのままコピーしないでください。引き継げるのは考え方です。リソース定義は安定させ、ターゲットごとの差は宣言した変数にまとめ、本当に実行ごとに変わる値には実行パラメータを使います。
1つの設定変更から始める
Bundlesを使う前に、すべてのファイルや設定を学ぶ必要はありません。動作するワークフローから始め、画面でBundleを生成し、コンピュートサイズをパラメータ化して、QAに公開します。本番で既存コンピュートが必要なら、そのキーを指定します。エージェントをパッケージ化するBundleにも、同じ方法が使えます。
基本となる考え方は単純です。アプリケーションのロジックをひとまとめにし、環境の違いを設定として表し、同じパッケージを必要な実行先へ公開します。
小さな実務上の変更で、信頼性を大きく改善する
Bundlesは、AIチームとデータチームに、「自分のワークスペースでは動く」という状態から、レビュー済みで繰り返し実行できる展開手順へ移行する方法を提供します。しかも、取り組みやすい仕組みです。選択したワークフロージョブとエージェントから、中身を確認できるフォルダーが生成され、開発者は画面またはAIDP CLIで管理できます。環境変数によって、1つのパッケージをさまざまな環境に持ち運べるようになります。
詳細情報: