
※ 本記事は、Jameson Whiteによる”Connect your Autonomous AI Lakehouse to multicloud data sources using Oracle Data Studio“を翻訳したものです。
2026年10月29日
Bogotáのデータ・アーキテクトであるLucíaが、レイクハウス・ソースに接続し、Oracle AI Data Catalogでアシスタントを使用してデータを検出する様子をご覧ください。
Lucíaは、ラテンアメリカ全域でスポーツ用品小売業者の業務をサポートしています。彼女の次の分析には、異なるデータ環境に保持されている店舗売上、オンライン・カートのアクティビティ、および在庫が必要です。
Oracle Data Studioは、Lucíaにデータベース・インスタンスと接続済みカタログ全体で単一のUIを提供します。ユーザーは、UIまたはAssistantを通じてそのフットプリントを拡張および管理し、データ検出、SQL開発、分析を1つのワークスペースに維持できます。彼女は、Oracle AI Data Catalogのcatalogo_comercioにあるカート表から始めます。

ソースをまとめる
ワークスペースは、Databricks Unity Catalog、Oracle AI Data Catalog、AWS Glue、およびOCI Object Storageへの接続をサポートしています。Lucía の例では、次の表レイアウトを使用します:
| ソースまたはアクセス・パス | サンプル表 | 貢献 (Contribution) |
|---|---|---|
| Databricks Unity Catalog | STORE_SALES_TRANSACTIONS, PRODUCTS | 売上および製品参照データを格納します。 |
Oracle AI Data Catalog: catalogo_comercio | SHOPPING_CART_SESSIONS, SHOPPING_CART_LINE_ITEMS | カート・アクティビティおよび各セッションで選択されたストアのIceberg表。 |
OCI Object Storage bucket: lagodedatos-fuentes | STORE_INVENTORY | 在庫数量および納期回答可能数量を格納します。 |
| AWS Glue Data Catalog | SUPPLIER_STOCK | 製品レベルの可用性に関する登録済サプライヤ在庫データ。 |
| Local database | STORE_LOCATIONS | 参照データを格納します。 |
各接続により、チームは分析の異なる部分にアクセスできます。カタログ接続は登録済表を識別します。それらの基礎となるストレージへのアクセスも必要です。
Oracleは、外部カタログ・アクセス、AWS GlueおよびOracle AI Data Catalogのマウント、ならびに対象となるDatabricks表のUnity Catalog例を文書化しています。Oracle AI Data CatalogはIcebergメタデータを提供し、登録済み表のデータ・ファイルは設定されたストレージ内に残ります。
Autonomous AI Lakehouse Databaseの作成
Lucía は、小売企業のデータ・プラットフォーム全体で、顧客の関心と在庫可用性を結び付ける必要があります。Autonomous AI Lakehouseは、既存のカタログおよび対象となるIceberg表を使用して、サポートされているレイクハウス・データをローカルのビジネス・データとともに分析するためのSQL環境を彼女のチームに提供します。彼女は、その分析を開発および実行するためにLAGODEDATOSをプロビジョニングし、チームがレビューして再利用できるSQLの生成にAI支援を活用します。
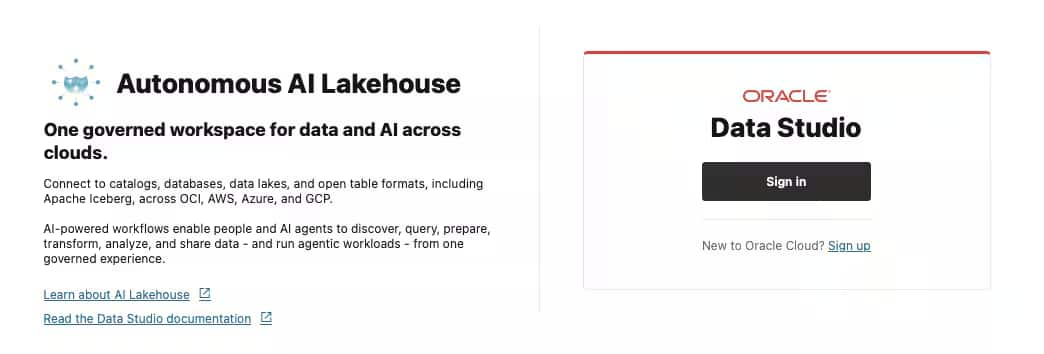
Lucíaがワークスペースを開き、サインインします。
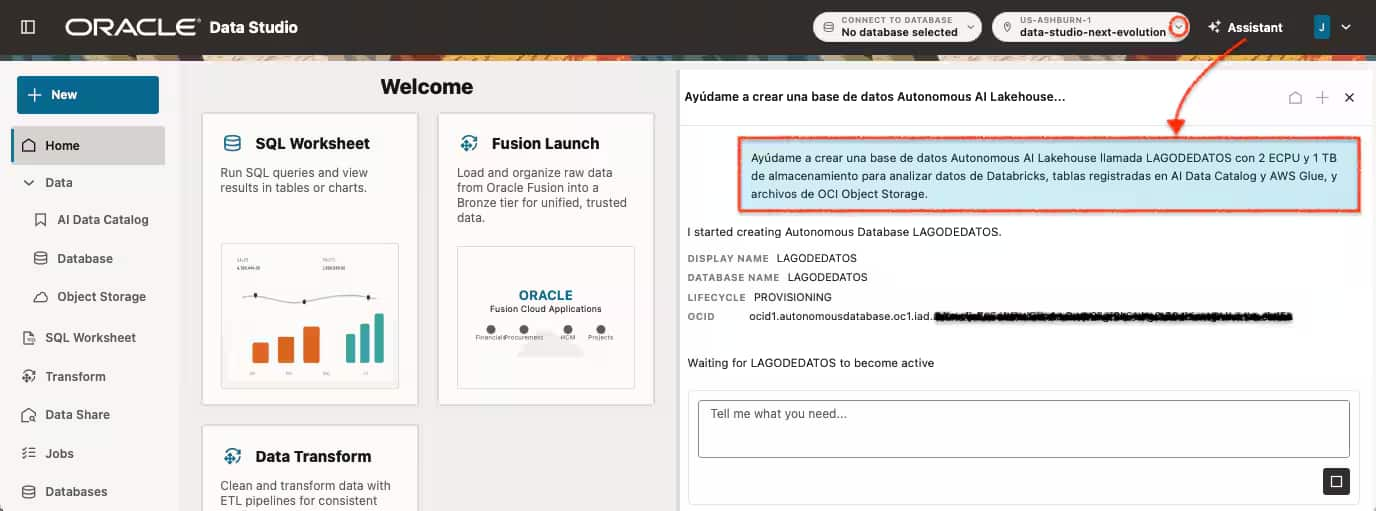
彼女はAutonomous AI Lakehouse Databaseのプロビジョニング・リクエストを開始します:
Databricksデータ、AI Data CatalogおよびAWS Glueに登録された表、OCI Object Storage内のファイルを分析するために、2 ECPUと1 TBのストレージを備えたLAGODEDATOSという名前のAutonomous AI Lakehouse Databaseの作成を支援してください。
文書化されたアシスタントのプロビジョニング手順に従います。生成された作成フォームを確認し、管理者パスワードを入力して設定を確認し、作成を確定します。Lakehouseワークロードと、要求されたコンピュートおよびストレージの割当てを確認します。ここで使用している2つのECPUおよび1 TBは、コンピュート・モデルでサポートされる設定例であり、小売業者のワークロードのサイジング評価ではありません。
環境が使用可能になると、彼女はcatalogo_comercioおよびlagodedatos-fuentesバケットをDatabricksとAWS Glueのソースとともに接続し、その後カタログ・インタフェースを通じて表を検査します。ソース名は表示されたままになるため、チームは各データセットの出所を識別できます。
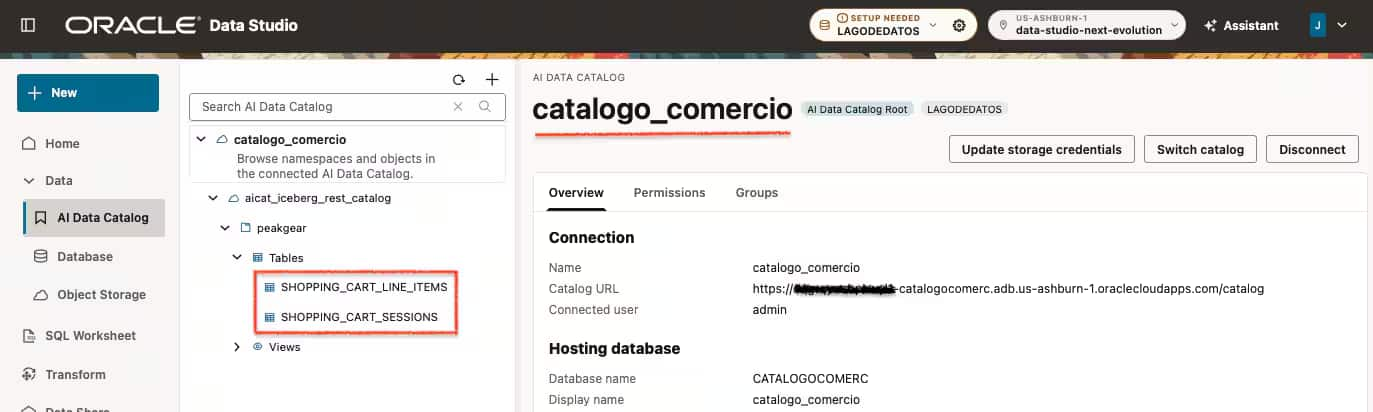
AI Data Catalogに接続
「AI Data Catalogの作成および接続」に従って、Data Studioを既存のAI Data Catalog (catalogo_comercio)に接続します。必要に応じてカタログの資格証明を指定し、接続先データベースがそのカタログを使用するように構成されていることを確認します。カタログ内で、ユーザーは使用可能な名前空間間を移動し、登録済みデータ・オブジェクトを探索できます。
アシスタントを使用してAI Data Catalog内のデータを検索
アシスタントは、Oracle AI Data Catalog内のエンティティを検索できます。Lucía はcatalogo_comercioのカート・データから開始します:
AI Data CatalogでエンティティSHOPPING_CART_SESSIONSおよびSHOPPING_CART_LINE_ITEMSを検索します。一致する結果とその参照をカタログに表示します。
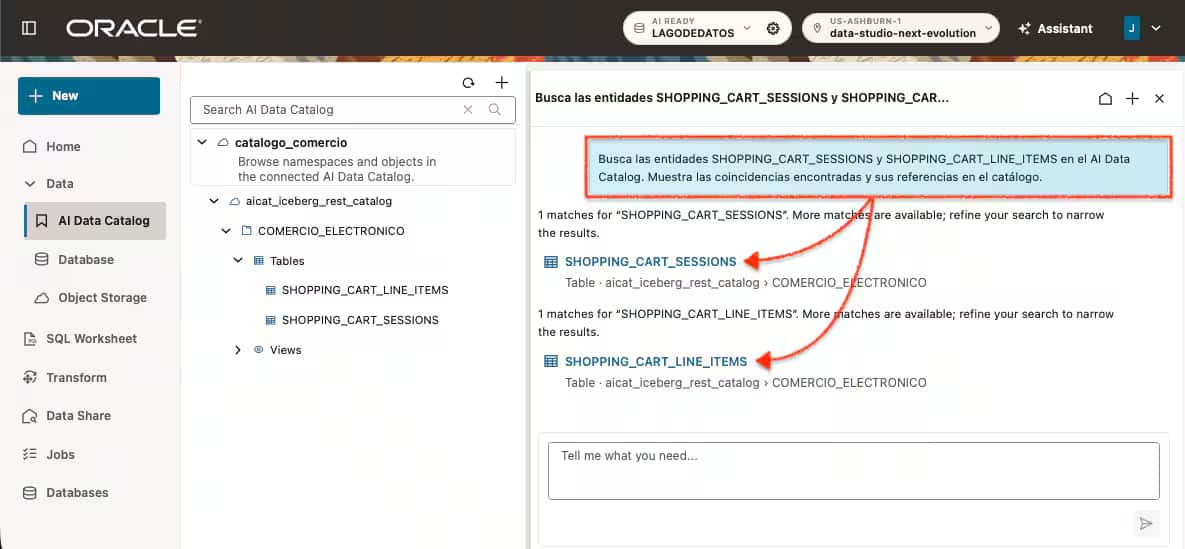
Assistantは両方の表への参照を返します。SQLを生成する前に、それらの参照を開き、利用可能なメタデータを確認してください。分析対象のデータに対して、カタログ、ネームスペース、および表名を確認します。
AI Data Catalog内の表を問い合せるSQLを生成
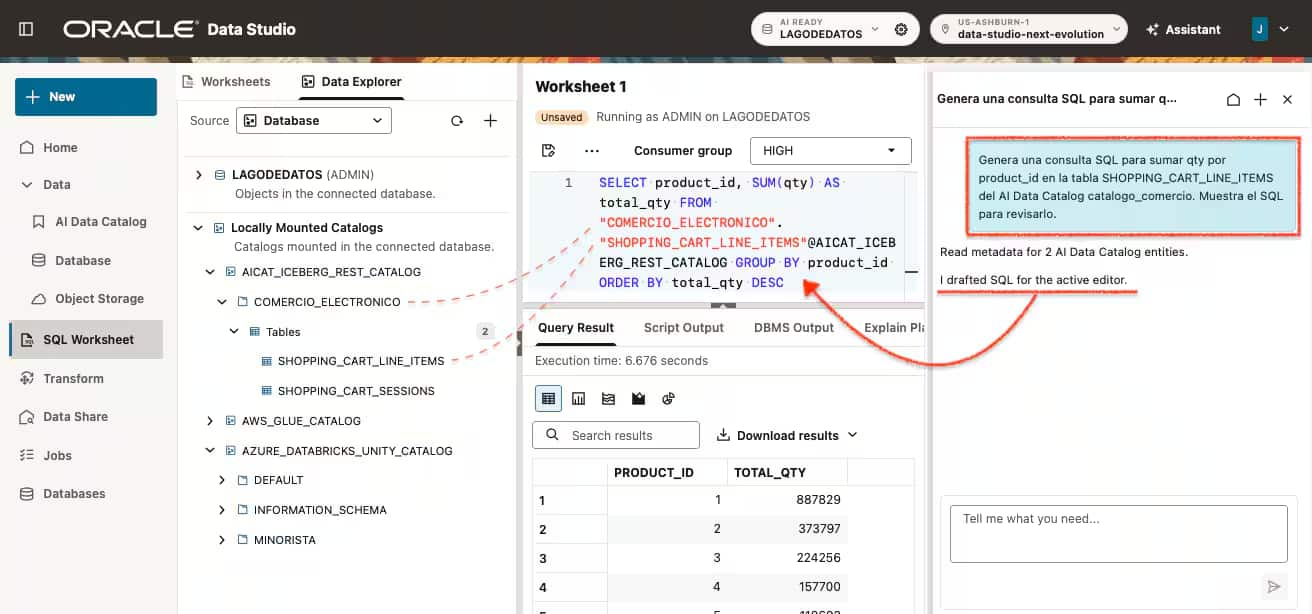
Lucía は、カート明細品目用のSQLを生成するようアシスタントに依頼します:
AI Data Catalogのcatalogo_comercioにあるSHOPPING_CART_LINE_ITEMS表で、product_idごとにqtyを合計するSQL問合せを生成します。レビュー用のSQLを表示します。
リクエストは、catalogo_comercio内の表を対象としています。Lucíaは生成されたSQLを確認し、意図した表と集計が使用されていることを確認したうえで、チームが検査して再利用できるよう分析とともに保持します。
OCIオブジェクト・ストレージからインベントリをロード
Lucía は、lagodedatos-fuentesバケット内のstore_inventory.parquetからの在庫データも必要としています。彼女はアシスタントに、ローカル・データベース表へのロードを準備するよう依頼します。
lagodedatos-fuentesバケットからstore_inventory.parquetを私のローカル・データベースにstore_inventoryという名前の表としてロードします。
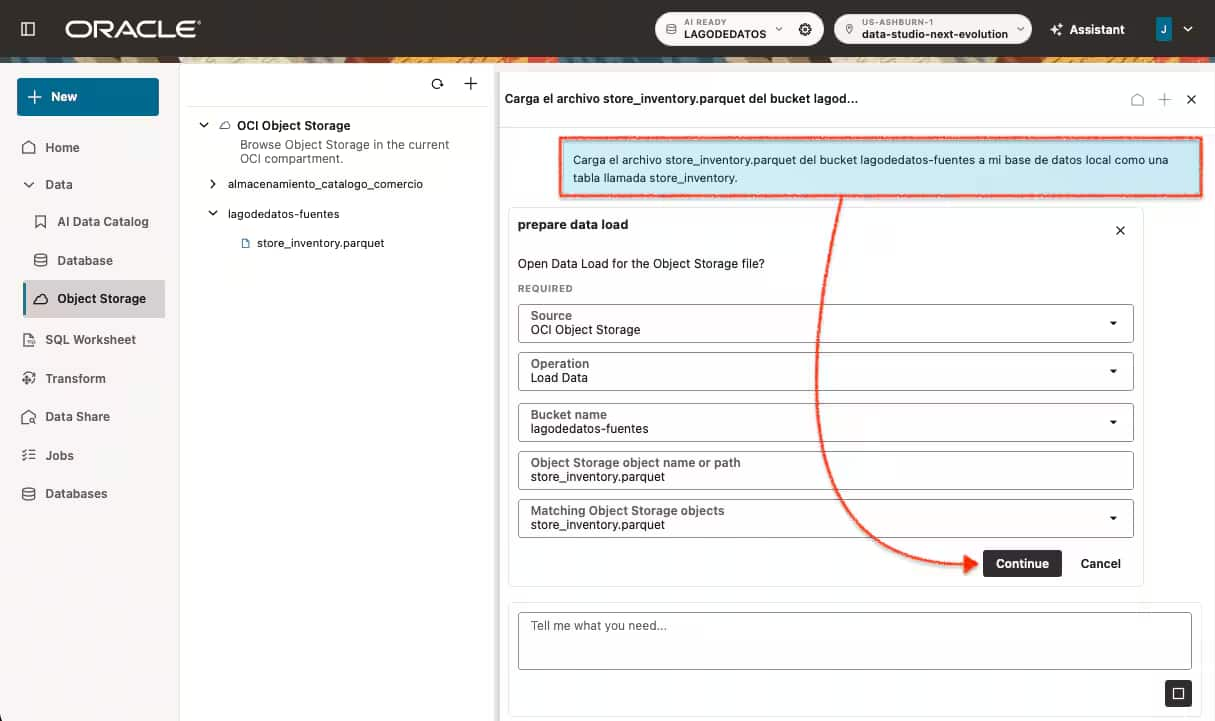
続行する前に、バケット、オブジェクト・パス、および選択したデータベースを確認してください。ロードを完了するには、「データのロード、リンク、およびフィード」に従います。ターゲット・スキーマおよび表アクションを選択し、列マッピングとデータ型を確認し、データをプレビューしてから、ロード・ジョブを作成する前に生成されたSQLを確認します。その進行状況とエラーは「ジョブ」ページで確認します。
データのロード操作では、ソース・データをデータベース表にコピーします。リンク・データ操作は外部ソースを参照します。この例では、継続的な分析で使用する前に、ローカル・インベントリ・コピーが意図した選択であることを確認し、それをどのようにリフレッシュするかを決定します。
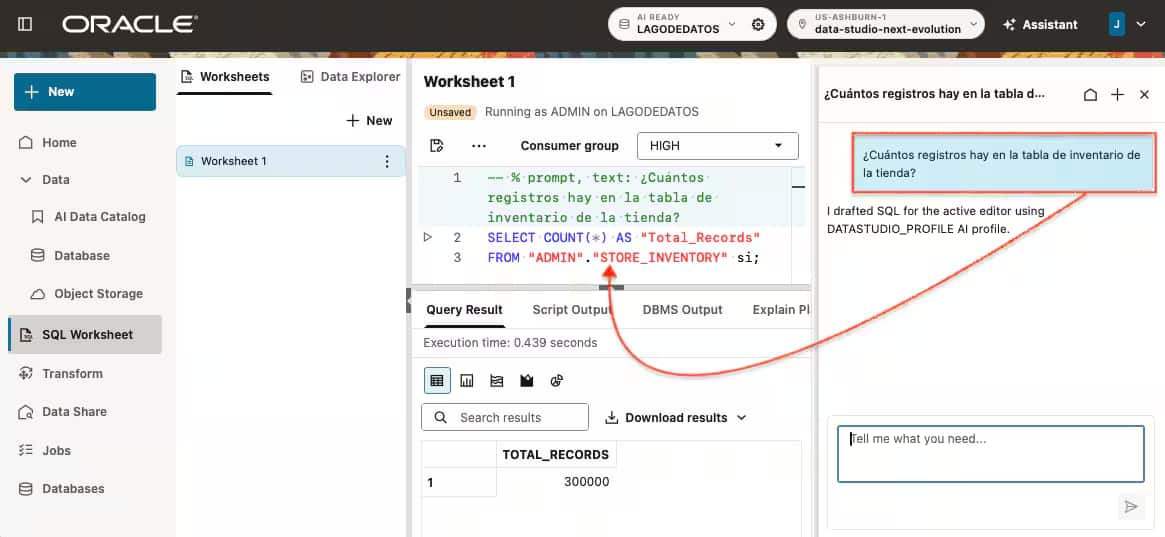
ジョブが正常に完了したら、ターゲット表の所有者として接続し、ロードされた行数を確認します:
店舗在庫表には何件のレコードがありますか?
ソース接続とSQLワークフローを表示したままにする
Oracle Data Studioは、AI Lakehouseのコンポーネントを単一の統合ワークスペースに集約し、チームがツールや環境を頻繁に切り替えることなく、複数のプラットフォームにわたるデータを検出、アクセス、分析できるようにします。
より広範な分析では、売上、ショッピング・カート、店舗在庫、およびサプライヤの供給可能状況を関連付けます。これらのデータセットは、Oracle AI Lakehouse Databases、Apache Icebergカタログ、AWS Glue、Azure Databricks Unity Catalog、OCI Object Storageなど、異なるシステムに存在する場合があります。
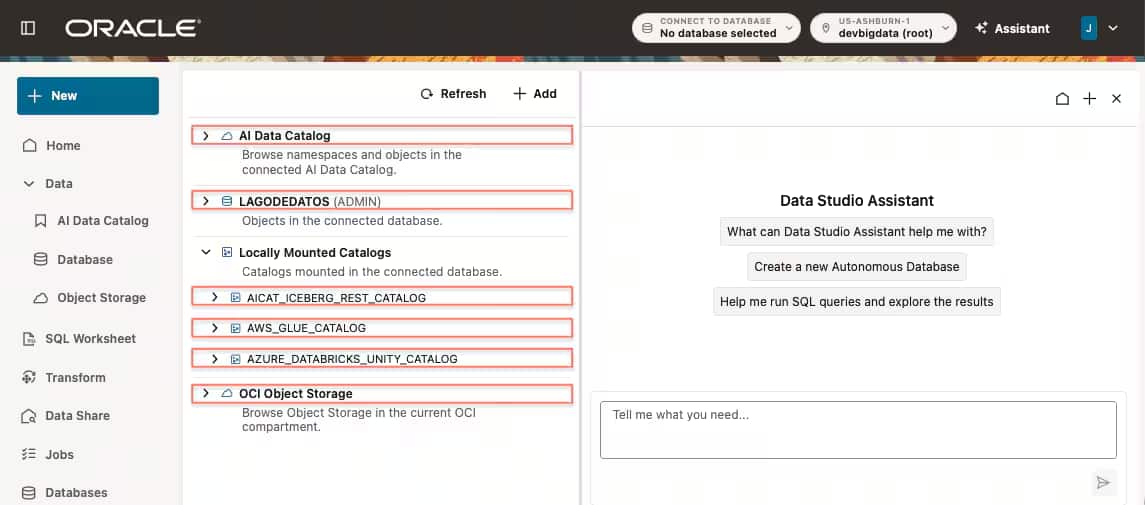
Data Studio Assistantは、ユーザーが自然言語を使用してデータを探索し、SQLを生成できるよう支援することで、このエクスペリエンスをさらに簡素化します。ワークスペースは共通のエントリ・ポイントを提供しますが、複数のソースを組み合わせる問合せでは、ソース参照、関係、集計レベル、および実行結果の検証が依然として必要です。
チームは単一のソースから開始し、要件の進化に応じて、追加のカタログおよび環境全体へ分析を段階的に拡張できます。
カート需要から補充決定まで
在庫に注意が必要な箇所を特定するために、Lucía はSQL Worksheet AI Assistantに尋ねます:
利用可能なデータの直近7日間のショッピング・カート需要に基づいて、在庫不足が最も大きい商品と店舗の組み合わせはどの10件ですか?
各製品および店舗について、カートの合計数量を確約可能在庫と比較します。製品ID、店舗ID、カート合計数量、利用可能在庫、不足数量、および最終在庫更新日時を表示します。需要が使用可能在庫を超過している組合せのみを含め、不足数量が大きい順にランク付けします。
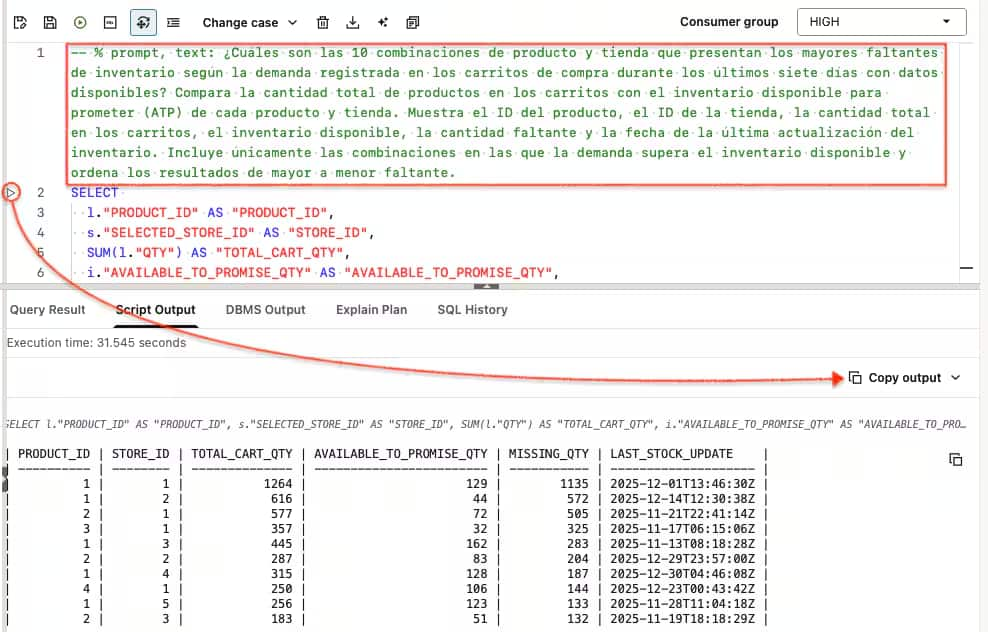
比較により、Lucía に優先順位付けされたレビュー・リストが提供されます。3つの最大のギャップは次のとおりです:
| Product ID | Store ID | Cart quantity | Available-to-promise quantity | Gap |
|---|---|---|---|---|
| 1 | 1 | 1,264 | 129 | 1,135 |
| 1 | 2 | 616 | 44 | 572 |
| 2 | 1 | 577 | 72 | 505 |
Lucíaの次のステップは明確です。Store 1のProduct 1から開始して、在庫を確認し、補充レビューの優先順位を付けます。小売業者のデータ・プラットフォーム全体にまたがっていた疑問に、具体的な答えと実行すべき場所が示されました。
これがData Studioの価値です。データベース・インスタンスと接続されたカタログ全体にわたる1つのワークスペースで、チームはデータを検出し、AI支援を活用してSQLを開発し、結果をビジネス上の意思決定につなげることができます。新たな質問が生じた場合、UIまたはAssistantを通じて接続済ソースを拡張および管理し、検出から意思決定まで、より多くのデータを同じワークフローに取り込むことができます。
参考資料
- ワークスペースへのアクセスと前提条件 – ワークフローを続行するためのアクセス・パス。
- Oracle外部カタログ管理 – カタログの概念とアクセス要件。
- Databricks Unity Catalogアクセス例 – 対象となるIceberg互換表の検出および問合せ。
- Oracle AI Data Catalog – マネージドIceberg RESTカタログ、メタデータ、およびストレージ構成。
- AWS GlueおよびIcebergカタログのマウント – AWS GlueおよびOracle AI Data Catalogを共有カタログ・ビューに接続します。
- Autonomous AI Databaseの概要 – ワークロード・タイプおよびリージョン情報
- Oracle Autonomous AI Lakehouseのイノベーションにより、企業全体のデータ資産でAIエージェントを活用 – より広範なプラットフォーム・コンテキスト向け