第1回では、ネイティブのMySQL TelemetryをPrometheusへエクスポートしました。第2回では、そのメトリクスをDBAが抱く疑問を中心に整理しました。第3回では、その疑問を可視化するGrafanaダッシュボードを作成しました。今回の記事では、アプリケーションが遅くなったときやデータベースのシグナルが変化したときに、このダッシュボードをどう利用できるか見てみます。
目的は、ダッシュボードを自動的な根本原因分析エンジンに変えることではありません。メトリクスを使って変化と発生時刻を確認し、調査範囲を絞り込みます。次の段階では、Performance Schema、サーバーステータス、クエリ分析、MySQLと周辺プラットフォームから、原因を裏付ける情報を収集します。
以下の例は代表的な調査順序です。万能に利用できる障害対応手順や固定のアラート閾値ではなく、検証すべき仮説として扱ってください。この手順では値を異常と判断する前に、ワークロードごとのベースラインを確立します。
トラブルシューティングの順序
次の判断に向けてダッシュボードの確認から始めます。カウンターの上昇だけではなく、同じ時間帯での、接続需要、同時実行数、レイテンシ、ホストの状況と比較してください。
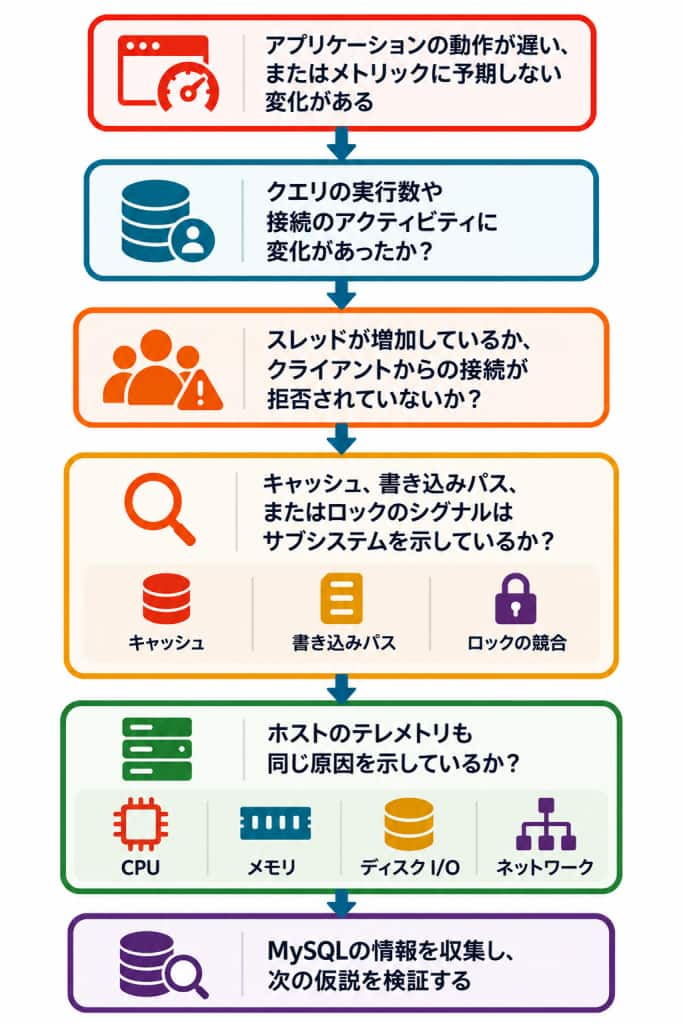
最初は狭い時間帯での状態を確認し、その後、通常時のパターンと比較できるよう範囲を広げます。アプリケーショントレースやアプリケーションレイテンシのメトリクスが利用できるなら、MySQLおよびホストの時系列とそろえます。OpenTelemetryを使うと、MySQL、アプリケーション、ホストの各メトリクスを同じ時間軸で突き合わせやすくなります。ただし、それだけでMySQLサーバーの状態や仕組みを理解しなくてよくなるわけではありません。
状況から情報収集への簡易的な対応表
| ダッシュボード上の状況 | 調査範囲を絞るメトリクス例 | 次に収集するMySQLの情報例 |
|---|---|---|
| 接続数の増加またはクライアントの接続拒否 | threads_connected、errors_max_connections_total、questions_total | max_connections、接続・スレッドのステータス、 アプリケーションのプーリング動作 |
| リクエスト量の増加と応答時間悪化 | questions_total、threads_running、CPU使用率 | 実行中ステートメント、 ステートメントサマリー、 スロークエリまたはアプリケーションの情報 |
| 読み取り性能の変化 | read_requests_total、reads_total、バッファプールヒット率、 ディスク読み取り時間 | バッファプールサイズ、 クエリプランとアクセスパターン、 データとワーキングセットの変化 |
| 書き込みの遅延 | os_log_written_total、log_waits_total、os_log_pending_fsyncs、ディスク書き込み時間 | Redoとコミットの動作、 ストレージ状況、 書き込みワークロードとトランザクションサイズ |
| トランザクションの待機 | row_lock_current_waits、row_lock_waits_total | data_lock_waits、data_locks、実行中ステートメント、 トランザクション所有者 |
シナリオ1: 接続数の逼迫と接続拒否
接続に関する障害には、二つの疑問があります。同時実行数がサービス上限に近づいているのか、それとも設定した接続上限に達し、MySQLがすでにクライアントを拒否しているのかです。ダッシュボードでは、現在値のゲージと失敗カウンターを分けて表示します。
シグナルと仮説
threads_connected、errors_max_connections_total、questions_totalを使用し、需要の増加と接続上限の枯渇を区別します。拒否カウンターがゼロ以外であることはより強い症状であり、設定したmax_connectionsの上限によりクライアントが拒否されたことを示します。
increase(errors_max_connections_total{
  job="mysql/mysqld", instance="$instance"
}[5m])
収集する情報
設定上限、現在の接続数、関連カウンターを確認します。これにより、ダッシュボード上のシグナルが調査時点のサーバー状態と整合するかを確認できます。
SHOW VARIABLES LIKE 'max_connections';
SHOW GLOBAL STATUS
WHERE Variable_name IN (
  'Threads_connected',
  'Threads_running',
  'Max_used_connections',
  'Connection_errors_max_connections'
);ワークロードの増加に対応せず接続だけが増加するなら、max_connectionsを変更する前にアプリケーションの接続ライフサイクルとプーリングを調べます。接続を増やすとメモリを消費し、スケジューラーの仕事も増えるため、上限の増加は症状を先送りし、別の場所へ圧力を移すだけの場合があります。
シナリオ2: リクエスト量が増加し、処理待ちが発生
コマンドレートの上昇自体は問題ではありません。注目すべきは、questions_totalの継続的な増加に続いてthreads_runningが上昇し、アプリケーションレイテンシが悪化するパターンです。これは処理待ちの発生を示唆しますが、原因までは特定しません。
シグナルと仮説
rate(questions_total{job="mysql/mysqld", instance="$instance"}[5m])コマンドレートをthreads_runningとCPU使用率に比較します。ワークロードが増えてもthreads_runningとレイテンシが通常水準なら、MySQLは処理に追いついている可能性があります。threads_runningが高止まりする場合は、キャッシュ、書き込みパス、ロック、ホストのパネルを使い、次の調査方向を決めます。
収集する情報
Performance Schemaで現在実行中のステートメントを特定し、現在の状態と集計済みのステートメント履歴を比較します。現在のテーブルはライブビューであり、症状が発生している間に最も有用です。
SELECT THREAD_ID, EVENT_ID, EVENT_NAME, TIMER_WAIT, SQL_TEXT
FROM performance_schema.events_statements_current
WHERE SQL_TEXT IS NOT NULL
ORDER BY TIMER_WAIT DESC;
長期間にわたるワークロードの変化では、ステートメントダイジェストを比較します。ダイジェストサマリーは、正規化済みダイジェストごとに完了したステートメントを集計し、後のプラン分析に使える代表サンプルを保持します。
SELECT DIGEST_TEXT, COUNT_STAR,
  ROUND(SUM_TIMER_WAIT / 1000000000000, 2) AS total_latency_s,
  ROUND(AVG_TIMER_WAIT / 1000000000, 2) AS avg_latency_ms,
  SUM_ROWS_EXAMINED, QUERY_SAMPLE_TEXT
FROM performance_schema.events_statements_summary_by_digest
WHERE DIGEST_TEXT IS NOT NULL
ORDER BY SUM_TIMER_WAIT DESC
LIMIT 10;threads_runningが高いからといって、MySQL設定の問題だと決めつけないでください。非効率なSQL、ロック待機、CPU飽和、ストレージ遅延、急な需要変化でも同じシグナルが発生します。
シナリオ3: ディスクからの読み取りが増え、キャッシュが効きにくくなる
物理読み取りの増加、通常時のヒット率ベースラインからの低下、アプリケーションの読み取りレイテンシ悪化が同時に起きた場合、キャッシュの症状から、読み取りを引き起こしているステートメントとアクセスパスへ速やかに移ります。
シグナルと仮説
直接エクスポートの構成では、物理読み取りにreads_total、論理読み取りリクエストにread_requests_totalを使用します。レートで変化を特定してから、クエリ、プラン、バッチ処理、またはデータ増加がワーキングセットを変えたかを検証します。
rate(reads_total{job="mysql/mysqld", instance="$instance"}[5m])
1 - (
  rate(reads_total{job="mysql/mysqld", instance="$instance"}[5m]) /
  rate(read_requests_total{job="mysql/mysqld", instance="$instance"}[5m])
)
低負荷サーバーで比率が不安定なら、範囲を広げるか、より長いベースラインを使います。単一の絶対パーセンテージを普遍的な目標として扱わないでください。同じワークロードでも、別サービスとは異なる健全なベースラインを持つ場合があります。
収集する情報
前のシナリオのダイジェストサマリーで高コストのステートメントを特定し、代表ステートメントと実行計画を調べます。新しい物理読み取りパターンを説明する際は、バッファプールサイズだけよりも、クエリプランとアクセスパターンの情報が有用です。
EXPLAIN FORMAT=TREE
/* representative statement from QUERY_SAMPLE_TEXT */
SELECT ...;
実行計画では、どのテーブルをどの順番で参照するか、どのインデックスを使うか、何行を処理すると見積もっているかを確認します。これらが、想定しているクエリの処理内容と合っているかを比較してください。クエリと実行計画を確認した後に、バッファプールのサイズがワークロードに対して適切かを確認します。
SELECT @@innodb_buffer_pool_size / 1024 / 1024 / 1024
  AS buffer_pool_gib;
シナリオ4: 書き込み処理が増え、ディスク書き込みの負荷が高まっている可能性
Redoスループットはアクティビティを測定しますが、それだけでログまたはストレージサブシステムの飽和を証明するものではありません。os_log_written_totalでRedo量の変化を、log_waits_totalで待機の蓄積を、os_log_pending_fsyncsでfsync待機キューの継続を確認します。
シグナルと仮説
rate(os_log_written_total{job="mysql/mysqld", instance="$instance"}[5m])
rate(log_waits_total{job="mysql/mysqld", instance="$instance"}[5m])
os_log_pending_fsyncs{job="mysql/mysqld", instance="$instance"}
一定の書き込み負荷をかけているだけなら、Redoの書き込み量が増えても、ログ待機は発生せず、保留中の fsync も短時間で解消されることがあります。この状態だけでは、ログやストレージが継続的なボトルネックになっているとはいえません。Redoの書き込み量、ログ待機、fsync の待ち行列、コミットのレイテンシ、ホスト側のディスク書き込み時間が、一定期間にわたって同時に悪化している場合に、原因を詳しく調査します。
収集する情報
Redo関連の設定を変更する前に、書き込みワークロードとストレージ状況を確認します。大きなトランザクション、バッチ処理、コミットパターンの変更、インフラストラクチャイベントを探します。ホストレベルの読み取り・書き込み時間は有用な補助シグナルですが、エンドツーエンドのアプリケーションレイテンシではありません。
シナリオ5: 行ロック待機から、待機とブロックの関係を調べる
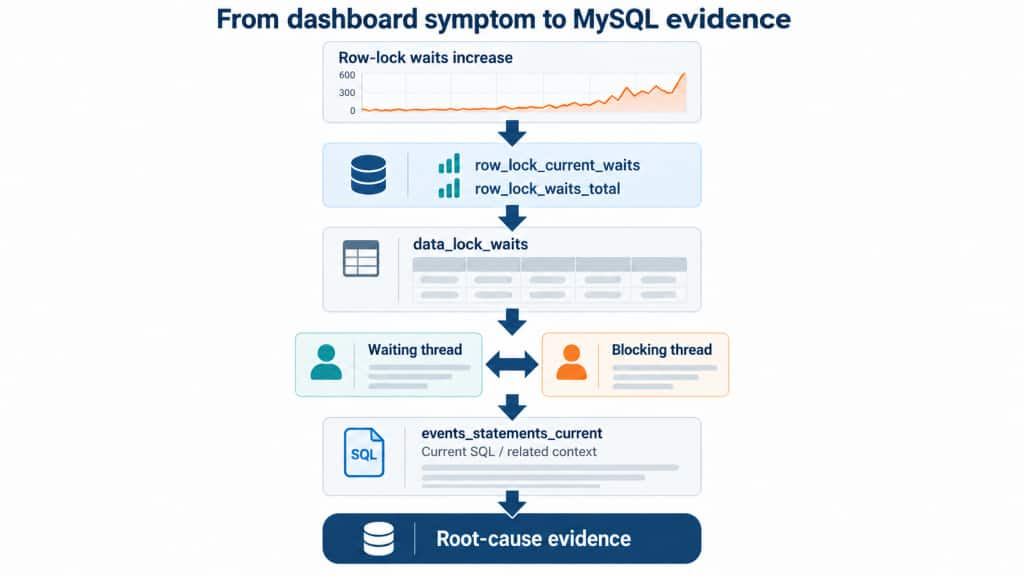
ロック関連のメトリクスは、監視画面の異常からMySQL内部の調査へ進むきっかけになります。row_lock_current_waits または row_lock_waits_total が増えている場合、あるトランザクションが行ロックの解放を待っていることを示します。ただし、これらのメトリクスだけでは、どのトランザクションがブロックしているのか、どのデータがロックされているのか、どのSQLが関係しているのかまでは分かりません。
シグナルと仮説
row_lock_current_waits{job="mysql/mysqld", instance="$instance"}
rate(row_lock_waits_total{job="mysql/mysqld", instance="$instance"}[5m])
現在の待機数は、今この時点でロック競合が発生しているかを示します。待機イベントのレートは、指定した時間範囲でロック待機がどの程度発生したかを示します。これらの値がアプリケーションのレイテンシ上昇と同時に増えた場合は、すぐにMySQL内部の情報を確認してください。時間が経つとロック待機が解消され、待機していたトランザクションとブロックしていたトランザクションの関係を確認できなくなる可能性があります。
収集する情報
Performance Schemaのdata_lock_waitsテーブルは、待機中とブロッキング中のロック要求を結び付けます。まず識別子を確認し、次にスレッド識別子を使用して現在実行中のステートメントと関連トランザクションのコンテキストを特定します。
SELECT REQUESTING_ENGINE_TRANSACTION_ID AS waiting_transaction,
  REQUESTING_THREAD_ID AS waiting_thread,
  BLOCKING_ENGINE_TRANSACTION_ID AS blocking_transaction,
  BLOCKING_THREAD_ID AS blocking_thread,
  REQUESTING_ENGINE_LOCK_ID AS waiting_lock,
  BLOCKING_ENGINE_LOCK_ID AS blocking_lock
FROM performance_schema.data_lock_waits;
SELECT THREAD_ID, EVENT_ID, EVENT_NAME, TIMER_WAIT, SQL_TEXT
FROM performance_schema.events_statements_current
WHERE THREAD_ID IN (/* waiting and blocking thread IDs */);取得した情報を基に、ロックを保持しているセッション、実行中のSQL、対象のテーブルとインデックス、トランザクションの開始から終了までの範囲を確認します。対応方法は原因によって異なります。SQLの設計、トランザクションの長さ、同時実行の方法、トランザクション分離レベル、インデックス設計などを総合的に確認してください。ロック待機の増加だけを理由に、特定のサーバー設定を変更するべきだと判断しないことが重要です。
ホストのTelemetryでMySQLの調査結果を裏付ける
MySQL Telemetryは、接続数、ロック待機、読み取り・書き込みなど、データベース内部で起きていることを確認するために使います。ホストのTelemetryは、CPU、メモリ、ディスク、ネットワークの状況を確認し、MySQLで観測した現象がホスト側の負荷やリソース不足と関係しているかを判断するために役立ちます。Grafanaの例では、MySQLのメトリクスはOTLPで直接エクスポートし、ホストのメトリクスは node_exporter をPrometheusでスクレイプして収集します。
たとえば、threads_running の増加とCPU使用率の上昇が同時に見られる場合は、CPU不足や実行コストの高いSQLが原因である可能性があります。書き込み関連のメトリクスとホスト側のディスク書き込み時間が同時に悪化している場合は、ストレージが原因である可能性が高まります。空きメモリやネットワークトラフィックも、MySQL以外に原因がないかを切り分ける手がかりになります。ただし、ホストのメトリクスは補助情報です。最終的な原因を特定するには、Performance Schemaや実行中のSQLなど、MySQL内部の情報も確認する必要があります。
トラブルシューティングで避けたい誤り
- 1つのメトリクスだけで原因を判断しない: 変化の大きさだけでなく、発生時間、継続時間、通常時の値、関連するメトリクスも確認します。
- 同時に変化したからといって、因果関係があるとは限らない: ホストとMySQLのメトリクスが同時に変化しても、原因が同じとは限りません。
- ワークロードやロック待機の原因を確認せずに設定を変更しない。
- すべての環境に当てはまる固定のしきい値を使わない: 通常時の値は、ワークロードやシステム構成によって異なります。
- 情報の取得を後回しにしない: 実行中のSQLやロック待機の関係は、症状が解消された後には確認できない場合があります。
Telemetryを調査につなげる
ダッシュボードは、原因調査の答えを示すものではなく、調査を始めるための入口です。ユーザーに見える遅延や予期しない変化を起点に、関連するメトリクスを比較し、問題がありそうな領域を絞り込みます。その後、MySQL内部の情報やホスト、アプリケーションの情報を確認して、原因を調べます。この方法により、1つのダッシュボードだけで根本原因を断定するのではなく、調査範囲を段階的に狭められます。
本シリーズでは、MySQLがネイティブメトリクスをエクスポートし、DBAがそれを運用上の確認項目として整理し、Grafanaで可視化を行いました。本記事では、そのメトリクスを実際の障害調査にどう活用するかを見てきました。OpenTelemetryを使うと、MySQL、アプリケーション、インフラストラクチャのメトリクスを同じ時間軸で確認できます。ただし、最終的な原因の判断には、DBAによるMySQLの構成、ワークロード、実行中SQLなどの確認が必要です。
MySQLの状態監視を行う手段のひとつとして、MySQL Telemetryの活用をご検討ください。