このシリーズの初回のブログでは、MySQL Telemetry を設定し、OpenTelemetry メトリクスを Prometheus にエクスポートしました。メトリクスを受信したら、DBA にとって次に重要なのはその読み方です。
この記事は、すべてのメトリクスやメーターを列挙するものではありません。まずワークロード、容量、レイテンシを見て、関連するシグナルを組み合わせます。それによって、データベースが健全なのか、限界に近づいているのか、すでに負荷がかかっているのかを判断するための実践的な考え方を見てみます。
メトリクスが重要な理由
SHOW GLOBAL STATUS や SHOW ENGINE INNODB STATUS などの従来のコマンドも、引き続き有用です。これらはある時点の状態を示し、特定の疑問を調べる最適な手段になることもあります。Telemetry のメトリクスは、そこに履歴を加えます。時系列データを使えば、値がそのサーバーにとって通常の範囲か、デプロイやトラフィックの変化とともに変わったか、複数の症状が同時に始まったかを確認できます。
OpenTelemetry を利用すると、データベースのテレメトリをアプリケーションのメトリクス、トレース、ログと同じ経路で扱えます。MySQL 固有の知識が不要になるわけではありません。その知識を共通のオブザーバビリティ基盤で共有し、アプリケーションの動作と関連づけやすくなります。
ここが、接続数やクエリ実行数などを専用の監視ツールで個別に収集する場合との違いです。MySQL はネイティブのメトリクスを OTLP 経由でエクスポートするため、同じ基盤でデータベースの変化とアプリケーションのレイテンシ、インフラのテレメトリ、利用可能な場合は分散トレースを関連づけられます。どのメトリクスを見るかは、DBA が調べたい問題から決めます。OpenTelemetry は、その判断材料をシステム全体で扱いやすくします。
メーターグループ別に見る DBA の確認ポイント
前回の記事では、サーバーのメーターグループ、収集頻度、performance_schema.setup_meters での設定方法を紹介しました。ここでは一覧をもう一度確認するのではなく、解決したい運用上の問題に応じてメーターグループを選びます。
たとえば接続の動きを見るなら mysql.stats.connection、コマンドの動きなら mysql.stats.com が出発点です。InnoDB とキャッシュの動作には mysql.inno と mysql.inno.buffer_pool、データと I/O に関する動きには mysql.inno.data を使います。利用できるメーターは MySQL のバージョンと有効なコンポーネントによって異なるため、サーバーで次の SQL を実行して確認してください。
SELECT NAME, FREQUENCY, ENABLED, DESCRIPTION
FROM performance_schema.setup_meters;
メーター名はテレメトリのグループを識別する名前であり、DBA 向けダッシュボードの見出しとは異なります。「REDOログの負荷」「競合」「リソースの飽和」といった言葉は現状を把握するための問いです。複数のメトリクスを MySQL のステータス、Performance Schema、ホストのテレメトリと組み合わせて対処を検討します。
DBA が押さえたい主要メトリクス
利用可能なすべてのメトリクス監視を試みるより、一般的な運用上の問題を確認することから始めます。次の表は、DBA の確認項目を代表的な MySQL Telemetry のメーターグループとメトリクスに対応づけたものです。
| 確認項目 | メーターグループ | 最初に確認するメトリクス |
|---|---|---|
| 接続容量 | mysql.stats mysql.stats.connection | threads_connected max_used_connections errors_max_connections |
| ワークロードと待ち行列 | mysql.stats mysql.stats.com | threads_running questions select, insert, update, delete |
| バッファプールの効率 | mysql.inno.buffer_pool | read_requests reads wait_free |
| 書き込み経路の負荷 | mysql.inno | redo_log_logical_size log_waits os_log_pending_fsyncs |
| ロック競合 | mysql.inno | row_lock_current_waits row_lock_waits row_lock_time |
接続数と接続枠の余裕
まず現在開いている接続数を示す mysql.stats.threads_connected を確認し、システム変数 max_connections と比較します。mysql.stats.connection.errors_max_connections は、接続数の上限に達したために拒否された接続を記録します。確認したいのは「接続がいくつあるか」だけではありません。「あと何件接続できるか」「すでにクライアントが拒否されていないか」も重要です。
current connection utilization = threads_connected / max_connections
connection headroom = max_connections - threads_connected
例えば、最初の運用基準としては以下を利用して、サービスの通常のピークに合わせて調整します。
警告:使用率が80%以上の状態が5分間続く場合
緊急:使用率が90%以上の状態が5分間続く場合
また、rate(errors_max_connections[5m]) が0より大きければ、すでにクライアントの接続が拒否されており、インシデントとして扱います。
mysql.stats.max_used_connections は接続容量の計画に役立ちます。再起動後の最大値が max_connections の80%を超えた場合は、コネクションプールの設定を見直し、増加を検討します。この値は現在の使用率を表すものではなく、サーバーを再起動するとリセットされます。接続数が増えていても、閾値を下回っていれば通常のトラフィック増加の可能性があります。閾値を超えた場合や接続が拒否された場合は、原因を調査します。
実行中のスレッド
Threads_running は、サーバーで現在実行中のステートメント数を表します。短いスパイクなら問題ない場合もあります。増加が続くならリクエストが積み上がっています。MySQL 自体に原因があると決める前に、CPU の飽和、ストレージのレイテンシ、ロック待ち、ワークロード構成の変化を確認してください。
バッファプールの動作
バッファプールを見れば、ワーキングセットをメモリから処理できているか、物理読み込みが必要になっているかを確認できます。Innodb_buffer_pool_reads は、バッファプールで処理できず、ディスク読み込みが必要になった回数です。次の派生指標が役立ちます。
buffer pool hit ratio = 1 – (Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests)この式では、基になる MySQL ステータス変数を使っています。Prometheus では、対応するエクスポート済みの Telemetry メトリクスから同じ比率を計算します。
Prometheus では、累積カウンターの値をそのまま使わず、一定期間の増加率から比率を求めます。第1回の直接エクスポート構成でのクエリは以下です。
1 – (rate(reads[5m]) / rate(read_requests[5m]))クエリをコピーする前に、Prometheus のエンドポイントに表示されるメトリクス名を確認してください。OpenTelemetry Collector では、テレメトリの処理経路で名前や属性を意図的に変換できます。
また、すべての環境に共通する目標値を当てはめるのではなく、まずワークロードの基準値を把握します。その基準からヒット率が下がり、物理読み込みとクエリのレイテンシが上がっているなら、単独のパーセンテージより意味のあるシグナルになります。
REDO とチェックポイントの動作
書き込みの多いシステムでは、書き込みスループット、REDO の生成、チェックポイントの動作、ストレージのレイテンシを合わせて観察します。「REDOログの負荷」は診断上のパターンであり、メーターグループ名ではありません。書き込み要求の高止まりがチェックポイントへの負荷、コミットやトランザクションのレイテンシ悪化と同時に起きていないかを確認します。
ロック待ち
ロック待ちのカウンターと増加率は、ユーザーには断続的な処理遅延として見える処理競合を示します。待ちが増えたら、トランザクション、分離レベルの動作、関係するステートメントを調べます。Performance Schema を使い、集計値で見えた症状から、原因となるセッションやオブジェクトを特定します。
1秒あたりのコマンド数
カウンターメトリクスは、増加率にすると役立ちます。Prometheus では rate(questions[5m]) のような時系列表示を使い、クライアントからのステートメントの実行率を確認します。ワークロードの増加率を、レイテンシ、エラー、接続数、リソース消費と比較してください。1秒あたりのコマンド数が増えても、レイテンシが安定していれば健全です。待ち行列とレイテンシが同時に上がるなら、警戒が必要です。
メトリクスを組み合わせて使う
一つのメトリクスからは、何かが変わったことがわかります。複数を組み合わせると、その理由を考えられます。次のフローを参考にしてください。
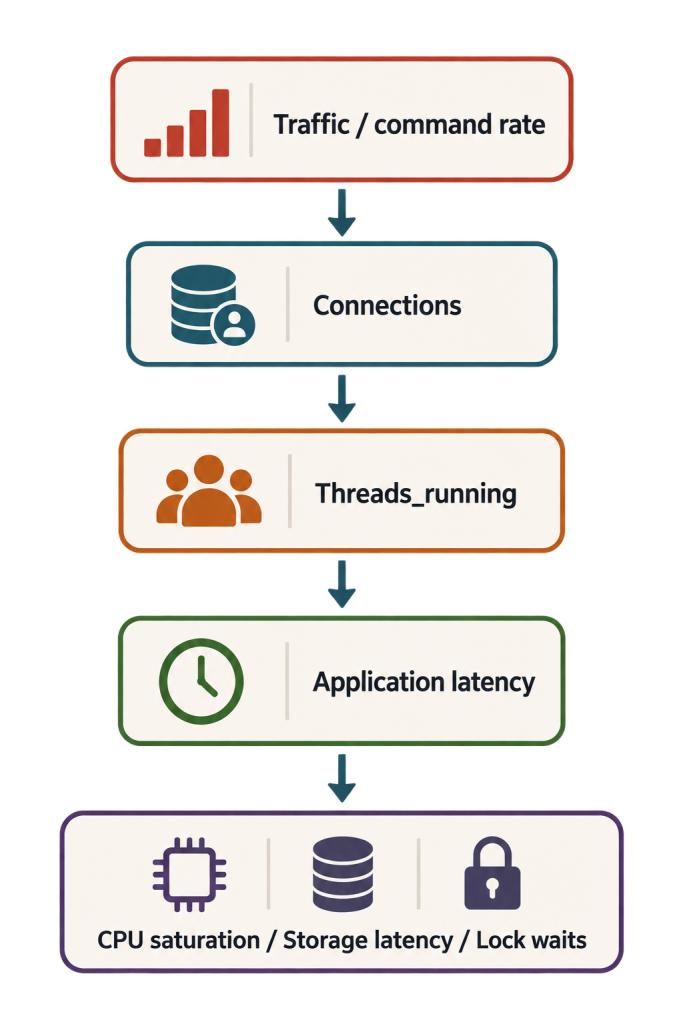
上の図は原因を一つに特定するためのものではなく、調査の進め方を示すフローです。OpenTelemetry を使えば、DBA は同じ時間帯の MySQL、アプリケーション、インフラのテレメトリを並べて確認できます。例えば、メトリクスの組み合わせから次のような状況を見分けます。
- トラフィック増加後も健全:接続数とコマンドの実行率は増えているが、
Threads_running、レイテンシ、リソース使用量は通常の範囲内である。 - 待ち行列:
Threads_runningが高い状態が続き、レイテンシも上昇している。CPU、ストレージのレイテンシ、ロック待ち、実行中ステートメントの構成と照合して確認する。 - ワーキングセットがメモリに収まらない:物理読み込みが増え、バッファプールのヒット率が基準値から下がり、読み込みのレイテンシが悪化している。データ量の増加、メモリ容量、ワークロードの変化を確認する。
- 書き込み経路の負荷:書き込みの増加率、REDO の生成、チェックポイントの動作、コミットのレイテンシが同時に上昇している。設定を変更する前に、ストレージと書き込みパターンを検証する。
こうした見方をすれば、通常のピークに過剰反応したり、原因とは違う部分を調整せずに済みます。
最初に作る実用的なダッシュボード
最初の運用ダッシュボードは、判断に必要な情報が見える程度に絞ります。
- 接続:接続中のクライアント、接続エラー、余裕度
- ワークロード:コマンドの実行率と
Threads_running - キャッシュ:バッファプールの論理読み込みと物理読み込み、および計算したヒット率
- 書き込み経路:書き込みと REDO の動作、およびコミットのレイテンシ
- 競合:ロック待ちの増加率とトランザクションの状況
- システムの状況:CPU、メモリ、ストレージのレイテンシ、ネットワークトラフィック
ダッシュボードに指標を大量に並べることが目的ではなく、「処理要求は増えているか」「MySQL は処理に追いついているか」「追いついていないなら、並行処理、メモリ、ストレージ、競合のどこに負荷があるか」を確認できる、コンパクトなダッシュボードにします。
この6つのパネルがあれば、多くの本番環境で一次的な運用判断を下せます。
これらは MySQL がエクスポートするネイティブの OpenTelemetry メトリクスを基にしているため、運用中に確認する項目を中心に、アプリケーションのメトリクスやトレース、インフラのテレメトリと組み合わせられます。
次回はこれらの確認項目を基に、 Prometheus のクエリを使ってGrafana ダッシュボードを実際に作ってみます。