
※ 本記事は、Doug Hoodによる”Getting Started with Private Large Language Model Service – Part 1“を翻訳したものです。
2026年10月20日
この2部構成のブログでは、Private AI Services Container 26.2.1のPrivate Large Language Model ServiceをCPU搭載のOCI仮想マシンにデプロイして使用する方法について説明します。
パート1では、VMを作成し、大規模なAVX-512コンテナ・イメージをダウンロードして、デフォルトのLLMを使用し、チャットします。
パート2では、Hugging FaceからオープンウェイトLLMをダウンロードし、llama.cppおよびvLLMランタイムで使用します。また、LLMの状態を確認し、Hugging FaceトークンとSSLを使用する方法も学習します。
llama.cppおよびvLLMランタイムは、Private Large Language Model Serviceの強化に使用されます。
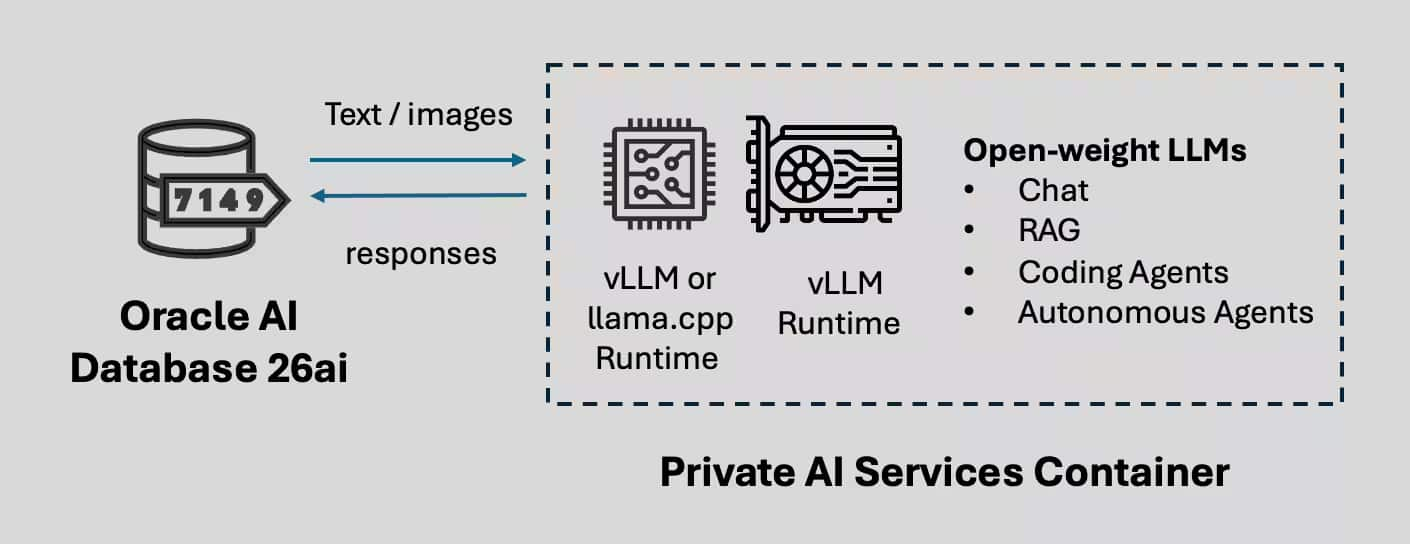
同じサービスは、オンプレミス、エアギャップ環境、またはパブリック・クラウドで実行できます。このチュートリアルでは、OCIでのCPUデプロイメントに重点を置きます。GPUデプロイメントおよび他のクラウドでのデプロイメントについては、今後のブログで説明します。
2. サイズの問題
大規模言語モデルは、実行にリソースを大量に消費します。通常、パラメータ数が大きくなると、モデル・リソース要件が増えますが、モデル機能とパフォーマンスはアーキテクチャ、トレーニング、最適化、ワークロードなどの要因によって異なります。ただし、大規模LLMでは、より多くのリソースを実行する必要があり、その結果、処理速度が遅くなる傾向があります。これにより、サイズと機能のトレードオフや最適化がさまざまに行われるようになっています。
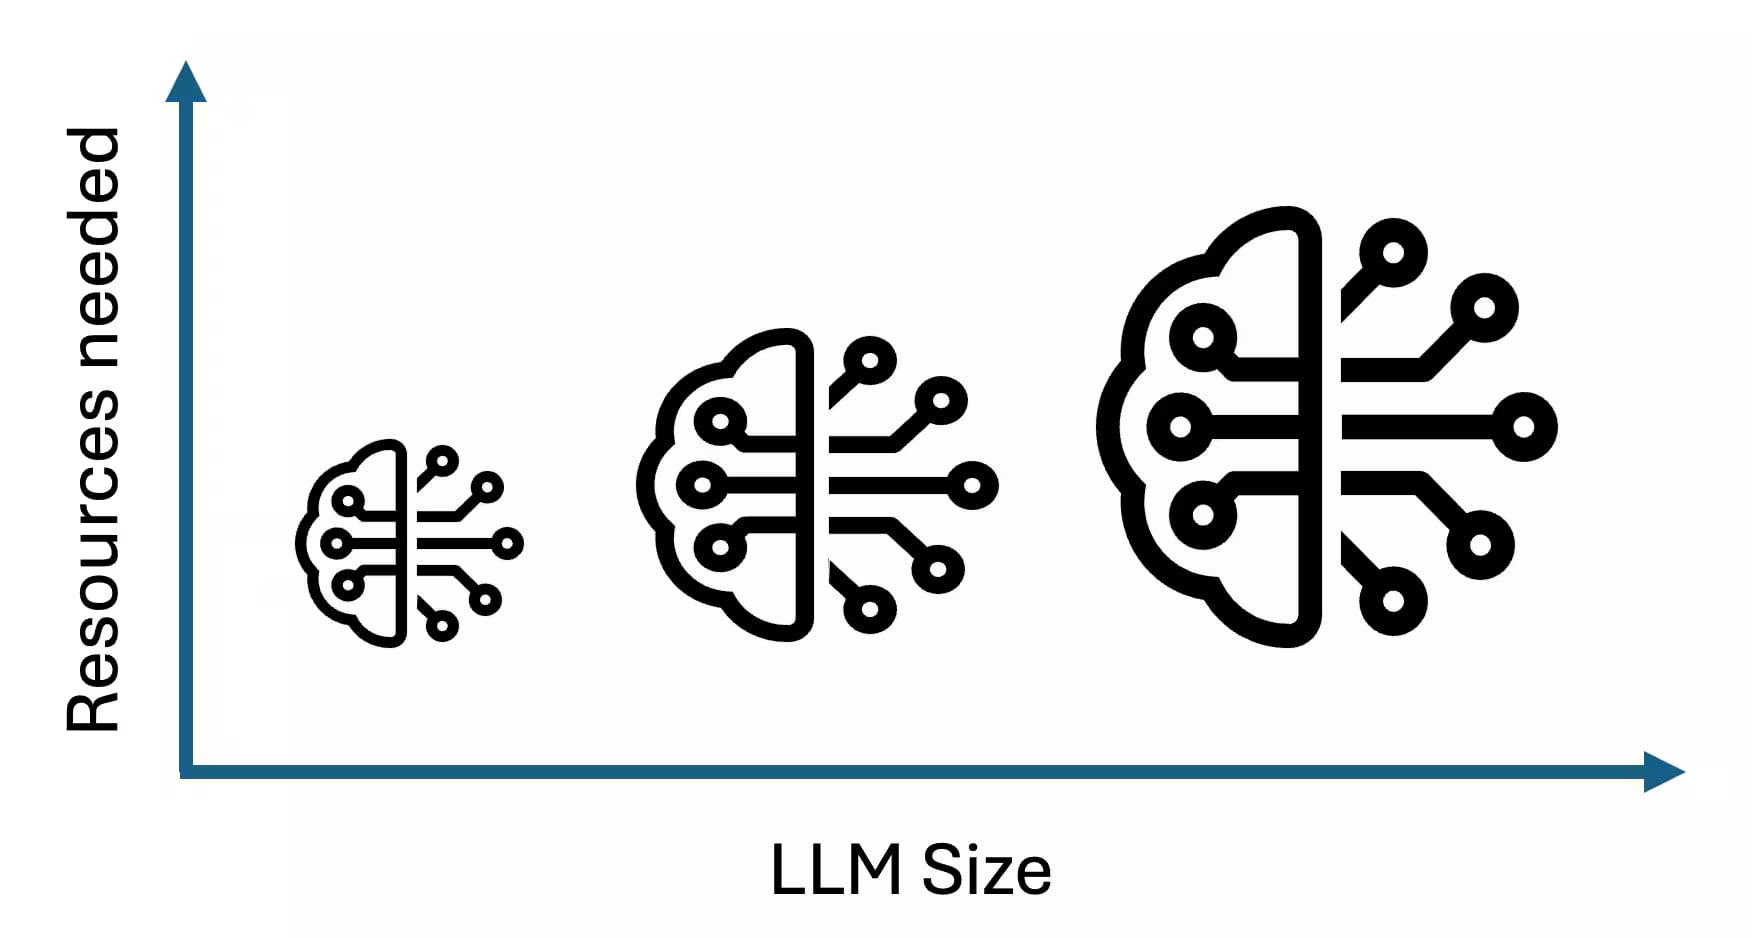
簡略化されたサイジング・フレームワークとして、モデルを複数のパラメータ範囲にグループ化できます。適切なモデル・サイズは、モデル、ワークロード、精度要件、レイテンシ要件および使用可能なハードウェアによって異なります。これらのトレードオフにより、LLMは次の3つの異なるサイズ範囲に分類される傾向があります:
- 最大100億パラメータ
- これらは小規模言語モデルと呼ばれることもあります
- これらのモデルは、より単純な操作に適している傾向があります
- Chat
- 検索拡張生成 (RAG)
- ツール呼出しエージェント
- 100億から700億パラメータ
- これらのモデルは、中程度の複雑さのタスクに適している傾向があります
- Chat
- 検索拡張生成 (RAG)
- ツール呼出しエージェント
- コーディング・エージェント
- これらのモデルは、中程度の複雑さのタスクに適している傾向があります
- 700億を超えるパラメータ
- GLM 5.2やOrnith-1.0-397BのようなオープンウェイトLLMは巨大であり、GPT 5.6やClaude Fabel 5のようなフロンティア・モデルの能力に近づいています
- この種のモデルは、「思考」または推論を伴う最も困難なタスクに必要とされる傾向があります
強力なLinuxサーバーがある場合、Private Large Language Model Serviceはこれら3つの異なるサイズ範囲で動作できます。これは、実際には次のことを意味します:
- CPU Memory (RAM) = モデル・サイズ
オープンウェイトLLMには、より多くのメモリーが必要です。使用可能なメモリーは、モデルの重み、ランタイム・オーバーヘッド、コンテキストまたはKVキャッシュ、オペレーティング・システムおよびその他のプロセスに対応している必要があります。実際の要件は、量子化、コンテキスト長、同時実行性およびランタイムによって異なります。
- CPU Cores = スケーラブルなパフォーマンス
LLM推論は、数百万もの行列乗算演算を処理します。これらの数学演算は、CPUコア間でパラレルに処理できます。モデル、ランタイムおよびワークロードに応じて、使用可能なCPUリソースを増やすと、推論レイテンシおよびスループットの向上に役立ちます。
- Disk Space = ダウンロード済みLLMの数とサイズ
ダウンロードする各LLMは、ディスク領域をGB単位で使用します。多数の異なるLLMをテストすると、必要なディスク領域は急速に増加する可能性があります。
3. 仮想マシンの作成
10億から200億のパラメータ範囲でLLMを使用できるようにするには、次の属性を持つ仮想マシンをOracle Cloud Infrastructureに作成します:
- オペレーティング・システム Oracle Linux 9
- シェイプ VM.Standard.E6.Flex
- CPU 8 OCPU
- メモリー 64 GB RAM
- ストレージ 150GBのカスタム・ブート・ボリューム・サイズ
8 OCPUを使用することは、パフォーマンスとコストのトレードオフです。
サイズ設定に関する考慮事項
CPUでオープン・ウェイトLLMを使用する場合は、次のことを考慮する必要があります:
- LLMは、ユース・ケースに役立つほど十分に大規模か
- お客様のユース・ケースに役立つ最小のLLMとは何か
- LLMは使用可能なメモリ (RAM)内に収まるか
- レイテンシおよびスループットの観点で許容可能な推論パフォーマンスとは何か
- より多くのCPUコアを使用すると、レイテンシとスループットが向上するが、ハードウェア・コストも増加する
- ダウンロードされるすべてのLLMに対して十分なディスク領域があるか
ブート・ボリュームの拡張
VMが作成され、ログインしたら、OCIブート・ボリュームを拡張してディスク領域全体を使用できるようにする必要があります。これを行わないと、Hugging FaceからコンテナおよびオープンウェイトLLMをダウンロードするための十分なディスク領域が不足します。
Linux opcユーザーとして、シェルで次のコマンドを実行します:
sudo /usr/libexec/oci-growfs -y
df -h
これで、ブート・ボリュームに約121 GBのディスク領域が使用可能になります。
4. VM環境の構成
Private AI Services Containerをインストール、構成および実行するには、いくつかのディレクトリおよび環境変数が必要です。
Linuxシェルで、次のコマンドを実行します:
mkdir -p /home/opc/privateai
mkdir -p /home/opc/config
mkdir -p /home/opc/models
mkdir -p /home/opc/secrets
export PRIVATE_DIR=/home/opc/privateai
export SECRETS_DIR=/home/opc/secrets
export CONFIG_DIR=/home/opc/config
export HOST=$(hostname -f); echo $HOST
5. 正しいコンテナを選択
Private AI Services Containerは、7つの専用コンテナ・イメージを含む単一の製品です。
この演習では、次のコンテナを使用します:
- large-cpu-avx512-infer-26.2.1.0.0
このコンテナにはデフォルトのLLMが含まれ、avx512アーキテクチャのCPUで実行されるコンテナに対してPrivate Large Language Model Serviceが有効になります。
6. コンテナのダウンロード
ダウンロードするプロセスは、以前のリリースの場合と同じです。このブログでは、そのプロセスについて説明します。そのブログで重要なのは、Oracle Container Registryにログインできるようにする認証トークンを取得する方法です。
重要なコマンドは次のとおりです:
- sudo dnf install -y container-tools
- podman login container-registry.oracle.com
- IMAGEID=`podman create container-registry.oracle.com/database/private-ai:large-cpu-avx512-infer-26.2.1.0.0`
- podman cp $IMAGEID:/privateai/scripts/privateai-setup-large-cpu-avx512-infer-26.2.1.0.0.zip .
- unzip privateai-setup-large-cpu-avx512-infer-26.2.1.0.0.zip
前述のコマンドは、Podmanをインストールし、Oracle Container Registryからコンテナをダウンロードし、ZIPファイルを抽出して、インストール・スクリプトを含むファイルを解凍します。
7. コンテナのインストール
Linuxシェルで次のコマンドを実行して、コンテナをインストールおよび起動します:
cd /home/opc/setup
./secretsSetup.sh -s $SECRETS_DIR
./configSetup.sh -d $PRIVATE_DIR -s $SECRETS_DIR
./containerSetup.sh -d $PRIVATE_DIR --http
この例では、コンテナはHTTPネットワーク・プロトコルおよびデフォルトのTCPポート8080を使用するように構成されています。
コンテナのステータス確認
数秒後、コンテナが起動されたというメッセージが表示されます。
コンテナの起動には、バックグラウンドで実行される複数のフェーズが含まれます。デフォルトLLMを初めて使用する際、準備が完了するまでに最大3分かかる場合があります。
実行中のコンテナのステータスを確認するには、次のコマンドを使用します:
podman psLLMがディスクからまだロードされている間、コンテナのステータスは「starting」になります。
コンテナがメモリーに完全にロードされると、ステータスは「unhealthy」になり、リクエストを処理できる状態になると最終的に「healthy」のステータスになります。
コンテナのヘルスを確認
次のcURLコマンドを使用して、コンテナの/health RESTエンドポイントを確認します:
curl -i http://localhost:8080/health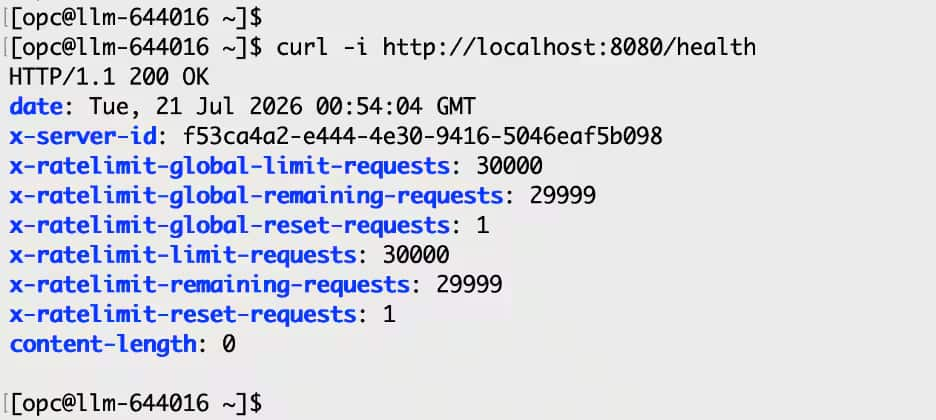
前述のような有効なHTTPレスポンスを取得した場合、コンテナはリクエストを処理する準備ができています。エラーが発生した場合、コンテナはまだリクエストを処理する準備ができていません。
ロードされたモデルの確認
ダウンロードしたlarge-cpu-avx512-infer-26.2.1.0.0コンテナ・イメージには、LLMと一部の埋込みモデルがデフォルトで構成されています。
次のコマンドを使用して、Linuxシェルで使用可能なモデルを検索します:
curl http://localhost:8080/v1/models | jqjqコマンドライン・ユーティリティは、JSON出力を読みやすいように整形して表示します。jqユーティリティは、Oracle Linux 9でデフォルトで使用できます。
出力は次のようになります:
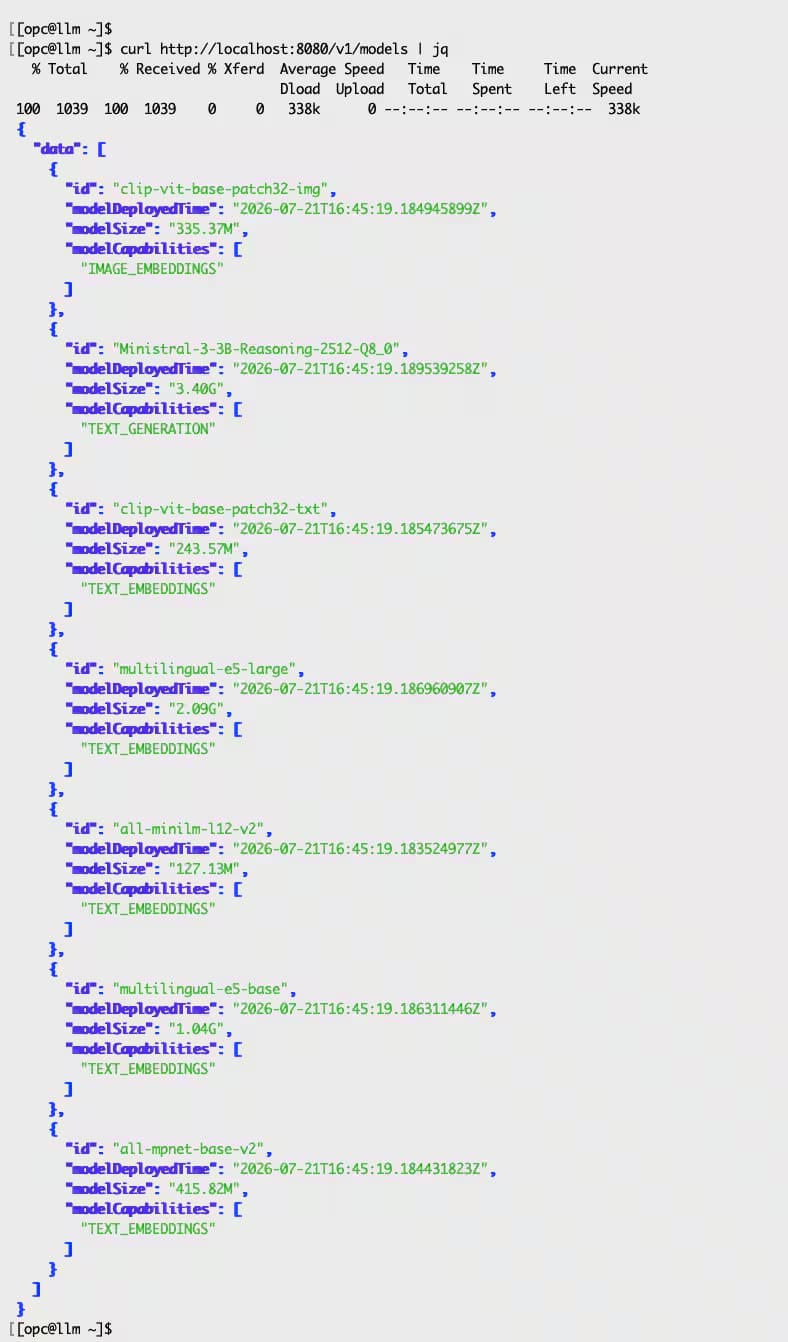
- ロードされたMinistral-3-3B-Rasoning-2512-GGUF-Q8_0モデルは、Mistral.aiの30億パラメータのLLMです
- 他のモデルは、ONNX Runtimeのデフォルトのベクトル埋め込みモデルです
- これは、large-cpu-avx512-infer-26.2.1.0.0コンテナが、構成なしでLLMの推論を実行し、ベクトルを作成できることを意味します
8. LLMとのチャット
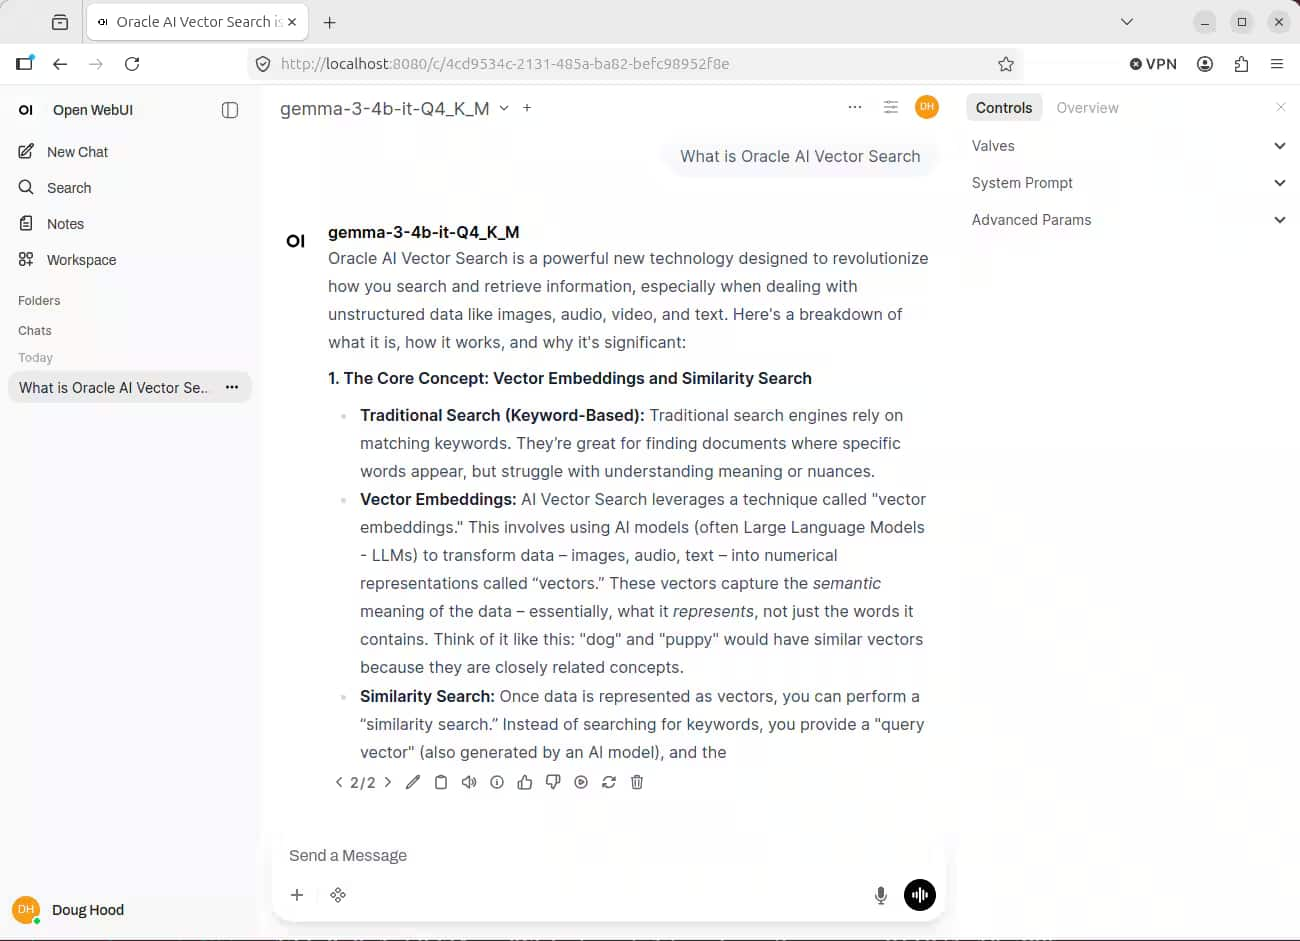
- 上の画像は、Private AI Services Containerとともに使用されているOpen WebUIを示しています
- Open WebUIをPrivate AI Services Containerで使用するように構成する方法については、今後のブログで取り上げます
Oracle Private Agent Factory、Open WebUI、AnythingLLMなどの高度なLLMクライアントは、Private AI Services Containerとのチャットに使用できますが、このブログの例ではcURLユーティリティを使用しています。cURLは、インストールや構成を必要としないため、テストする最も簡単なチャット・クライアントです。
Private AI Services Containerは、/v1/chat/completionsエンドポイントのOpenAI APIのRESTインタフェースを実装します。つまり、有効なRESTリクエストを作成する必要があります。これを行う最も簡単な方法は、LinuxのcURLコマンドライン・ユーティリティを使用することです。cURLを使用してHTTP POSTを実行できます。正しい構文が使用されている場合、HTTP POSTは有効なOpenAI APIリクエストであるRESTメッセージになることができます。
このRESTメッセージの重要な情報は次のとおりです:
- 使用されるLLMモデル
- LLMに送信されるメッセージ / プロンプト
- Private AI Services ContainerのURL
次の例では、URLでlocalhostが使用されています。Private AI Services Containerが実行されているホストのIPアドレスまたは完全修飾ドメイン名もURLで使用できます。これは、cURLコマンドがローカルかリモートかに関係なく、Private AI Services Containerに対して実行できることを意味します。
cURLを使用したチャット
次のcURLコマンドのスクリプトを作成し、cURLを使用してデフォルトのMinistral-3-3B-Reasoning-2512-Q8_0 LLMとチャットします。その後、cURLスクリプトの出力がjqユーティリティにパイプされ、JSON出力が整形表示されます。
curl --noproxy '*' -X POST --header 'Content-Type: application/json' --header "Authorization: Bearer $API_KEY" --cacert $SECRETS_DIR/cert.pem  --data '{
        "model": "Ministral-3-3B-Reasoning-2512-Q8_0",
        "messages":[
                {"role": "user", "content": "Format the output as HTML. What does the SELECT statement in SQL do?"}
        ],
        "max_tokens": 2048,
        "temperature": 0.7,
        "stream": false
}' http://localhost:8080/v1/chat/completions | jq
出力は次のようになります:
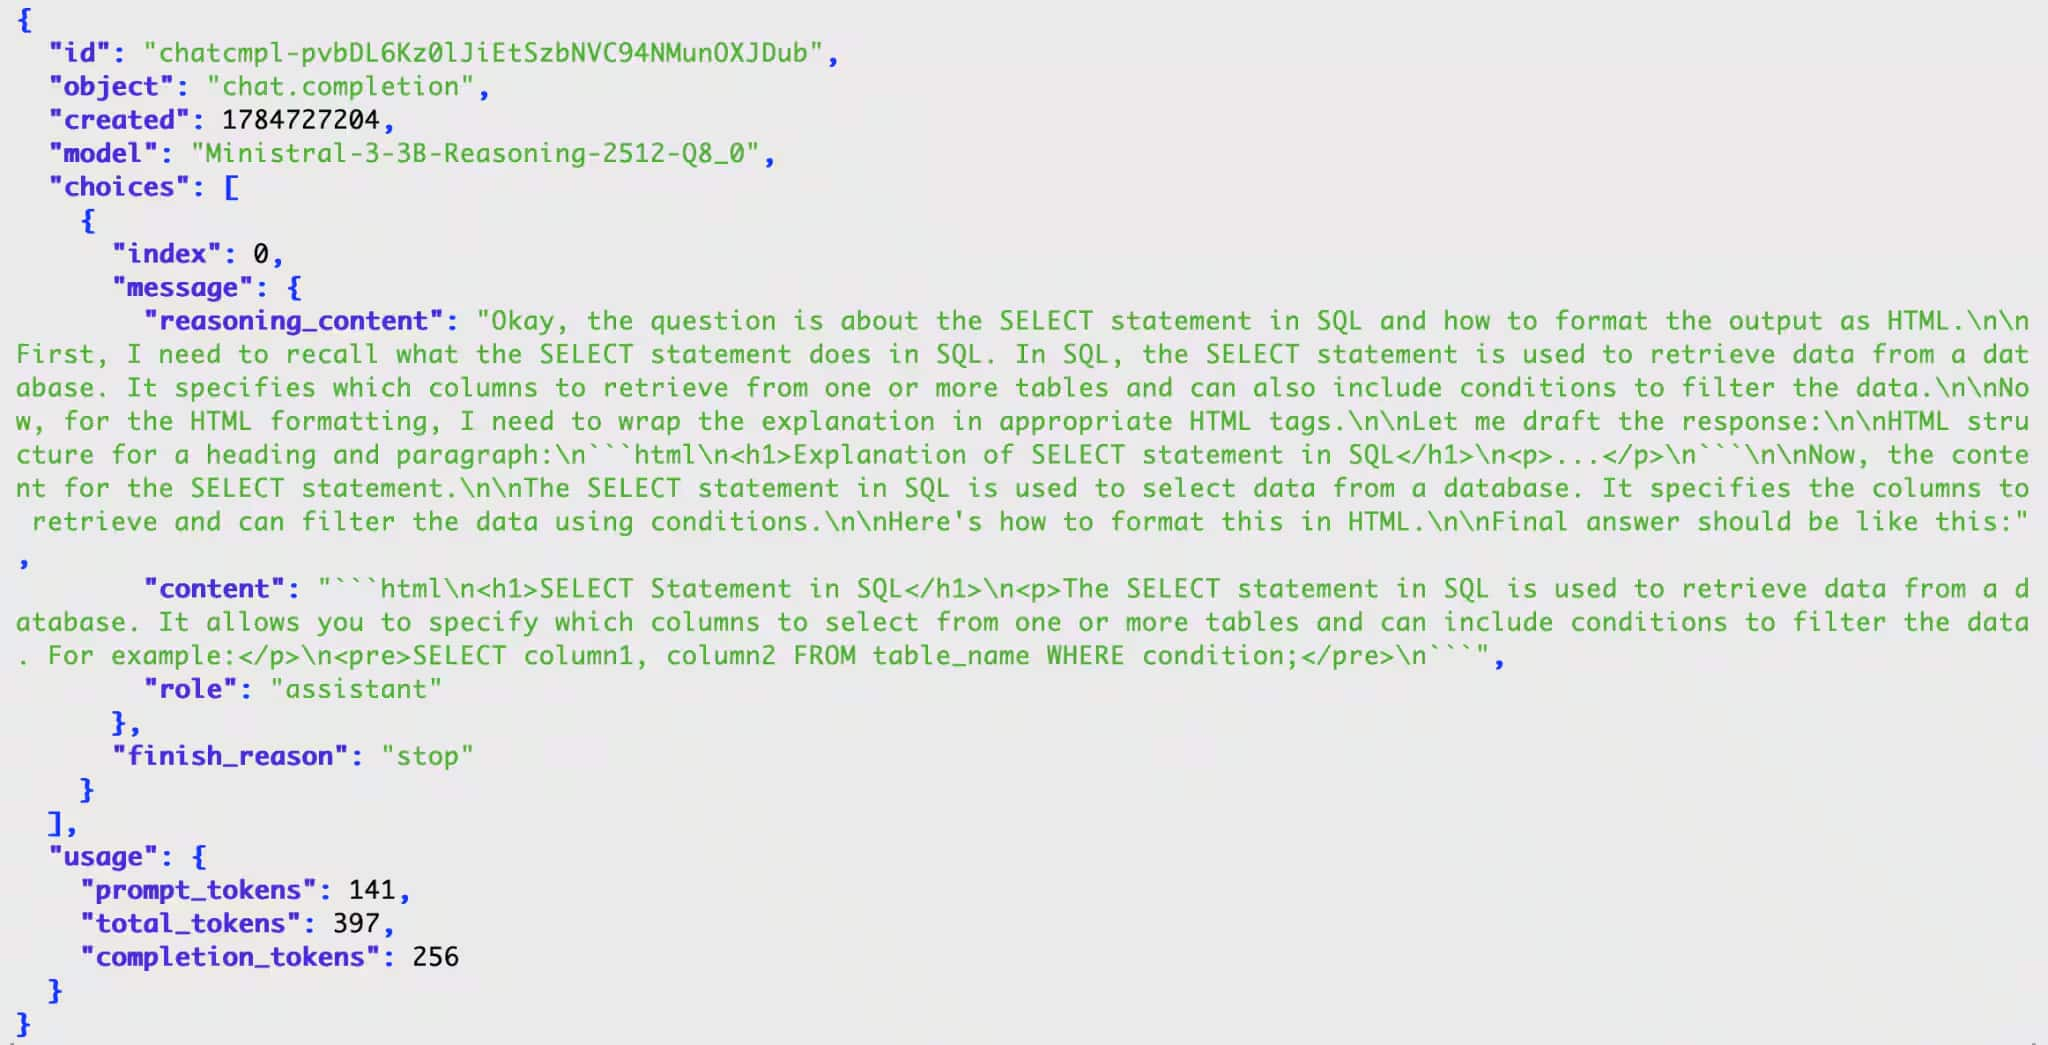
- この例では、このブログで説明されている構成を使用した場合、レスポンスに約18秒かかりました。結果は、モデル、構成、プロンプト、ワークロード、および使用可能なコンピュート・リソースによって異なります。
- 大規模なLLMほど、リクエストへの応答に時間がかかる傾向があります
- ワークロードおよび構成によっては、CPUリソースを追加することでレスポンス時間を短縮できる場合があります
- 今後予定されている投稿では、他のLLMについて取り上げます
出力はLLMによって異なります。この例では、次のようになります:
- content shows the HTML like formatted answer
Chromeでレンダリングされるコンテンツ・セクションのHTMLは次のようになります:
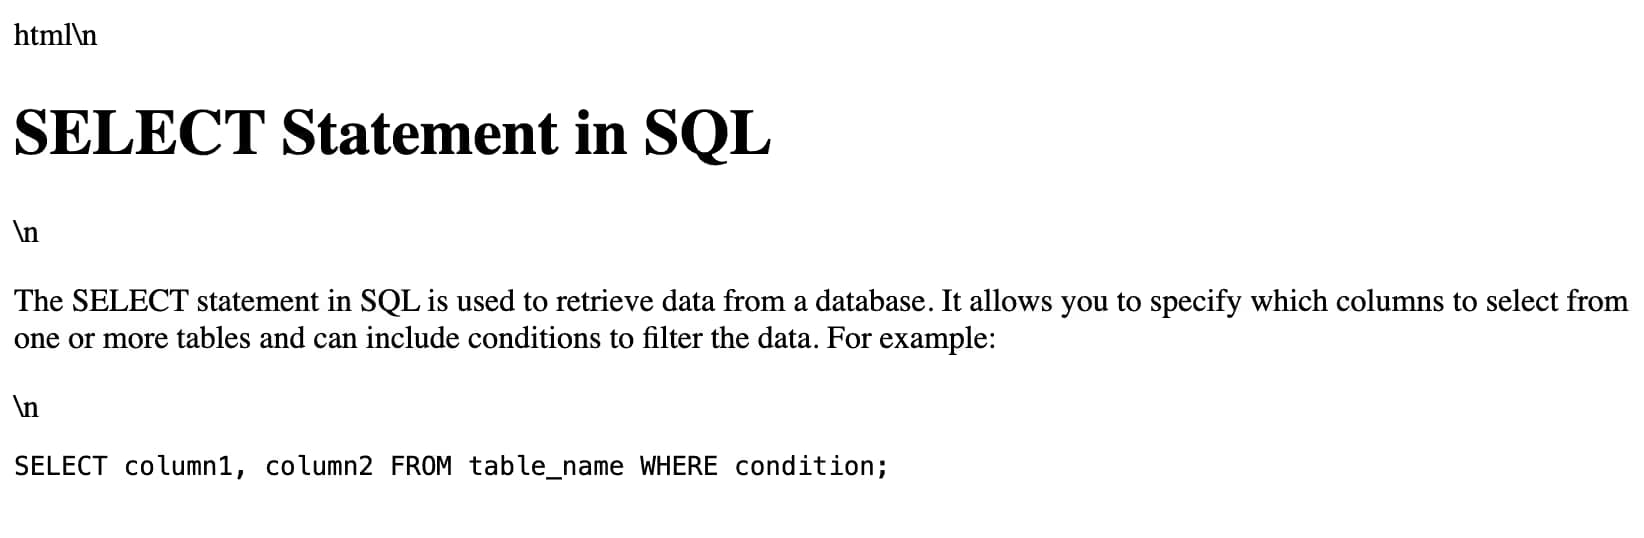
したがって、簡単な答えは「正解」ですが、HTMLは最適ではありませんでした。
パート2では、他のオープンウェイトLLMからのより適切な形式の回答を確認できます。
9. 概要
このブログでは、CPUを搭載したOCI VM上のPrivate Large Language Model Serviceをダウンロード、インストール、構成およびチャットする方法を学習しました。また、HTTP用のcURLユーティリティを使用してLLMとチャットする方法も学習しました。
このブログのパート2は、次のような内容をカバーしています:
- ストリーミング・チャットの使用
- llama.cpp用のモデルのダウンロード
- vLLM用モデルのダウンロード
- Hugging Faceトークンの使用
- SSLの使用
関連ブログ
- プライベートLLMサービスのスタート・ガイド – パート2
- Private LLM ServiceでのDBMS_VECTOR_CHAINの使用