※ 本記事は、Kelly Smithによる”AI-Assisted Cloud Protect: Recover an On-Premises Oracle Database to OCI After an Outage“を翻訳したものです。
2026年11月8日
元の場所とは異なる環境への復旧を成功させるには、実際の障害が起きるずっと前に、準備と復旧訓練を済ませておく必要があります。復旧先を構成し、確実にデータベースを復旧するために、復旧メタデータ、セキュリティ関連のファイルや情報、アクセス権、検証済みの手順を復旧先に用意しておかなければなりません。
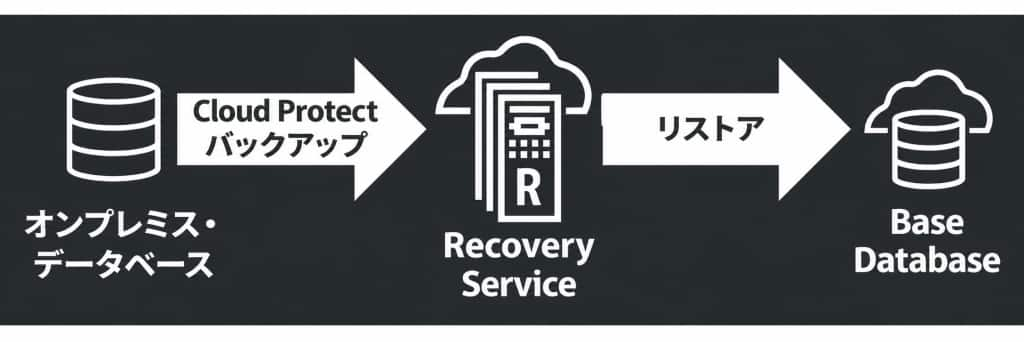
本記事では、オンプレミスで障害が発生した後、Oracle DatabaseをOCIの新しいBase Databaseシステムへ復旧するための準備と手順を説明します。この考え方は、OCIのExadata Database Serviceにも適用できます。復旧メタデータ、Recovery Serviceを通じたRMANによる特定時点への復旧、ボトルネック分析、リハーサルに焦点を当てます。
障害の前に復旧メタデータを準備する
別環境への復旧には、バックアップピースだけでは足りません。新しい復旧先環境で復旧するために、ソースから情報とファイルを集める必要があります。Oracle Recovery MCPサーバーを使い、収集手順の案内を受けられます。
Recovery Service MCPサーバーを使う前に、GitHubリポジトリ(https://github.com/oracle/mcp/tree/main/src/oci-recovery-mcp-server)の最新のインストール手順とAIクライアント設定手順に従ってください。
プロンプトを実行するデータベース管理者(DBA)には、ソースの構成を問い合わせ、収集対象の復旧用ファイルなどを読み取るためのOS権限とデータベース権限が必要です。AIクライアントは収集手順を案内できますが、提案された各コマンドと実行結果はDBAが確認しなければなりません。
AIクライアント(ChatGPTなど)で使用するプロンプトの例を次に示します。
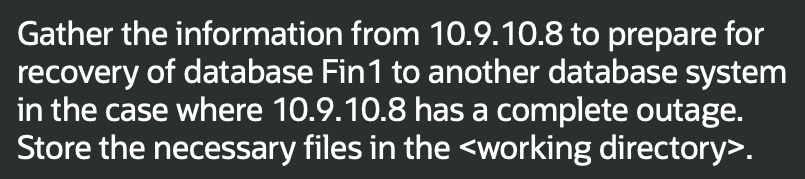
10.9.10.8が完全停止した場合に備え、データベースFin1を別のデータベース・システムにリカバリするために必要な情報を10.9.10.8から収集してください。必要なファイルを〈作業ディレクトリ〉に保存してください。
障害前に収集し、保護しておく情報とファイルの例は次のとおりです。
- TDEウォレットファイルとOracle Databaseパスワードファイル
- DBID、データベース固有名、データベースのバージョン、インカネーション
- ネットワークとOracle Netの詳細
- ストレージとASMの構成
- 使用可能な初期化パラメータファイルと制御ファイル
- RMAN環境の生成に必要なRecovery Serviceの接続メタデータ
ベストプラクティス:
- AIが提案したコマンドは、すべて実行前に確認し、収集したファイルなどがソースデータベースと一致することを検証してください。
- TDEウォレットとOracle Databaseパスワードファイルは、社内で承認されたシークレット管理または暗号化ストレージの手順で取得してください。AIクライアントにシークレットストアへの直接アクセスを与えたり、プロンプトやスクリプトにホストやデータベースの認証情報を平文で含めたりしないでください。
- 通常運用中に復旧手順を作成、検証し、データベースの変更に応じて復旧用の情報やファイルを更新してください。インシデント対応チームが、管理されたアクセスを通じて利用できるようにします。
OCIの別環境へ復旧する
オンプレミス環境が全面停止した場合、新しいOCI Base Databaseシステムを復旧先にできます。以下の概要手順は、検証済みの特定時点復旧の手順書で使用する制御を反映しています。
- 復旧先が正しいこと、利用可能なストレージ容量、ネットワークの分離を確認します。ASMシステムでは、ASMコマンドラインユーティリティでディスクグループの容量を確認します。復旧先ホストにすでにデータベースがある場合、削除を行う前に、明示的な承認を得て、そのデータベースを正しく特定してください。
asmcmd lsdg - TDEウォレット、Oracle Databaseパスワードファイル、復旧メタデータ、OCI認証情報を含む復旧パッケージを、安全な方法で復旧先に配置します。使用前に、配置したすべてのファイルなどの完全性を検証します。
- SQLclをインストールし、Recovery Service認証を設定して、保護対象データベースに対応する名前付きのRecovery Service接続で接続します。
- SQLclで、利用可能な復元範囲に承認済みの復旧時刻が含まれることを確認します。その後、RMANの復元テンプレートと環境ファイルを生成します。 SQL> rcv show restore_range
SQL> rcv configure rman_env - 生成されたRMAN環境ファイルを読み込みます。次に、rcv configure rman_envが返したRMANコマンドと復元テンプレートを使用します。 $ source <generated_path>/rman_env.sh
- ソースの識別情報と、復旧先固有のOracle Managed Files、ASM、ウォレットの構成を使い、補助データベースをNOMOUNTで起動します。 $ sqlplus / as sysdba
SQL> startup nomount pfile='<path_to_initialization_parameter_file>’; - 手順4の環境(rman_env)を使ってRecovery Serviceに接続し、標準のRMAN復元コマンドを実行します。ソースのDBIDを設定し、制御ファイルとデータベースを復元し、承認済みの時刻までリカバリして、RESETLOGSでデータベースをオープンします。以下は主要コマンドを示す抜粋であり、完全な復旧スクリプトではありません。
SET DBID <source_dbid>;RESTORE CONTROLFILE FROM AUTOBACKUP;ALTER DATABASE MOUNT;RUN { SET UNTIL TIME "TO_DATE('<approved_utc_time>', 'YYYY-MM-DD HH24:MI:SS')"; RESTORE DATABASE; RECOVER DATABASE;}ALTER DATABASE OPEN RESETLOGS;- 復旧したデータベース、PDB、ウォレット、復旧状態、データファイルの状態を検証します。アプリケーションの所有者が復旧時点を受け入れ、切替えを承認するまで、アプリケーションのトラフィックは分離したままにします。
ベストプラクティス:
- OCIシステムは協定世界時(UTC)を使いますが、オンプレミスシステムでは別のローカルタイムゾーンを使っている場合があります。承認済みのオンプレミス復旧時刻を、復旧対象日に有効な時差でUTCに変換してください。
- 復元範囲の出力に必要なUTC時点が明示的に含まれていなければ、処理を停止してください。復旧先ホストの現在時刻を復旧時点に使わないでください。
- データベースのサイズ、ネットワークのスループット、バックアップの配置、復旧先ストレージの性能、REDO量は、実際の復旧に大きく影響するため、ご自身の環境で必ずテストしてください。
- オンプレミスのインフラを再構築する間、OCIのデータベースシステムをアプリケーションワークロードの一時的な稼働先にできます。オンプレミスの準備が整ったら、Data Guardを使う移行など、管理された手順で戻す計画を立てられます。
復旧の構成を調整する
初回の復旧テストの後は、AIを使って復旧のボトルネックを特定することもできます。
図4のプロンプトでは、前節の復旧ワークフローとコマンドを参照し、RMANチャネルの追加で復元時間を短縮できるかを尋ねています。
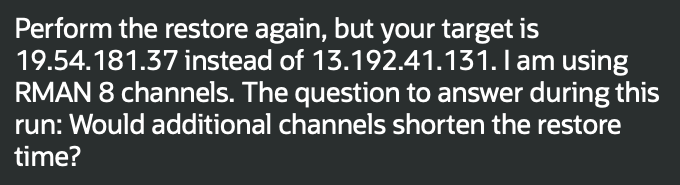
リストアを再度実行してください。ただし、リストア先は13.192.41.131ではなく、19.54.181.37とします。RMANのチャネルを8つ使用しています。今回の実行で検証する事項:チャネル数を増やすことで、リストア時間を短縮できるか?
図4:RMANチャネルの使用状況を監視するためのAIプロンプト
AIは、チャネルの活動、復旧の進捗、CPU、ネットワーク容量、復旧先ストレージのレイテンシの測定を支援できます。図5では、観測した指標に対するAIの分析から、復旧先への書込みレイテンシと、順序に従ったREDO適用が制約になっており、チャネルを増やしても復旧時間は大幅には短縮しないと示されています。たとえば、I/Oスループットを高めるため、Base Database Serviceのシェイプを変更します。RMANチャネルを増やす前に、ストレージのレイテンシを再テストしてください。
チャネル数を増やしても、今回のリストア時間は大幅には短縮されない。データファイルのリストア中は8つのチャネルすべてが稼働していたが、データファイルのバックアップ・ピースは17個しかなく、処理待ちのキューは短時間で空になった。アーカイブ・ログによるリカバリ中、各チャネルのリストア処理はREDOの適用処理より先行していた。例えば、リストアはシーケンス119に達していた一方、REDOの適用はそれより前のシーケンスを処理している段階だった。リストア中の測定では、リストア先でASMへの書き込み負荷も高かった。複数の基盤ストレージ・デバイスで使用率が約85~93%に達し、書き込み待機時間(write await)も長かった一方、CPUはほとんどアイドル状態だった。つまり、ボトルネックはRMANのチャネル数の不足ではなく、リストア先の書き込みレイテンシと、順序に従って実行されるREDOの適用処理にあった。
図5:RMANの活動とボトルネックに関するAI分析の結果
ご自身の環境で重要なシナリオをテストする
Data Guardのフィジカルスタンバイ、非CDBからPDBへの復旧、異なるバージョン間、異なるプラットフォーム間、RACの復旧では、構成、データベースバージョン、ストレージ設計、運用要件ごとに、管理されたリハーサルが必要です。ある構成でテストしたワークフローが、すべてのシナリオや環境でそのまま使えるとは考えないでください。
AIは構成の詳細を集め、レビュー可能なチェックリストを用意する支援ができます。ただし、これらのシナリオでは、適切な専門知識を持つ人のレビューと承認済みのテストなしに、復旧経路を選択したりコマンドを実行したりするべきではありません。
復旧リハーサルを通常運用の一部にする
復旧ワークフローは、リハーサルを行って初めて信頼できるものになります。Cloud ProtectとAutonomous Recovery Serviceは保護の基盤を提供しますが、復旧には依然として、適切な設計、安全なアクセス、正確なドキュメント、定期的なテストが必要です。
代表的なオンプレミスデータベースで、別環境への復旧リハーサルを必ず実施してください。復旧パッケージ、復旧先の受入れ環境、ネットワーク経路、ウォレットの取扱い、RMANワークフロー、復元後の確認項目を検証します。そのうえで、実測した復旧時間と、判明した制約を記録します。こうすることで、バックアップ戦略を、実際に復旧できる能力へと変えられます。
まとめ
Cloud ProtectとRecovery Serviceは保護の基盤を提供しますが、別環境への復旧を成功させるには、準備、安全なアクセス、正確な復旧メタデータ、検証済みの手順も必要です。障害前に必要な復旧用ファイルや情報を収集、保護し、要求する復旧時刻が利用可能であることを確認して、結果を検証します。また、AIを活用して性能上のボトルネックを特定します。本記事は、第1回で紹介した復旧に備えるバックアップ戦略を、テスト済みの復旧ワークフローに適用し、全2回のシリーズを締めくくります。
詳細情報
Oracle Database Autonomous Recovery Serviceのドキュメント
https://docs.oracle.com/en-us/iaas/recovery-service/doc/index.html
Cloud Protectのドキュメント
https://docs.oracle.com/en-us/iaas/recovery-service/doc/add-premises-database-recovery-service-using-cloud-protect.html
Recovery Service MCPサーバー
https://github.com/oracle/mcp/tree/main/src/oci-recovery-mcp-server
Base Database Serviceのスケーリングに関するドキュメント(https://docs.oracle.com/en/cloud/paas/base-database/scale-dbs/index.html)
AskTOMセッション。AIを使ったCloud Protectの構成と復旧の例を含みます。
https://youtu.be/eFiVlqFKtkM