※ 本記事は、Chaitanya Koratamaddi, Roopesh Thokalaによる”Oracle APEX 26.2: Working with Generative AI Provider APIs and Reasoning Effort“を翻訳したものです。
2026年11月9日
Oracle APEXのAIエージェントでは、生成AIサービス、指示、ツールを組み合わせ、アプリケーションのデータを使った作業を支援します。たとえば、カスタマーサポート用エージェントで、注文の詳細を取得し、配送状況を確認・更新して、その情報を基に質問へ回答できます。開発者は、エージェントに使わせるツールを設定します。生成AIモデルが必要に応じてオンデマンドのツールを要求すると、APEXで実行し、結果をモデルに返します。
Oracle APEX 26.2では、この機能を拡張し、生成AIサービスのProvider APIと、AIエージェントおよびプログラムからのAI要求に対するReasoning Effort設定に対応しました。サービスで使うプロバイダーAPIを選び、対応するモデルがタスクにどの程度の推論を行うかを調整できます。
Responses APIへの対応により、生成AIサービスで選べるAPIが増えました。
Provider APIでは、OpenAIや、OCI Generative AIの対応モデルなどでResponses APIを選べます。Google Geminiには、Interactionsへの対応を追加しました。
Oracle APEXで、選択したAPIのエンドポイントとリクエスト・レスポンス形式を処理するため、APEXのAIコンポーネントとPL/SQL APIから利用できます。
Reasoning Effortでは、AIエージェントがタスクを処理する際に、対応モデルで行う推論の強度を設定します。エージェントごとに指定するため、同じ生成AIサービスを使っていても、異なる強度を設定できます。APEX_AI.GENERATEやAPEX_AI.CHATの呼び出しでも指定でき、AI Request Handlerでリクエストごとに調整することもできます。対応する値は、プロバイダー、API、モデルによって異なります。
本記事では、まず生成AIサービスのProvider APIを設定し、続いてエージェントの推論の強度を設定・実行時に変更する方法を説明します。Oracle APEXからAIプロバイダーへの通信には、REST APIを使います。従来から、OpenAIのChat Completions API、Google GeminiのgenerateContent API、OCI Generative AIのGeneric APIと連携しています。
図1:Oracle APEX 26.2のProvider APIとReasoning Effort
生成AIサービスでResponses APIを使う
Provider APIを理解する
Oracle APEXからAIプロバイダーへの通信には、REST APIを使います。既存の連携には、OpenAIのChat Completions API、Google GeminiのgenerateContent API、OCI Generative AIのGeneric APIがあります。
APEX 26.2では、OpenAIと互換プロバイダー向けに、Responses APIへの対応を追加しました。OCI Generative AIの対応モデルも含まれます。Google Geminiには、Interactions APIへの対応を追加しました。APEXから、これらのプロバイダーのAPIを使えるようにしたものであり、Oracle APEX独自のREST APIを新設したわけではありません。
Provider APIで、生成AIサービスが使うAPIを選びます。対応するエンドポイントとリクエスト・レスポンス形式はAPEXで処理します。Responsesを選ぶとプロバイダーとの通信方法は変わりますが、エージェントのツール実行の流れは変わりません。対象のプロバイダーでは、Chat Completionsも引き続き選べます。
OpenAIでは、新規の連携にはResponsesを推奨しています。
「Chat Completionsは引き続きサポートしますが、すべての新規プロジェクトにはResponsesを推奨します。」 OpenAI移行ガイド
Googleも同様に、generateContentのサポートを続けつつ、新規プロジェクトにはInteractionsを推奨しています。Gemini Interactions APIの概要を参照してください。
注: APEXでは、Chat CompletionsとGeminiのコンテンツ生成の選択肢を非推奨と表示します。
Provider APIの選択肢
| AIプロバイダー | APEXで選べるProvider API | 新規サービスのデフォルト |
|---|---|---|
| OpenAI | Responses、Chat Completions | Responses |
| Generic OpenAI Compatible | Responses、Chat Completions | Responses |
| Ollama | Responses、Chat Completions | Responses |
| OCI Generative AI Service | Generic、Responses | Generic |
| Google Gemini | Interactions、従来のgenerateContent API | Interactions |
| Anthropic Claude、Mistral AI、Cohere | 既存の連携を使用し、Provider APIの選択は追加しない | 変更なし |
Responsesを選ぶ前に、利用するエンドポイントが対応していることを確認してください。Generic OpenAI CompatibleやOllamaとして設定するサービスも同様です。
前提条件
生成AIサービスを作成・編集できる、APEX 26.2のワークスペースを使います。選んだプロバイダーの認証情報と、使いたいAPIおよび推論設定に対応するモデルへのアクセスが必要です。
例1:OpenAIサービスを設定する
手順1:サービスを作成・編集する
Workspace Utilities → Generative AI Servicesへ進み、サービスを作成または編集します。Nameを入力し、AI ProviderにOpenAIを選びます。
手順2:接続情報を入力する
アカウントで利用可能なモデルから、ResponsesとHighの推論の強度に対応するmodelを選び、必要なCredentialを選択または作成します。
手順3:Provider APIを選ぶ
AdvancedのProvider APIをResponsesにします。本記事の後半のPL/SQL例では、Static IDにmy-ai-serviceを使います。
Test Connectionをクリックし、サービスを保存します。Base URLにはAPEXでリクエストのパスを追加するため、この欄に/responsesを付けないでください。
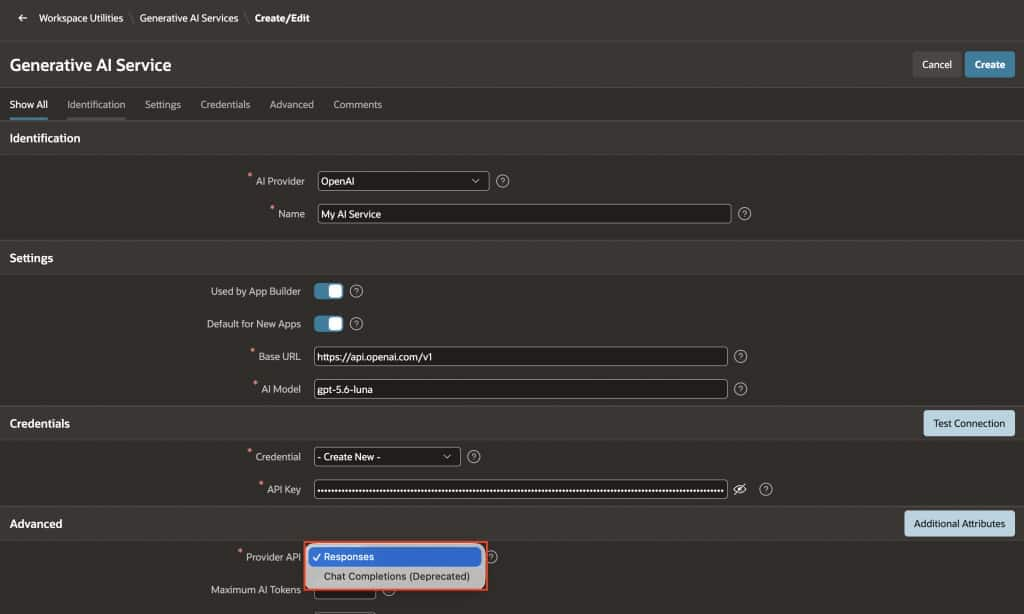
図2: Responses APIを使うOpenAIの生成AIサービスを設定する画面。
例2:OCI Generative AIサービスを設定する
OCI Generative AIでは、対応APIがモデルごとに異なるため、Provider APIのデフォルトは引き続きGenericです。モデルと用途に応じて必要な場合に、Responsesを選んでください。
APEX 26.2では、OCIの設定も簡素化しました。Compartment ID、AI Model、Serving Modeは、Additional AttributesのJSONではなく、サービスのプロパティに保存します。Serving Modeには専用の欄を用意し、On-DemandとDedicatedを選べます。リクエストのJSONは実行時にAPEXで作成し、Responsesの場合は、コンパートメントの識別子をHTTPヘッダーで送信します。
手順1:OCIの前提条件を確認する
Responsesを使う前に、対象リージョンでモデルを利用できることを確認します。必要なOCI Generative AIプロジェクトを作成し、サービスの認証情報にIAM権限を設定します。OCI Responses APIガイド、クイックスタートガイド、対応モデルとリージョンを参照してください。
手順2:サービス情報を入力する
生成AIサービスを作成・編集し、AI ProviderにOCI Generative AI Serviceを選びます。Compartment IDとRegionを入力し、Serving Modeを選択します。
On-Demandでは、使うモデルを選びます。Dedicatedでは、専用エンドポイントのEndpoint IDを入力します。サービスのCredentialを選び、リージョンのBase URLを入力します。
たとえば、シカゴではhttps://inference.generativeai.us-chicago-1.oci.oraclecloud.comを使います。APEXで、選択したProvider APIに応じたパスを追加するため、OCIのOpenAI SDKの例にある/openai/v1を付ける必要はありません。
2つの提供モードと専用ホスティングの設定は、OCI Generative AIの提供モードを参照してください。
手順3:Provider APIを選ぶ
AdvancedのProvider APIにResponsesを選び、Project IDにOCI Generative AIプロジェクトのOCIDを入力します。Responses APIでは、この欄は必須です。まだプロジェクトがない場合は、プロジェクトの作成の手順に従ってください。
Test Connectionをクリックし、サービスを保存します。
注: プロバイダー側で保持する会話履歴やメモリは、このAPEX機能の対象外です。Project IDを入力しても、APEXでそれらが有効になるわけではありません。
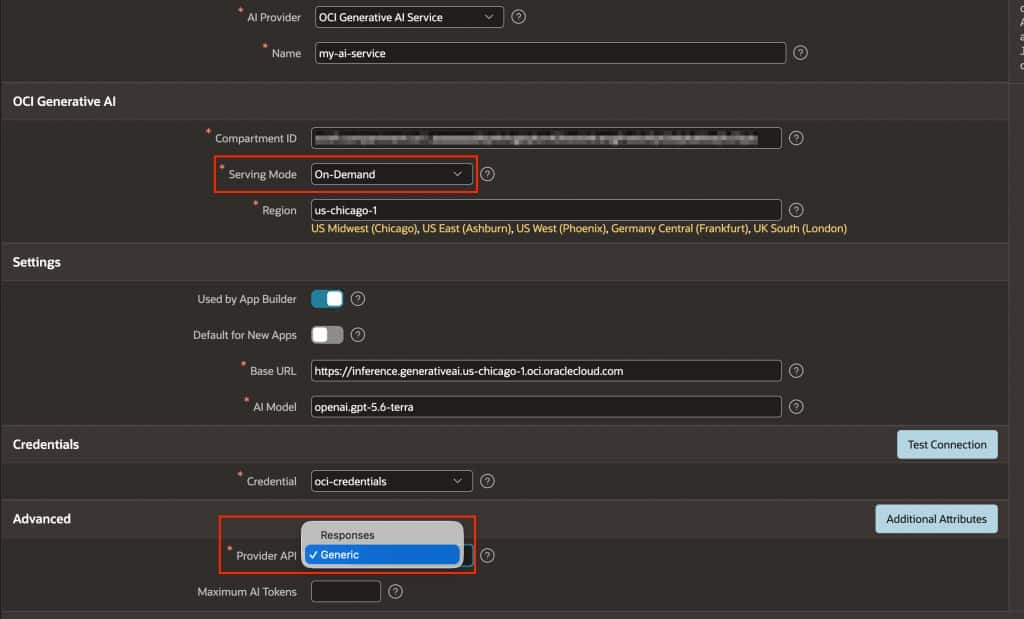
図3: Responses APIを使うOCI Generative AIサービスを設定する画面。
アップグレード後の既存サービス
アップグレード時、対象となるOpenAIサービスのProvider APIをResponsesに、GeminiサービスをInteractionsに設定します。自動変更の対象は、独自のAdditional AttributesもHTTP Headersもないサービスです。独自設定がある場合は、手動で変更する前に内容を確認し、API固有の属性やヘッダーを更新してください。
Additional AttributesのないGeneric OpenAI CompatibleとOllamaのサービスも、Responsesへの自動変更の対象です。独自のAdditional Attributesがあるサービスは、従来のAPIを維持します。手動で切り替える前に、属性を見直し、エンドポイントがResponses APIに対応することを確認してください。
OCIサービスはGenericのままです。コンパートメント、モデル、提供モードの値は、Additional Attributesから対応するサービスのプロパティへ移します。その他の独自属性は保持します。
推論の強度(Reasoning Effort)
Reasoning Effortを理解する
Reasoning EffortはThinking Levelとも呼ばれ、対応モデルが回答を生成したり、次に呼ぶツールを決めたりする前に、どの程度推論するかを制御します。
低い強度では、応答時間とトークン使用量を抑えられる可能性があります。高い強度は、リリース計画の依存関係の確認などに役立つ場合がありますが、通常は時間とトークンがより多く必要です。タスクとモデルに応じて選び、高くする前に結果をテストしてください。
APEXでは、次の3か所で設定できます。
- AI Agent: AdvancedでReasoning Effortを設定します。
- PL/SQLの呼び出し:
APEX_AI.GENERATEまたはAPEX_AI.CHATにp_reasoning_effortを渡します。 - AI Request Handler: 送信するリクエストの
reasoning_effortフィールドを実行時に設定します。
設定できる値
| Reasoning Effortの設定 | APEXで使う値 |
|---|---|
| Default(デフォルト) | NULL:推論の強度を明示的には送信しない |
| None(なし、プロバイダー固有) | none |
| Minimal(最小、プロバイダー固有) | minimal |
| Low(低) | low |
| Medium(中) | medium |
| High(高) | high |
| Extra High(さらに高、プロバイダー固有) | xhigh |
| Maximum(最大、プロバイダー固有) | max |
Defaultでは、プロバイダーとモデルの既定の動作に任せます。推論を明示的に無効にする設定ではありません。既存のエージェントは、アップグレード後もこのデフォルトを維持します。
Oracle APEXでは、すべてのプロバイダーに対して一覧全体を表示します。モデルやAPIに応じた絞り込みは行わないため、選んだ値に対応していることを確認してください。Extra HighとMaximumは別の値です。
AIサービスごとの対応
次の表は、APEXの各連携での対応を示します。受け付ける値は、モデルとAPIによって異なります。
| サービス | APEXのReasoning Effortへの対応 |
|---|---|
| OpenAI | APEXの推論の強度の連携にはResponsesを使います。 |
| OCI Generative AI | OpenAIモデルにはResponsesを使います。対応するOpenAI以外のモデルでは、Generic APIのreasoningEffort制御を使えます。 |
| Google Gemini | Interactions APIとの連携を通じ、対応モデルのthinking levelを利用できます。 |
| Anthropic Claude | 既存のプロバイダー連携で対応し、Responses APIを選ぶ必要はありません。 |
| Mistral AI | 既存の連携でreasoning_effortに対応し、Responses APIを選ぶ必要はありません。 |
| Ollama、Generic OpenAI Compatible | 選んだAPIと推論の制御を実装した、エンドポイントとモデルが必要です。 |
| ネイティブのCohere連携 | この設定には未対応です。Cohereの数値によるthinking-token上限は、この機能では実装していません。 |
たとえば、Mistralの推論のドキュメントではnoneとhighを説明していますが、Geminiのthinking levelはモデルごとに異なります。Mistralの推論ガイド、Geminiのthinkingガイド、Claudeのeffortガイドで、使うモデルが受け付ける値を確認してください。
AIエージェントに強度を設定する
Generative AI Agentを開き、使う生成AIサービスを選びます。AdvancedのReasoning Effortを選択し、Apply Changesをクリックします。
OpenAIサービスでは、Provider APIがResponsesになっていることを確認してください。選んだモデルが対応する強度を指定し、代表的なタスクを実行して、回答と応答時間を比較してから、必要に応じて高くします。
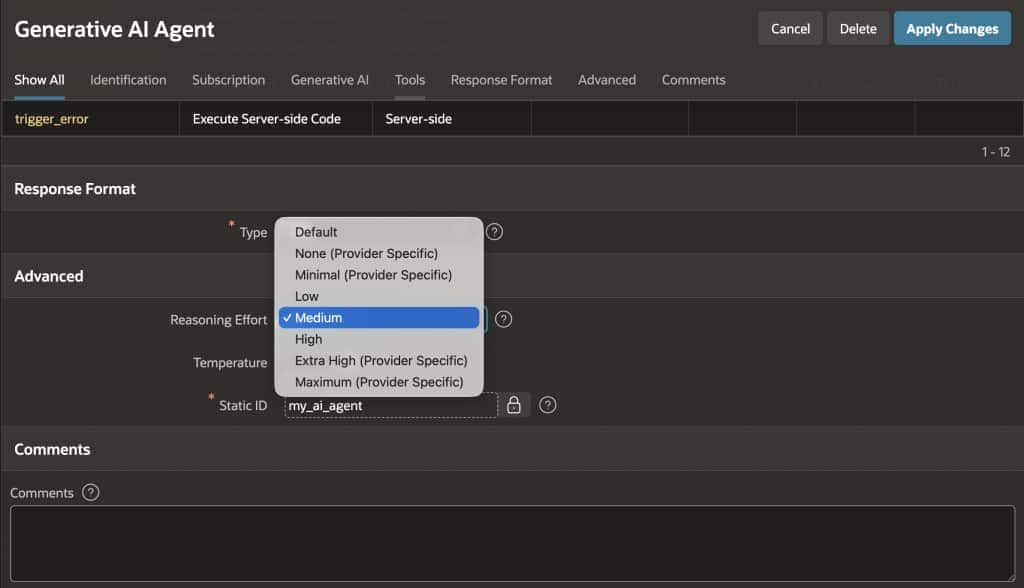
図4: エージェントの推論の強度を選択する画面。
PL/SQLで強度を設定する
PL/SQLの呼び出しでも、直接指定できます。
次の例では、前に設定したサービスをAPEX_AI.GENERATEから使い、Highを要求します。
declare
    l_response clob;
begin
    l_response := apex_ai.generate(
        p_prompt => 'Review this release plan and identify '
                 || 'missing dependencies: develop, test, '
                 || 'approve, deploy.',
        p_service_static_id => 'my-ai-service',
        p_reasoning_effort => apex_ai.c_reasoning_effort_high
    );
    dbms_output.put_line(dbms_lob.substr(l_response, 4000, 1));
end;
/my-ai-serviceがあるワークスペースのSQL Workshop → SQL Commandsで実行します。
サービスを直接呼び出し、回答の先頭4,000文字を表示します。
モデルがHighの強度に対応している必要があります。
APEX_AI.CHATにも同じパラメーターがあります。
APEXでは、none、minimal、low、medium、high、xhigh、max用に、apex_ai.c_reasoning_effort_で始まる定数を用意しています。
パラメーターのデフォルトはNULLです。
詳しくは、公式のAPIリファレンスを参照してください。
実践のヒント:実行時に推論の強度を変える
リクエストやアプリケーションの状況に応じて変える場合は、AI Request Handlerを使います。AI Agentや生成AIサービスの保存済み設定を変えずに、送信するリクエストを変更できます。
利用するには、次を用意します。
- 対応する強度の値: アプリケーションのロジックで値を決めます。ページアイテムから取得する場合は、AIコンポーネントのItems to Submitにそのアイテムを含め、ハンドラーからセッション状態を読めるようにします。
- ハンドラープロシージャ: 下記の必須インターフェースを使い、
p_result.request.reasoning_effortに値を代入します。 - アプリケーション設定: Edit Application Definition → AI → Request Handler Procedureに、プロシージャ名を入力します。
procedure ai_request_handler (
    p_param  in            apex_ai.t_chat_request_handler_param,
    p_result in out nocopy apex_ai.t_chat_request_handler_result
)
as
begin
    if p_param.component.static_id = 'p100-show-ai-assistant' then
        p_result.request.reasoning_effort :=
            v('P100_REASONING_EFFORT');
    end if;
end ai_request_handler;APEXでは、コンポーネント固有のリクエスト処理が終わった後、AIサービスへ送信する前に、アプリケーションのハンドラーを毎回呼び出します。p_paramには要求の文脈を、p_result.requestには変更可能な送信リクエストを渡します。ハンドラーはアプリケーション全体に適用されるため、条件を設け、意図したリクエストだけを変更してください。
値は、選んだプロバイダー、API、モデルが対応するものである必要があります。ハンドラーのインターフェースと設定は、生成AI属性の設定を参照してください。reasoning_effortフィールドは、APEX 26.2の機能です。
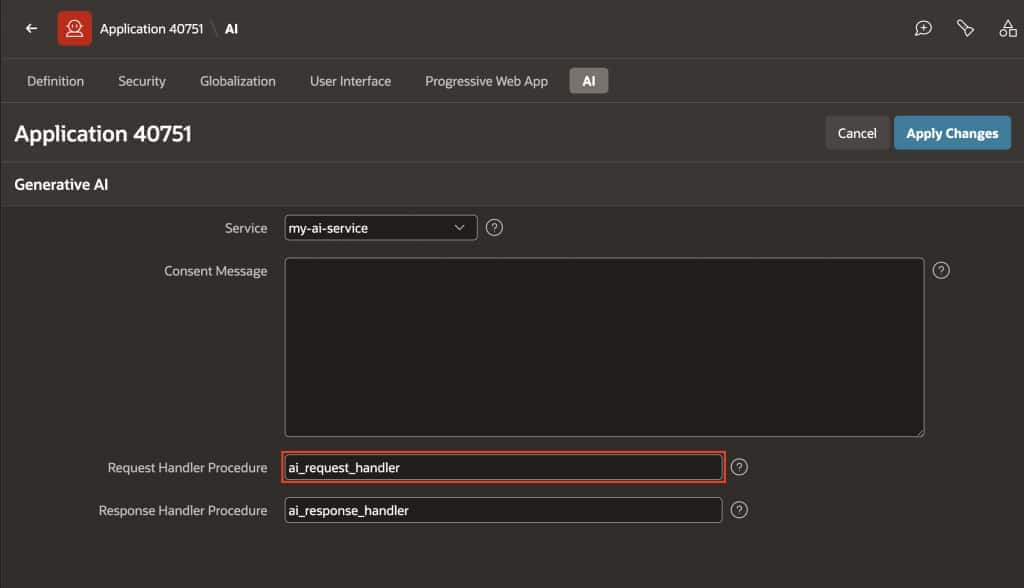
図4: ページで選んだ推論の強度を、送信するAIリクエストに適用する画面。
2つの機能を組み合わせる
OpenAIを使うエージェントでは、生成AIサービスのProvider APIをResponsesにし、エージェントにReasoning Effortを設定します。APEXから、選んだ強度を付けてResponses APIへ送信し、引き続き、エージェントに設定したツールを実行します。
強度を比較するには、同じモデルで同じタスクを、LowとHighなど、対応する2つの値で実行します。
回答、応答時間、トークン使用量を確認してください。リクエスト間で一定にするならエージェントの設定を使い、実行時に選ぶ必要があるなら、PL/SQLパラメーターやAI Request Handlerを使います。