※ 本記事は、Brijesh Deoによる”When APIs Run for Hours: Building Reliable Event-Driven Workflows with Oracle MicroTx and TxEventQ“を翻訳したものです。
2026年11月4日
多くのAPI呼出しは数秒で完了します。難しいのは、それが起動する処理に数時間、あるいは数日かかる場合です。スマートフォンから2秒で送信した保険金請求を考えてみてください。損害の査定、保険契約の限度額の確認、不正チェック、査定担当者の対応、保険金の支払いには、はるかに長い時間がかかります。Claims APIはすぐに202 Acceptedを返せますが、それは受領の確認にすぎず、業務上の約束を果たしたことにはなりません。 本記事では保険金請求の流れを例に、請求98371が送信され、査定、支払処理、入金確認に至るまでを追います。クライアントに見えるのは、短い呼出しと追跡IDです。その裏では、各サービスが文書を解析し、AIモデルを実行し、不正を確認し、人の判断を待ち、支払額を計算し、銀行の確認を待つ必要があります。HTTPのライフサイクルが終わった後、この責任を接続やスレッドに持たせることはできません。プロセスには、永続化された状態、明示的な契約、意図的に設計された復旧モデルが必要です。
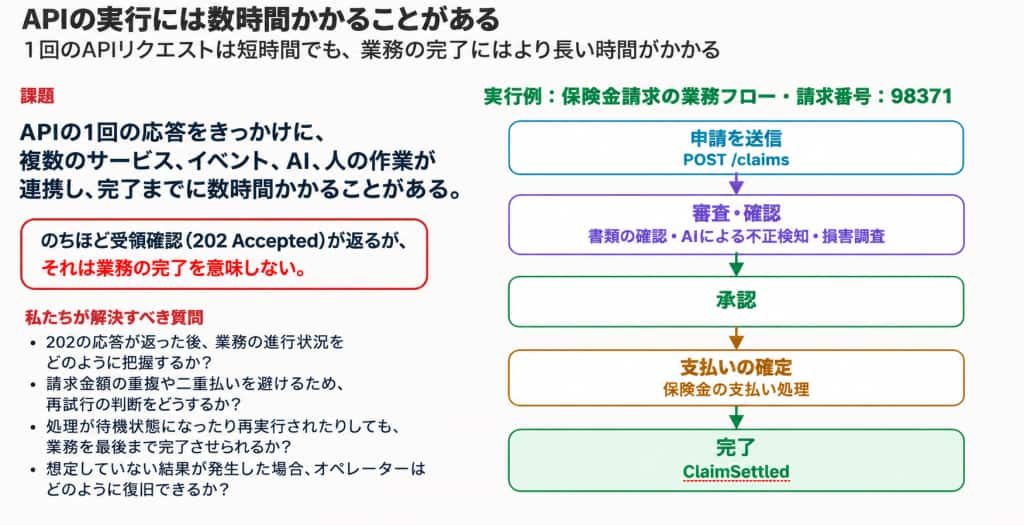
図1. 短いAPIリクエストから、長時間にわたる保険金請求の処理が始まる場合がある
長時間のプロセスにワークフローが必要な理由
短いリクエストとレスポンスのやり取りは、単一のサービスで処理できます。しかし、処理が複数のサービス、人、イベント、長い待機にまたがる場合、単一サービスは調整の単位として適しません。Claims APIは、請求IDと操作またはステータスの参照先を返し、速やかに応答すべきです。その後の業務上の責任は、永続的なワークフローが引き継ぎます。
検証、文書分析、不正検知、支払いといった業務機能は、引き続き各サービスが担当します。ワークフローは、実行順序、永続化した実行状態、待機、再試行、タイムアウト、復旧ポリシーを担当します。請求98371では、支払いを開始したことを記録して確認を待てるため、HTTP接続やアプリケーションスレッドを開いたままにする必要はありません。ワーカーの再起動やデプロイが発生しても、請求処理全体をやり直さず、記録済みの状態から実行を再開できます。
保険金請求のアーキテクチャ
このアーキテクチャでは、業務上意味のある事実を境界として、査定と支払処理を意図的に分離します。査定では、請求を承認するかどうかを決定して記録します。支払処理では、支払いを作成して確認します。両者は担当者、障害の起こり方、リリースの頻度が異なるため、1つの実行ライフサイクルを共有すべきではありません。
POST /claims -> 202 Accepted + claimId + operationId -> Claim Assessment Workflow validate -> AI analysis -> fraud check -> human review (when required) -> persist approval -> TxEventQ: claim.approved -> Event Handler -> Claim Settlement Workflow create settlement -> initiate payment -> wait for confirmation -> update claim -> TxEventQ: claim.settled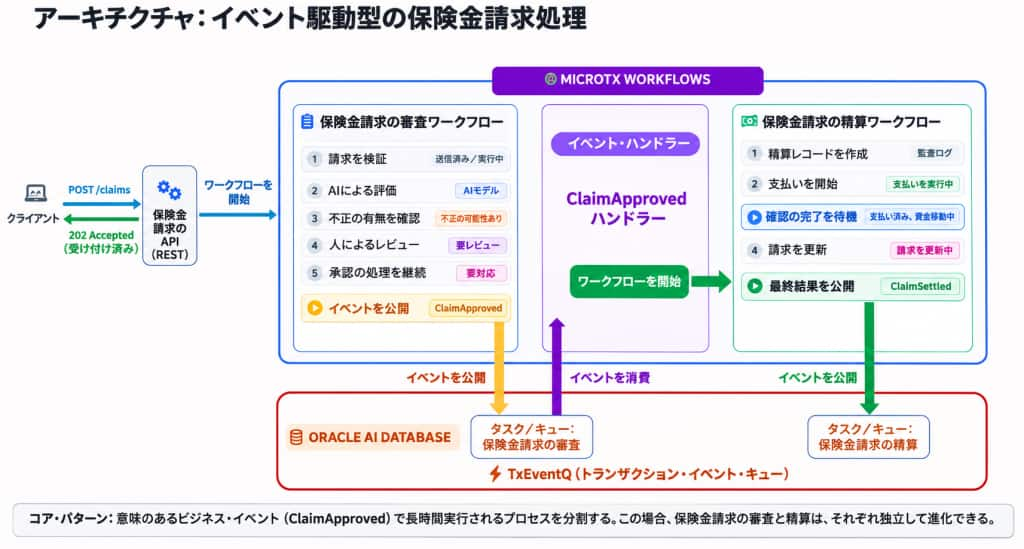
図2. イベント駆動の保険金請求処理アーキテクチャ
MicroTx Workflowsでは、査定ワークフローにHTTP、SQL、エージェント、人、待機のタスクを適宜組み込めます。承認を永続的に記録した後、TX EventQ PublishタスクがTxEventQトピックにclaim.approvedを発行します。イベントハンドラがイベントをフィルタし、入力をマッピングして、同じ相関IDで支払ワークフローを開始します。発行側は発生した事実を把握していればよく、それに反応するすべての利用側を知る必要はありません。
イベントを非同期APIとして扱います。業務上の事実を表す名前を付け、スキーマをバージョン管理し、繰返し処理と調査を安全に行うための識別情報を含めます。
{
  "eventType": "claim.approved",
  "eventVersion": "1.0",
  "eventId": "evt-98431",
  "correlationId": "claim-98371",
  "causationId": "evt-98122",
  "data": {"claimId": "98371", "approvedAmount": 12500}
}
eventIdは、重複排除のために、不変の1つのイベントを識別します。correlationIdは、API、イベント、ワークフローをまたいで請求を追跡します。causationIdは、直接の起動要因を識別します。これらを組み合わせることで、お客様から「私の請求はどうなっていますか」と尋ねられた際、運用担当者が必要な状況を把握できます。
この方法がより適している理由
短く原子的な処理には、同期APIの連鎖が依然として最も単純な選択です。しかし、業務上の結果が複数サービス、人の判断、長い待機、結果が不確定になり得る外部システムに依存すると、壊れやすくなります。既存設計の多くは、サービスを疎結合にするためキューを追加しますが、キューだけではメッセージを移動するにすぎず、業務プロセス、その状態、期限、復旧判断を管理しません。独自のSagaやオーケストレーションコードを構築するチームもあります。それでも動作はしますが、再試行、重複防止、補償、運用の可視性を、プロセスごとに異なる形で作り直しがちです。
MicroTx WorkflowsとTxEventQは、この種の問題に、より十分な方法を提供します。ワークフローが一連の処理を永続的に調整し、その状態を記録します。TxEventQは、明確な責任の境界を越えて、バージョン管理された業務上の事実を伝えます。
各サービスは、中央の1つのアプリケーションに取り込まれることなく、それぞれの業務機能を担当し続けます。これは魔法のような「厳密に1回」の実行をうたうものではありません。再試行と不確実性を前提に、繰返し実行を安全で説明可能にする設計です。
- 同期APIの連鎖と比べ、業務プロセスの待機中にリクエスト、スレッド、接続を保持し続けずに済みます。
- キューだけの連携とは異なり、順序制御、タイムアウト、人の承認、業務ステータスを永続的に調整します。補償はアプリケーションの明示的なロジックであり、外部への作用をXAで自動ロールバックするものではありません。
- 独自のオーケストレーションと比べ、各チームが作り直すのではなく、冪等性、再試行、期限、相関、復旧に対して、繰返し適用できる制御を提供します。
障害時にも安全なアーキテクチャにする
分散システムでは、すべての境界で完全な情報が得られるわけではありません。タイムアウトは処理が始まらなかった証拠ではなく、イベントの再配信も初回配信の失敗を意味しません。支払いの応答が失われても、支払いが失敗したとは限りません。少なくとも1回の配信を前提に設計し、繰返し実行を安全にします。よくある障害シナリオを見てみましょう。
障害1:クライアントが応答を受信できない
Claims APIは査定ワークフローを開始しましたが、応答が失われました。クライアントは請求98371が受け付けられたか分からないため、POST /claimsを再試行します。安定した識別情報がなければ、再試行で2つ目の査定が始まり、同じ請求に2つの判断が出る可能性があります。
この障害への対策: claim-request-98371など、論理的な申請を表すIdempotency-Keyを必須にします。クライアントキーと請求、ワークフロー実行の対応を永続化します。ワークフローの開始時にもそのキーを再利用することで、APIは再試行を同じ論理操作として解決し、処理を重複して始める代わりに同じステータスを返せます。
障害2:claim.approvedイベントが2回届く
発行側の再試行、ブローカーの再配信、利用側の再起動、確認応答の消失によって、イベントevt-98431が複数回届く場合があります。重複配信のたびに支払処理と送金が始まると、日常的なメッセージ再試行が、誤った金融取引になってしまいます。
この障害への対策: eventIdで受信イベントを重複排除し、ワークフロー開始の冪等性を確保して、イベントハンドラが重複した支払実行を作成できないようにします。MicroTxのTxEventQ Publishタスクなど、対応タスクではタスクレベルの冪等性を有効にします。独自のワーカーや外部への副作用には、引き続きワーカーまたは下流サービスでの冪等性が必要です。たとえば、支払サービスに業務キーとしてclaim-98371:settlementを渡します。この多層的な方法は、「厳密に1回」の処理という単一の約束に頼るよりも信頼できます。
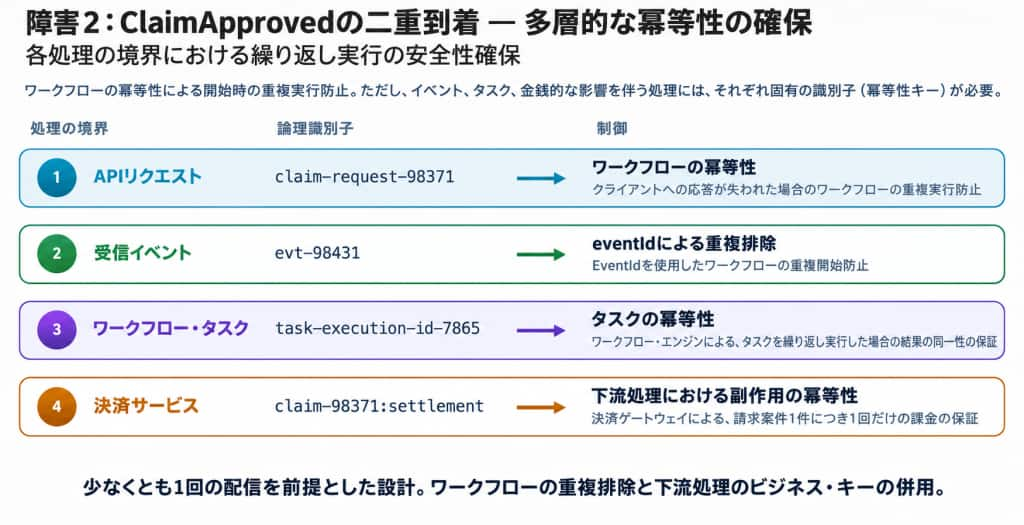
図3. APIリクエストから支払いの副作用まで、冪等性を各層で確保
障害3:支払いに成功した後、応答が失われる
支払ワークフローが12,500ドルを承認し、支払サービスは成功しましたが、ネットワーク上で応答が失われました。ワークフローから見ると結果が不明です。無条件に再試行すると二重払いの恐れがあり、タイムアウトを失敗と扱うと、完了済みの支払いが記録されない恐れがあります。
この障害への対策: 1回の呼出しのタイムアウトと、再試行の上限、未解決の支払処理に対する業務期限を分けます。一時的なエラーを再試行する際は同じ支払い冪等性キーだけを使用するか、再実行前に支払状態を問い合わせます。結果を安全に確定できない場合は、適切な補償、調査、人による確認という、明示的な例外経路に請求を送ります。補償は新たな冪等の業務アクションであり、分散ロールバックがすべてを直してくれると想定することではありません。
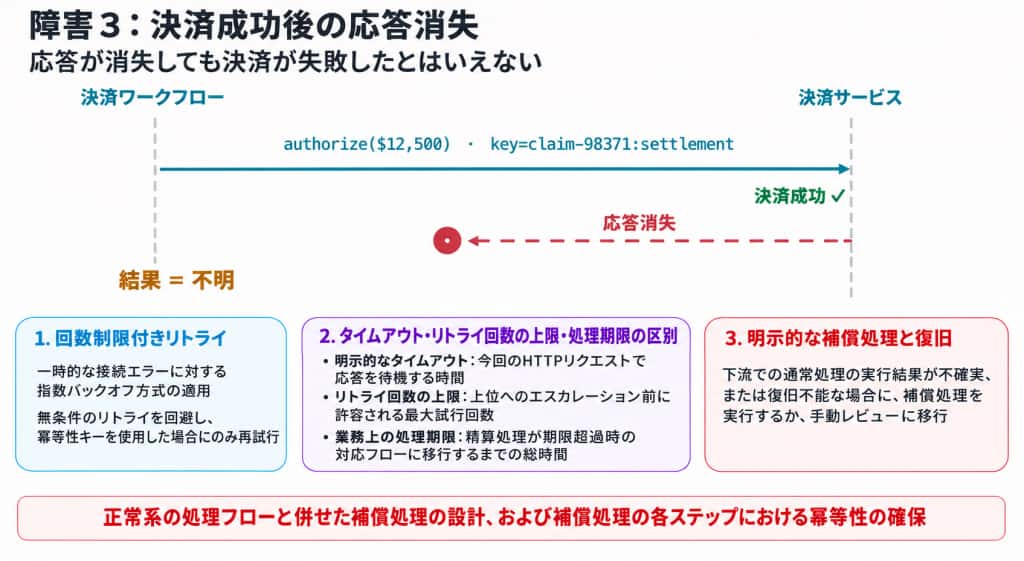
図4. 支払い結果が不明な場合の制御
本番環境で確実に運用する
本番運用への確信は、1件の業務プロセスを特定し、説明し、安全に復旧できることから生まれます。申請、査定ワークフロー、AI結果、人の判断、claim.approved、支払ワークフロー、支払試行、claim.settledをつなぐ請求のタイムラインを構築します。claimId、correlationId、ワークフローID、イベントID、下流の支払IDを、ワークフロー入力、イベントヘッダー、ログ、トレースに引き継ぎます。
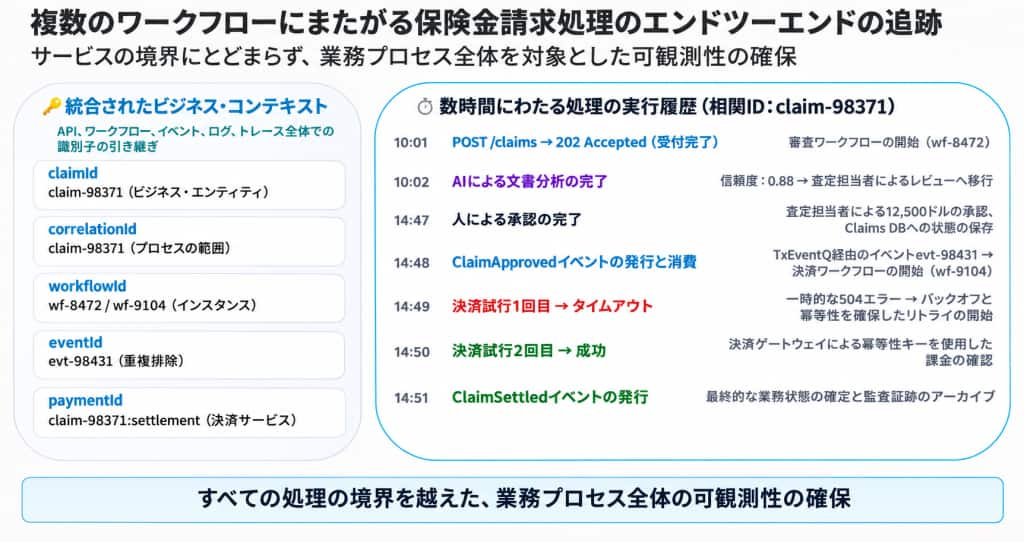
図5. API、ワークフロー、イベント、支払いにまたがる、相関付けされた数時間の請求処理。
- 業務状態を公開します。内部タスク名ではなく、SUBMITTED(申請済み)、UNDER_REVIEW(審査中)、APPROVED(承認済み)、SETTLING(支払処理中)、SETTLED(支払完了)、または明示的な例外状態を報告します。
- 対応が必要な結果に対してアラートを出します。ワークフローの期限超過、繰り返すタスク障害、イベントの滞留増加、重複イベントの割合、業務期限を過ぎても結果不明の支払いなどです。
- 復旧手順書を用意します。完了済みの手順を特定し、下流の支払状況を取得し、再試行、補償、人へのエスカレーションのどれが安全か判断して、同じ相関IDに運用担当者の操作を記録します。
決定論的な信頼性の制御内でAIを扱う
査定ワークフローでは、AIが事実を抽出し、損害を分類し、処理経路を推奨できますが、その出力は依然として信頼されていない入力です。請求98371では、構造化された結果と信頼度の範囲を検証し、証拠と判断の文脈を永続化したうえで、決定論的なポリシーによって、自動承認、査定担当者への振分け、結果の却下を決めます。取消しのできないアクション、特に支払いは、決定論的なワークフロー制御の内側に置きます。
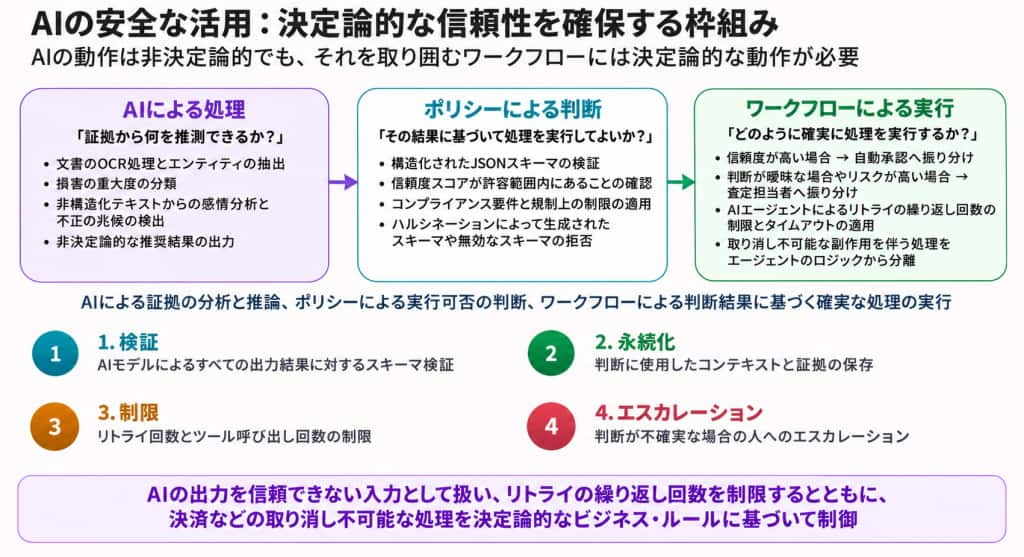
図6. AIを決定論的な信頼性制御の範囲内で動作させる
実装の設計図
長時間にわたるイベント駆動の業務プロセスに、この方法を適用するための実装手順を示します。
- POST /claimsを受け付け、論理的な冪等性キーを取得し、claimIdとoperationIdを含む202を返して、業務ステータスを公開します。
- Claim Assessment Workflowを開始して検証、分析、不正チェックを行い、ポリシーで必要な場合は人の承認を待ちます。イベントの発行前に承認を永続化します。
- Tx EventQ Publishタスクを使い、バージョン管理されたclaim.approvedを、eventId、correlationId、causationId、発生時刻、必要な業務データとともに発行します。
- TxEventQイベントハンドラでclaim.approvedをフィルタ、重複排除し、入力をマッピングして、ワークフロー開始の冪等性キーとともにClaim Settlement Workflowを開始します。
- 支払処理では、台帳レコードを永続化し、業務の冪等性キーで支払処理を呼び出し、確認または業務期限を待ち、請求を更新してclaim.settledを発行します。
- 本番対応と判断する前に、再試行の上限、タイムアウト、補償またはエスカレーション、相関、ダッシュボード、運用担当者向け手順書を整えます。
まとめ
202応答は、持続する責任の始まりです。保険金請求では、MicroTx Workflowsが、サービス、AI、人、待機、復旧にまたがって処理を引き継ぎます。TxEventQにより、査定と支払処理を独立して進化させられます。各層の冪等性、上限のある再試行、明示的な復旧、エンドツーエンドの相関によって、アーキテクチャを安全に運用できます。こちらからサンプル実装をお試しください。