※ 本記事は、Kumar G Varunによる”With Agent Engine, Catch Revenue and Service Exceptions Before They Affect Customers“を翻訳したものです。
2026年11月4日
Oracle AI Database Agent Engineの紹介
月曜日の午前8時5分、Northstar Industrial Servicesで、現地保守サービスの依頼が完了と記録されます。2分後、関連する請求書が作成されます。どちらの記録も正しく見えます。請求額は請求スケジュールと一致し、請求書は処理可能な状態です。しかし、最後のサービス記録には別の事情が書かれています。
暫定的な回避策を実施済み。設備の監視を継続すること。再訪問が必要になる可能性あり。
請求記録は、何を請求したかを示します。サービス記録は、実際に何が起きたかを説明します。どちらか一方だけを見ても、完全に解決していない作業についてNorthstarが顧客に請求しようとしている可能性は分かりません。人が手作業で両者を照合する頃には、請求書がすでに送付され、異議が出て返金処理されているか、暫定修理の箇所が再び故障しているかもしれません。
Northstar Industrial Servicesは架空の会社ですが、運用上の問題は典型的なものです。
Oracle AI Database Agent Engineの発表
本日、Oracle AI Database 26aiで一般提供されるOracle AI Database Agent Engineを発表します。
Oracle AI Database Agent Engineは、AIエージェントのワークフローを、その推論対象データのそば、データベース内で実行します。承認済みのSQLとPL/SQLツールが事実を確定し、Oracle AI Vector Searchが裏付けとなる記述を取得します。言語モデルはフローの定められた箇所だけで呼び出され、その作業用に集めた証拠だけを受け取ります。エージェントのワークフロー状態、トレース、リソース管理は、データベース自体で処理します。別のオーケストレーション層を構築し、保護し、データとの同期を維持する必要はありません。
データベースとは別のアプリケーション層で構築されたAIエージェントがこのワークフローを実行する場合、データから離れた場所で処理を行うことになります。そのため、データベース、オーケストレーション・コード、AIモデルの間でデータ行や中間処理結果を転送する必要があり、セキュリティやガバナンスの仕組みも複数のシステムで重複して実装しなければなりません。さらに、AIモデルの動作に対する制約が十分に設定されていない状態で、モデル自身が次に実行するクエリを判断する場合、処理の実行経路を予測することが困難になります。一方、データが存在する場所でエージェント型ワークフローを実行すれば、データベースとは別のアプリケーション層そのものを不要にできます。
以下では、代表的なユースケースを順に紹介します。
事例:Northstarの売上とサービスの例外
請求した内容と実際に起きたことの隔たりは、抽象的な問題ではありません。Northstarでは、異なる仕事を持つ2人が、この問題を担当しています。
請求担当リーダーのMaya: 彼女のチームは、請求データとサービスの利用状況を照合するために、何時間も費やしています。Mayaは、請求書が例外として検出された原因となるルールや不整合を明確にし、その判断を裏付けるサービスの利用実績データを添付した例外サマリーを必要としています。
売上管理責任者のElena: 返金、再請求、売上調整を承認する前に、事実、情報源、確認状況を保持した、説明のつく証拠が必要です。最終判断は引き続きElenaが行います。
共通の目標は、確かな例外を早期に特定し、明確に説明し、重大な業務アクションの決定権を人に残すことです。
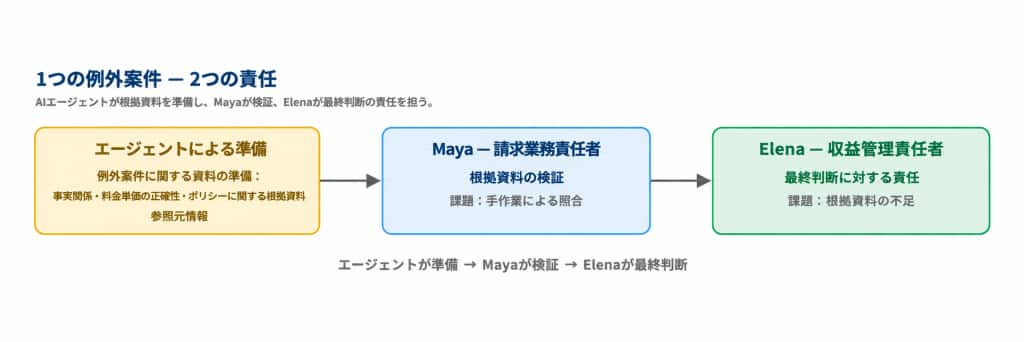
図1:エージェントが証拠を用意し、Mayaが検証し、Elenaが判断
売上とサービスの例外エージェントが実行する代表的なワークフローを示します。新規請求書イベントが、請求書IDと、会社のポリシーに照らして請求書を評価する指示を渡し、エージェントを呼び出します。Northstarのシナリオでは、Oracle AI Databaseが、管理されたデータと実行の基盤となります。請求記録、サービス記録、メモ、埋込み、ポリシー、エージェントのツールをまとめることで、Agent Engineは使用するデータのそばでワークフローを実行できます。
以下の処理は直線的な連鎖ではありません。ランタイムは独立した処理を並列の分岐に展開して事実を集め、文脈を組み立ててモデルを推論に呼び出し、ワークフローの次の手順へ進みます。
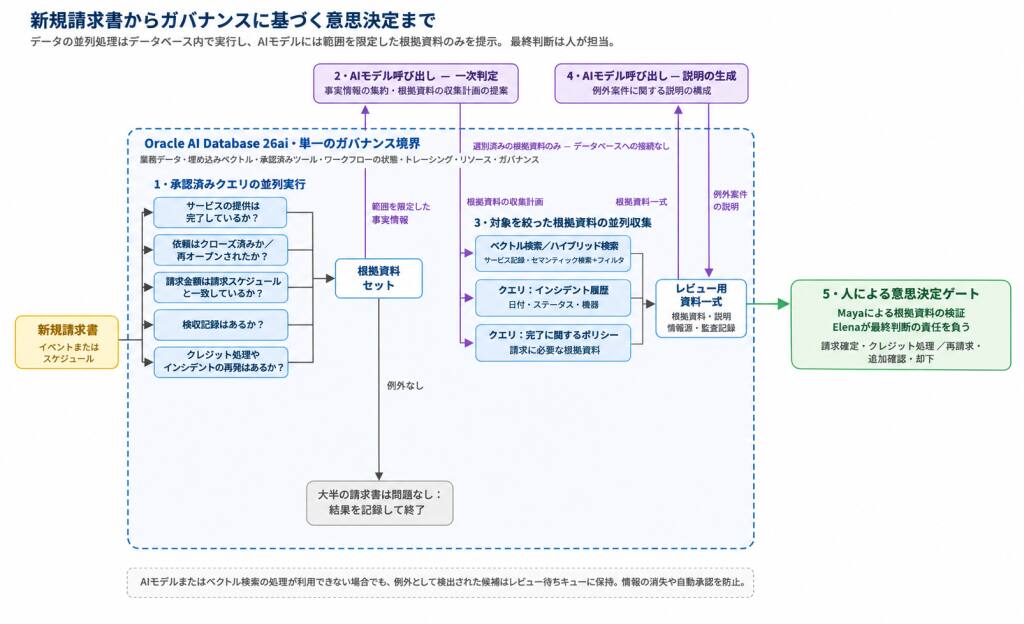
図2:データ中心の処理はデータベース内にとどまり、限定された証拠だけがモデルに渡り、人が判断
適切な調査と同じく、このフローも事実の確認から始まります。
1. 承認済みの問合せで、並列に事実を確定する
最初の段階で業務上の事実を確定します。各確認は独立しているため、エンジンは同時に実行します。
- 請求対象のサービスは、完了と記録されているか。
- サービス依頼はクローズ済み、再オープン、未解決のいずれか。
- 金額は適用対象の請求スケジュールと一致するか。
- 必要な場合、顧客の受入れが記録されているか。
- 関連する返金、再請求、繰返しのインシデントがすでに存在するか。
各確認は承認済みの問合せツールを使い、回答、関連ID、評価したルール、裏付け記録への参照という、小さな構造化結果を返します。請求額の計算、正式なサービス状態の確定、受入れ記録の有無の判断をモデルに任せることはありません。これらの正式な事実は、問合せと明示的な業務ルールから得ます。
Agent Engineは、モデルを使うステップも含め、独立したツールやサブフローを同時に実行できます。ただし、この段階にはモデルは不要です。
ほとんどの請求書では業務チェックに合格し、そこでフローが終了します。
業務上の意味: 大半の請求書は、決定論的なチェックだけで処理可能と判定されます。
Northstarの請求書は、チェックに合格しません。
2. 最初のモデル呼出しで、事実を計画に変える
Northstarのチェックでは、請求額は請求スケジュールと一致し、サービス依頼は完了扱いですが、顧客の受入れ記録がなく、同じ設備に関連するインシデントが存在することが分かります。異なる業務領域の事実を、ここで結び付ける必要があります。
ワークフローが初めてモデルを呼び出します。モデルが受け取るのは、完了したチェックの構造化結果と、許可されたポリシーラベルだけです。これらを短いトリアージ評価にまとめ、見かけ上の矛盾を説明する追加の証拠を特定することが役目です。たとえば、次のように返すかもしれません。
この請求書は金額面では有効ですが、裏付けとなるサービスの証拠が不十分な可能性があります。顧客の受入れ記録がなく、関連インシデントからは、完了ステータスが最終解決を表していない可能性が考えられます。レビューを推奨する前に、完了時のメモ、関連するポリシーの記述、関連インシデントの履歴を取得してください。
このモデル呼出しは、請求書を発行してよいかを判断しません。独立した事実を、作業仮説と焦点を絞った証拠収集計画に変え、エンジンがフローの許可された分岐と照合して計画を検証します。モデルは承認済みの追加調査経路から選べますが、新しいツールを作り出したり、制約のない表にアクセスしたり、財務アクションを承認したりはできません。
業務上の意味: AIが提案し、エージェントエンジンが制約を適用します。
3. 対象を絞った証拠を、再び並列に取得する
トリアージ評価に基づき、承認済みの3つの分岐を同時に実行します。
- サービスの記述。 Oracle AI Vector Searchで、暫定修理、監視要件、再訪問に関するサービスメモを取得します。意味の類似性に加え、キーワードと、顧客、資産、サービス依頼、日付などのリレーショナルフィルタを組み合わせます。
- インシデント履歴。 関連インシデントの詳細として、日付、設備ID、現在の状態、請求対象サービスとの関係を問合せで取得します。
- ポリシー。 適用される完了と顧客受入れのポリシーを問合せで取得し、サービスを最終請求の根拠とする前に必要な証拠を特定します。
各分岐は、広範なレコード群をモデルに送る代わりに、最も関連する証拠だけを返します。Northstarで決め手になるのは、暫定措置と再訪問の可能性を記した技術者のメモです。インシデントとポリシーの分岐から、以前の問題と受入れ要件も確認できます。
業務上の意味: セマンティック検索はデータのある場所で実行されます。コーパスを外部に出さず、追加または重複したデータや索引を保護、管理する必要もありません。
4. 2回目のモデル呼出しで、例外の説明を組み立てる
次の合流点で、フローは再びモデルを呼び出します。今回は、構造化されたチェック結果、トリアージ評価、選択したメモの抜粋、インシデントの詳細、ポリシーの証拠を渡します。モデルの役目は、限定された証拠をMayaとElenaが確認できる説明にまとめることです。請求額を再計算したり、何かを承認したりはしません。サマリーは、たとえば次のようになります。
請求額は請求スケジュールと一致しますが、サービスの証拠は、現時点では最終的な発行を裏付けていません。完了メモには暫定措置と再訪問の可能性が記されています。同じ設備に関連するインシデントが存在し、必須の顧客受入れも記録されていません。発行前に請求書をレビューし、サービスが会社の完了ポリシーを満たすか確認してください。
2回のモデル呼出しは目的が異なります。1回目は並列に得た事実を、焦点を絞った調査計画に変え、2回目は集まった証拠を、情報源に根差した明確な例外説明に変えます。
業務上の意味: 説明はモデルの記憶ではなく、保存された情報源に基づきます。
5. Mayaが確認し、Elenaが判断する
エージェントエンジンは、各チェックと結果、トリアージ評価、取得した証拠、最終説明、管理された裏付け記録へのリンク、許可された次のアクションを含む例外サマリーを用意します。
エージェントは、例外の検知、調査、集約、説明を自動化できますが、重大な売上の判断をElenaに代わって下すことはできません。Mayaが請求上の事実を検証し、サマリーが財務レビューに進める状態であることを確認します。その後Elenaが判断し、請求書の発行、追加証拠の要求、再請求や返金の承認、推奨の却下を行えます。
業務上の意味:説明責任は人に残ります。
業務に何が変わるか
Mayaに期待されるメリットは、手作業での照合が減ることです。より少数に絞られた、確認の必要性が明確な請求書が、請求とサービスの証拠を伴って届きます。Elenaにとっては、アクションの前に、見える形のチェック、保存された情報源、追跡可能な説明によって、根拠を示せるレビューを行えることです。
企業に期待されるメリットは、早期の介入です。問題のある請求書を紛争になる前にレビューし、未解決のサービス状態に、顧客関係が損なわれる前に対応できます。
データベース内で実行することが重要な理由
往復通信が減るだけでなく、このフローをOracle AI Database内で実行すると、5つの点が変わります。
ワークフロー状態を保護し、トランザクションで管理します。 エージェントの作業状態、中間結果、レビューキューは、業務データと同じトランザクション保証の下、データベース内に置かれます。各ステップは、コミットするか、しないかのいずれかです。データから認識がずれる可能性のある別のオーケストレーターは存在しません。
すべてのステップをトレースします。 各チェック、取得、モデル呼出し、判断を、入力と情報源とともに記録します。これによりElenaは、実行したチェック、取得した証拠、説明の組立て方を正確に確認でき、レビューの根拠を示せます。
セキュリティとガバナンスのモデルを統一します。 ツールは、権限を定義した、管理されたデータベースプロシージャとして実行されます。
データベース水準のリソース管理。 エージェントのワークフローはデータベースのワークロード管理下で実行されるため、本番ワークロードから分離できます。これは、デモ用データではなくすべての請求書を監視するようになった途端に、現実的な課題になります。
障害時にも安全に継続: モデルやベクトルのステップが一時的に使えなくても、完了した決定論的な結果は保持され、特定された候補は、後で情報を補うか人が確認するため、レビューキューに残ります。推論ステップが利用できないことで、フラグの付いた請求書が消えたり、不十分な証拠が承認に変わったりはしません。
Agent Engineで実行するエージェントの構築
ワークフローは、使い慣れたコンポーネントで実装できます。ツールには、組織がすでに信頼する承認済みデータベース問合せとPL/SQLプロシージャを使います。エージェントフローは宣言的に定義し、スケジュール、再試行、状態、トレースを扱うOracle AI Database Agent Engineが実行します。フロー定義はオープンなAgent Specification標準に従うため、独自形式に固定されず、可搬性と相互運用性を保てます。
管理された自律性
Northstarに必要だったのは、判断を下すエージェントではありませんでした。不一致を特定し、証拠を集め、結果に責任を持つ人に明確に説明するエージェントが必要でした。この違いが要点です。Oracle AI Databaseは、単に他社のエージェントランタイムの背後にあるデータソースではなく、データ中心のエージェントを管理して実行する場所になります。
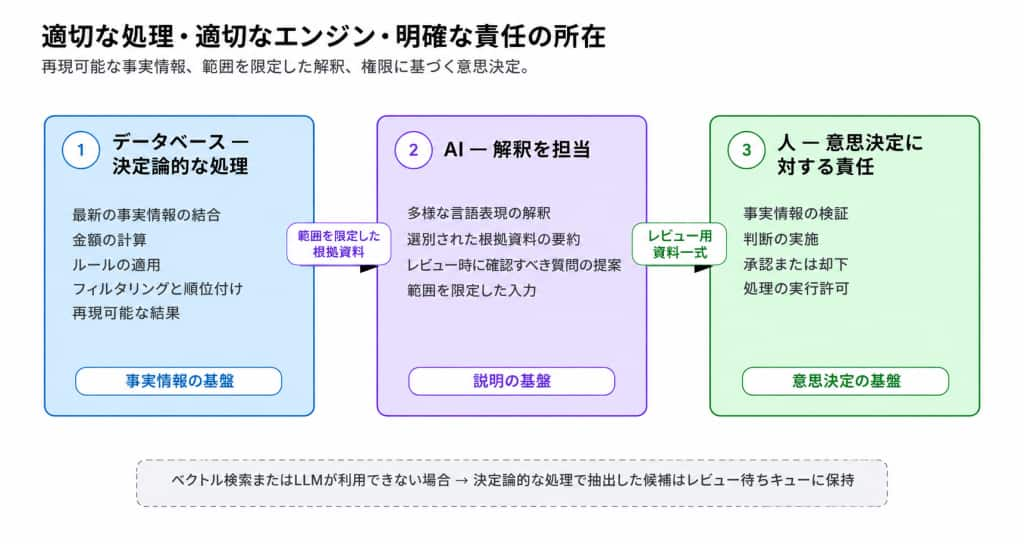
図3:データベースが再現可能な事実を確定し、AIが限定された証拠を説明し、権限を持つ人が重大な判断を下す