※ 本記事は、Adrian Scottによる”Accelerate data pipelines using DAG based scheduling with Autonomous AI Lakehouse“を翻訳したものです。
2026年11月2日
準備が整った工程から実行します。DAG(有向非巡回グラフ)に基づくスケジュールにより、処理間の依存関係の管理、検証、障害からの復旧機能を維持しながら、データパイプライン全体の実行時間を、処理の完了に必要な最短経路(クリティカルパス)まで短縮できます。
並列化で待ち時間をを削減し、処理効率を向上
Autonomous AI Lakehouseに組み込まれているデータパイプライン構築ツール「Oracle Data Transforms」は、100種類以上のアプリケーションやデータベースからデータを取り込むことができます。Data Transformsのワークフローでは、データロード、データフロー、SQLステップ、変数、ネストされたワークフローなど、さまざまな処理を連携させて実行できます。Parallel Workflow Execution(ワークフローの並列実行)を使用すると、各処理ステップは、依存する処理が完了して実行条件が満たされた時点ですぐに開始されます。これにより、互いに依存関係のない処理を決められた順序で実行する必要がなくなり、複数の処理を並列に進めることができます。その結果、不要な待ち時間を削減し、データパイプライン全体の実行時間を短縮できます。
Data Transformsを選ぶ理由
Data TransformsはAutonomous AI Lakehouseに組み込まれているため、追加のインストールは不要です。Data Transformsは、データパイプライン全体を単一のツールでカバーします。具体的には、アプリケーション、データベース、ファイル、オブジェクト・ストレージからのデータのロード、ノーコードのデータフロー・デザイナまたはSQLを使用したデータ変換、ワークフローとしての各処理のオーケストレーションとスケジューリング、さらに単一のコンソールからの各実行状況の監視まで対応します。データ変換処理はLakehouse内部で実行されるため、データを別の処理エンジンに移動してから戻す必要がありません。
また、Data Transformsは、Oracle Fusion、NetSuite、SalesforceなどのSaaSアプリケーションに加え、主要なクラウド・データウェアハウスやレイクハウス、Apache Icebergなどのオープン・フォーマットにも接続できます。これにより、チームは、どの処理が実行されたか、どの処理が失敗したか、そしてその原因は何かを、一元的に把握できます。さらに、Parallel Workflow Execution(ワークフローの並列実行) により、独立したデータロード処理を並列に実行するために、従来は外部スケジューラに任せていたようなオーケストレーションも、Data Transforms自体で対応できるようになります。
並列処理により待ち時間を処理能力に変える
ほとんどのデータパイプラインには、互いに依存関係のない処理ステップが含まれています。しかし、逐次実行型のワークフローでは、これらのステップも決められた順序で実行されるため、実行可能な状態にあるステップであっても、無関係な処理の完了を待たなければなりません。一方、並列実行モードでは、ワークフローのグラフ構造に基づいて、どのステップを開始できるかが決定されます。依存する前提処理がすべて完了したステップは実行可能となり、上流のステップが完了すると、後続の処理が直ちに実行対象となります。
通常、業務データのロードは、決められた時間枠内に完了する必要があります。データ量が増加すると、逐次実行型のパイプラインでは、各ステップが先行する処理の完了を待つため、制限時間内に処理を終えられなくなる可能性があります。Parallel Workflow Executionを使用すると、互いに依存しないステップを同時に実行できるため、パイプライン全体の実行時間は、依存関係にある一連の処理のうち、最も時間のかかる処理経路によって決まります。
- 準備済み分岐を即開始: 前提となる依存条件が満たされると、各ステップは直ちに実行されます。
- 無関係な処理を待たない: 実行時間の短い処理分岐は、依存関係のない実行時間の長い処理分岐の完了を待つ必要がありません。
- 実際の構成に対応: 並列処理と逐次処理が混在する構成や、ネストされたワークフローを含む構成も、単一のオーケストレーション・グラフで管理できます。
- 依存関係を明示的に定義: OK、NOK、OK/NOKの接続(エッジ)によって、それぞれ成功時、失敗時、実行結果にかかわらない処理経路を定義できます。
- 各ステップの独立性を維持: 各ステップは既存のステップ実行方式を使用するため、並列実行されるステップ同士が干渉することなく処理を実行できます。
依存関係を定義するだけで、実行エンジンが並列処理を自動的に最適化
従来、データパイプラインで並列処理を実現するには、手動での設計が必要でした。チームは、どのデータロード処理を同時に実行できるかを判断し、それぞれの実行時間を見積もり、開始時刻をずらしたり、パイプラインを個別にスケジュールされた複数のジョブに分割したりする必要がありました。また、ディメンション・データのロードが完了する前にファクト・データのロードが開始されないよう、余裕時間(バッファ)を設けることもありました。しかし、データソースの規模が拡大したり、特定の処理ステップに時間がかかるようになったりすると、想定していた実行タイミングにずれが生じ、設計を見直す必要がありました。さらに、あらかじめ設定した余裕時間そのものが、パイプラインに組み込まれた待ち時間となっていました。
Parallel Workflow Executionは、このような実行時間に基づく前提条件を、明示的な依存関係に置き換えます。各ステップの実行に必要な依存条件を定義するだけで、実行エンジンが各ステップの完了状況を監視し、実行可能になったステップを最も早いタイミングで開始します。これにより、開始時刻を見積もったり、実行タイミングをずらしたり、データ量の変化に応じてスケジュールを再調整したりする必要がなくなります。たとえば、ディメンション・データのロードが予定より早く完了した場合、それに依存する後続処理も前倒しで開始できます。この仕組みにより、ワークフローは依存関係に基づいて、自動的にクリティカルパスに沿って実行されます。
パイプライン内に独立した処理分岐が多いほど、並列実行によって削減できる待ち時間も大きくなります。特に、データソース、API、オブジェクト・ストレージからの応答やデータ取得を待つ処理分岐において効果的です。各ステップの処理自体は、すでにAutonomous AI Lakehouse内部で並列SQLとして実行されています。ワークフロー・レベルの並列実行は、個々のステップの処理を高速化するだけでなく、各ステップが実行順序を待つ時間を削減することで、パイプライン全体の実行時間を短縮します。
実践的なパターン:ディメンション・テーブルを先に、続いてファクト・テーブルをロード
複数のディメンション・テーブルと1つのファクト・テーブルを含むLakehouseへのデータロードを考えてみましょう。各ディメンション・テーブルのロード処理は互いに依存関係がないため、ワークフローはこれらの処理を同時に開始します。一方、ファクト・テーブルのロード処理は、必要なすべてのディメンション・テーブルのロードが正常に完了するまで待機します。このように、互いに独立した準備処理を並列に実行することで、ファクト・テーブルのロードは、必要なデータがすべて揃い次第、直ちに開始できます。その結果、すべてのディメンション・テーブルを1つずつ順番にロードしてからファクト・テーブルをロードする従来の方式とは異なり、クリティカルパスは、最も実行時間の長いディメンション・テーブルのロード処理と、それに続くファクト・テーブルのロード処理のみで構成されます。これにより、パイプライン全体の実行時間を大幅に短縮できます。
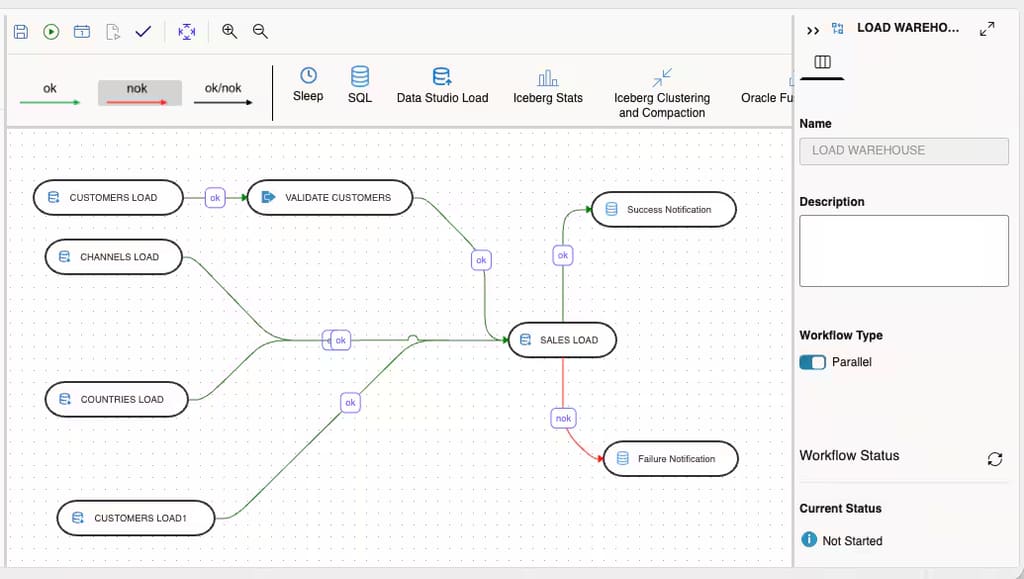
図1:ディメンションを並列ロードしてからファクトを開始します。失敗分岐は通知へ進みます。
OK、NOK、OK/NOKで実行経路を定義する
並列実行によってワークフローの制御が失われるわけではありません。むしろ、ワークフローのグラフ構造によって、処理の制御が明示的に定義されます。各エッジの種類によって、上流の処理結果に応じた下流の処理の実行条件が決まります。
- OK(緑)は成功時の実行経路: 複数のOKエッジが1つの下流ステップに合流する場合、そのステップは、すべての上流ステップが正常に完了するまで待機します。
- NOK(赤)は失敗時の実行経路: 複数のNOKエッジが1つの下流ステップに合流する場合、いずれかの上流ステップが失敗した時点で、下流ステップを開始できます。ただし、ワークフロー全体としては、すべての上流ステップが完了するまで待機します。
- OK/NOK(黒)は無条件の実行経路: 流ステップの成功・失敗にかかわらず、後続の処理を実行します。OKエッジとOK/NOKエッジが混在して1つの下流ステップに接続されている場合、そのステップは、すべての上流ステップが完了するまで待機します。
実行結果の解釈が曖昧にならないように、並列ワークフローでは、閉じたループ、接続されていないノード、OKエッジとNOKエッジが同じステップに合流する構成、およびOK/NOKエッジとNOKエッジが同じステップに合流する構成 は許可されていません。
逐次実行ワークフローと並列実行ワークフローの比較
次の例では、サンプル・スキーマを使用しています。Data Transformsを使用して、業務システムの売上履歴データをAutonomous AI Lakehouseにロードすることで、経営層が製品別、顧客別、その他のディメンション別に売上を分析できるようにします。
逐次実行ワークフローでは、各ディメンション・テーブルを順番にロードした後、売上ファクト・テーブルをロードします。一方、並列実行ワークフローでは、同じ処理ステップを使用しながら、複数のディメンション・テーブルのロードを同時に実行します。このサンプルの実行結果では、並列実行ワークフローは逐次実行ワークフローと比較して、約4倍の速度で処理を完了しました。
逐次ワークフロー:32分4秒
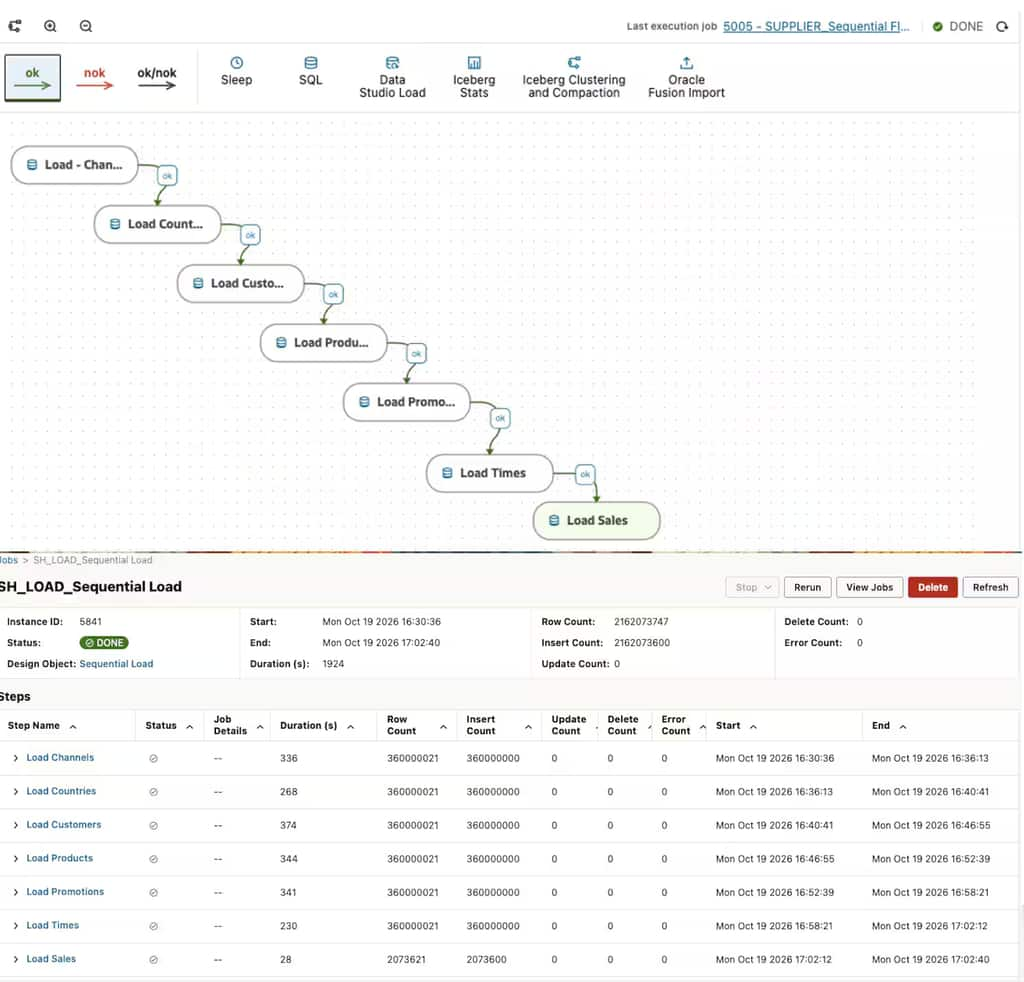
図2:ディメンションを1つずつロードし、続いてSalesファクトをロードします。
並列ワークフロー:8分50秒
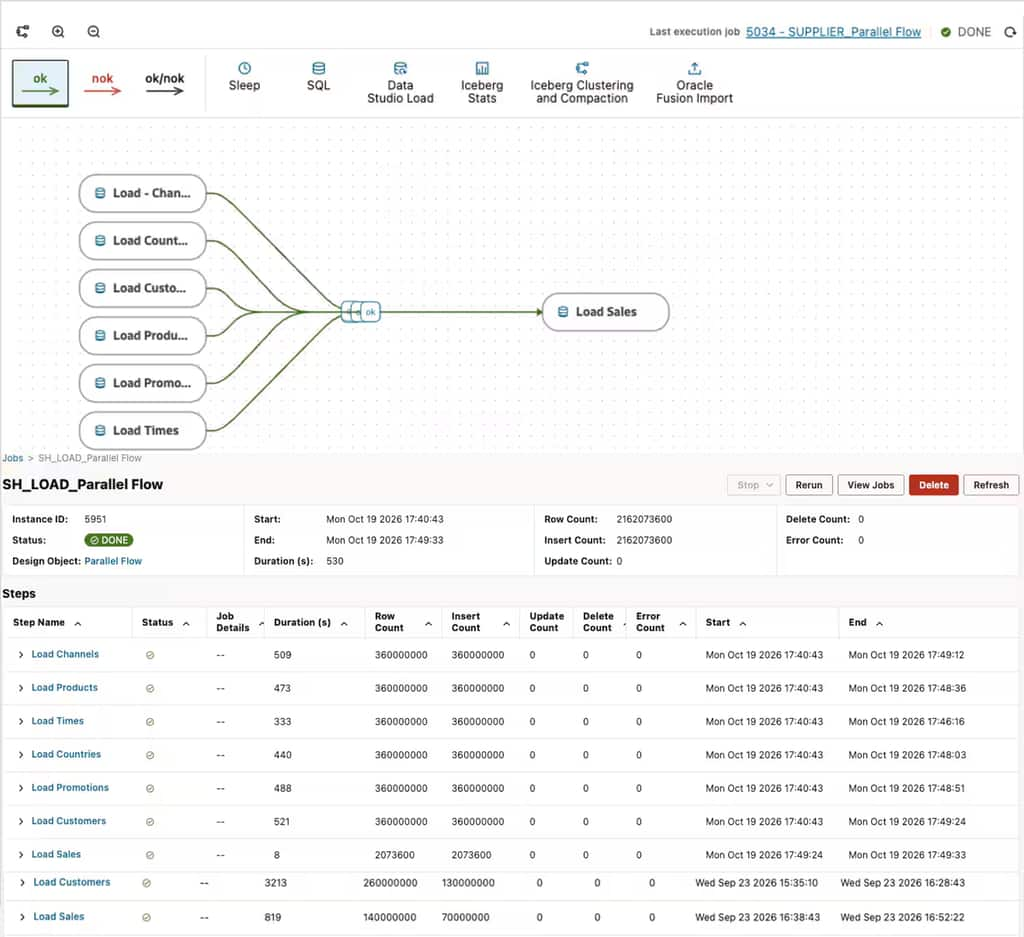
図3:ディメンションを並列ロードし、続いてSalesファクトをロードします。
処理時間の短縮は、複数のディメンション・テーブルのロードを並列に実行し、最後のディメンション・テーブルのロードが完了した時点で、直ちにファクト・テーブルのロードを開始することで実現されます。処理間に不要な待ち時間を設けたり、スケジュールに余裕時間(バッファ)を組み込んだりする必要はありません。また、各ロード処理がいつ完了するかを事前に予測する必要もありません。これらはすべて、ワークフローのグラフ構造に基づいて自動的に制御されます。
障害からのリカバリ機能を維持しながら、設計を拡張
ワークフローでは、並列処理の分岐、逐次実行の処理シーケンス、ネストされたワークフローを組み合わせることができます。子ワークフローを再利用可能なオーケストレーション単位として定義し、親ワークフローのグラフ構造によって、その子ワークフローをいつ実行可能にするかを制御できます。これにより、すべての処理を単一の長い逐次実行フローにまとめることなく、実際の処理間の依存関係を柔軟にモデル化できます。
また、処理ステップが失敗した場合でも、リトライ機能によって、すでに正常に完了した処理結果を維持できます。失敗したステップから処理を再開することで、正常に完了した処理分岐を再実行する必要がなくなり、運用担当者は効率的かつ実用的な方法で障害から復旧できます。
実行制御を維持しながら、パイプラインの処理時間を短縮
Parallel Workflow Executionは、依存条件が満たされた独立した処理ステップを直ちに開始することで、Data Transformsのワークフロー全体の実行時間を短縮します。同時に、グラフ構造の検証、依存関係の制御、OK/NOKによる実行経路の制御、各ステップの独立性、リトライ機能、ワークフロー全体の最終実行ステータスの正確な管理といった機能も維持されます。その結果、処理時間を短縮しながらも、処理の流れを容易に理解でき、運用・管理しやすいデータパイプライン を実現できます。
クリティカルパスの短縮につながる処理には並列実行を適用し、実際に依存関係が存在する処理については逐次実行の順序を維持します。ワークフロー全体を単一のオーケストレーション・キャンバス上で管理しながら、実行エンジンが不要な待ち時間を削減することで、効率的なパイプライン処理を実現します。
Oracle Autonomous AI Lakehouse を使用して、データパイプラインの構築を始めましょう。