※ 本記事は、Adrian Scottによる”Populate and optimize iceberg tables with data pipelines in Autonomous AI Lakehouse“を翻訳したものです。
2026年11月2日
既存のカタログ経由でIcebergへロードし、コンパクション、クラスタリング、メタデータ統計で性能を維持し、ブロンズ、シルバー、ゴールド層を1つのワークフローとして構築します。
Icebergへの書き込みだけなら難しくない
Apache Icebergは、レイクハウスの標準的なオープンテーブル形式になりました。Icebergテーブルに書き込めることは、いまやデータパイプラインツールの基本要件です。それより難しい2つの問題が、Icebergレイクハウスが実際に機能するかを左右します。
1つ目はカタログです。Oracle、Databricks、Snowflakeにはそれぞれのカタログがあり、オープンソースのカタログを運用するチームも多くあります。そのうち1つにしか書けないツールでは、パイプラインを作る前にデータの利用先を決め、利用先が変わると作り直さなければなりません。
2つ目は、Icebergテーブルの効率が低下していくことです。コミットのたびにファイルが増え、小さなファイルが蓄積し、関連する行が複数ファイルへ散らばり、オプティマイザ(*)が頼る統計がロードのたびに古くなります。多くのチームは、通常Sparkを使う別の保守ジョブ群で対応しており、誰かがそれを書き、スケジュールし、監視する必要があります。(*オプティマイザ: 検索実行計画を最適化する機能)
Autonomous AI Lakehouseのパイプライン構築ツールであるOracle Data Transformsでは、データのロードとテーブルの最適化を、同じデータパイプライン内でまとめて実行できます。
- 主要なIcebergカタログに幅広く対応。1つのApache Icebergコネクタを使用して、Oracle AI Data Catalog、Databricks Unity Catalog、Snowflake Open Catalog(Apache Polaris)、およびIceberg REST仕様に準拠したカタログを通じてデータを書き込むことができます。
- コンパクション(小さなデータファイルの統合)とクラスタリング(データの配置最適化)を、データパイプラインの処理ステップとして組み込めます。これにより、データロードと同じスケジュールでテーブルのメンテナンスを実行でき、データの追加に伴って必要になる最適化処理も自動化できます。
- Icebergのメタデータを利用して統計情報を取得することで、大量のデータをスキャンする方法よりも高速に処理できます。また、少量のデータをサンプリングする方法と比べて、より正確な統計情報を取得できます。
記事全体で、小売企業の1つの例を使います。注文管理システムから15分ごとに注文明細をIcebergのORDER_LINESテーブルへロードします。アナリストはAutonomous AI Lakehouseから、データサイエンスチームはDatabricksから、同じテーブルを利用します。
Data Transformsを選ぶ理由
Data TransformsはAutonomous AI Lakehouseに組み込まれており、インストールは不要です。アプリケーション、データベース、ファイル、オブジェクトストレージからのロード、ノーコードの設計画面やSQLによる変換、ワークフローとしての編成、スケジュール、すべての実行の監視まで、1つのツールとコンソールで扱います。変換はLakehouse内で実行し、別エンジンへデータを取り出して戻すことはありません。同じツールに、Oracle Fusion、NetSuite、SalesforceなどのSaaS、主要クラウドのウェアハウスやレイクハウス、Apache Icebergなどの公開形式へのコネクタも用意されています。ツールと受け渡しが減り、何が実行され、何が失敗し、その理由は何かを、一か所で確認できます。
レイクハウスでは、ロード、テーブル保守、統計更新を、1つのワークフローの工程にできます。Data Transformsのジョブ、Sparkのジョブ、データベースのジョブを、3人で同期し続ける必要はありません。
1 ひとつのコネクタであらゆるカタログに対応
サポート対象のカタログ・プロバイダ
Data TransformsでApache Icebergへの接続を作成する際には、接続先となるカタログ・プロバイダーを選択します。現在、以下の4種類のカタログ・プロバイダーに対応しています。
| カタログ | 内容 | ストレージ | 認証 |
|---|---|---|---|
| Oracle AI Data Catalog | ガバナンス付きIceberg名前空間と表を公開する統合カタログ | OCI Object Storage(S3互換) | DBユーザーとパスワード |
| Databricks Unity Catalog | Iceberg REST経由のDatabricksガバナンスカタログ | Azure Data Lake Storage | OAuth(クライアントIDとシークレット) |
| Snowflake Open Catalog | Apache Polarisのマネージドサービス | Amazon S3 | OAuth(クライアントIDとシークレット) |
| 汎用RESTカタログ | Apache GravitinoなどIceberg REST仕様の実装 | OCI Object Storage(S3互換)またはAmazon S3 | なし、ユーザーとパスワード、OAuth |
これら4種類のカタログ・プロバイダーに対応することで、現在Icebergデータが利用されている主要な環境を幅広くカバーできます。具体的には、Oracle独自のカタログ、主要なサードパーティ製レイクハウス・プラットフォーム2社のカタログ、そしてIcebergエコシステム全体で標準化が進んでいるオープンなREST仕様に対応しています。
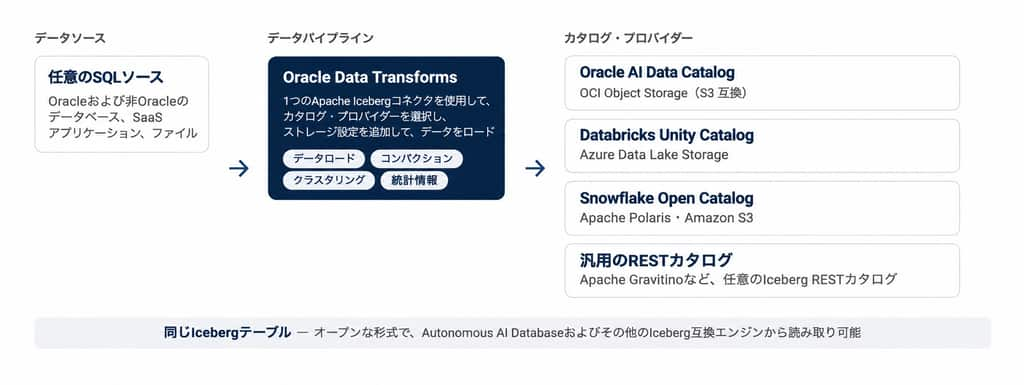
図1:Data Transformsの1つのIcebergコネクタと4つのプロバイダ。
接続の設定
Apache Icebergへの接続は、いくつかの項目を設定するだけで簡単に作成できます。
- プロバイダを選ぶ:接続タイプとして「Apache Iceberg」を選択し、使用するカタログ・プロバイダーを指定します。
- カタログを指定する:カタログ名とREST URL(Oracle AI Data Catalogの場合はサービスURL)を入力し、カタログへの接続に必要な認証情報を設定します。
- ストレージを設定する:Icebergテーブルのデータファイルが保存されているオブジェクト・ストレージについて、リージョンやアクセスに必要なキーを設定します。
- 必要に応じて調整する:「Advanced Options(詳細オプション)」では、「Batch Update Size」を設定できます。この項目では、ターゲットに対して一度に更新するレコード数を指定します。デフォルト値は5,000件です。
作成した接続はData Loadの出力先として使えます。Data Transformsが読み取れるSQLベースのソースなら、そのカタログ内のIcebergテーブルへ出力できます。
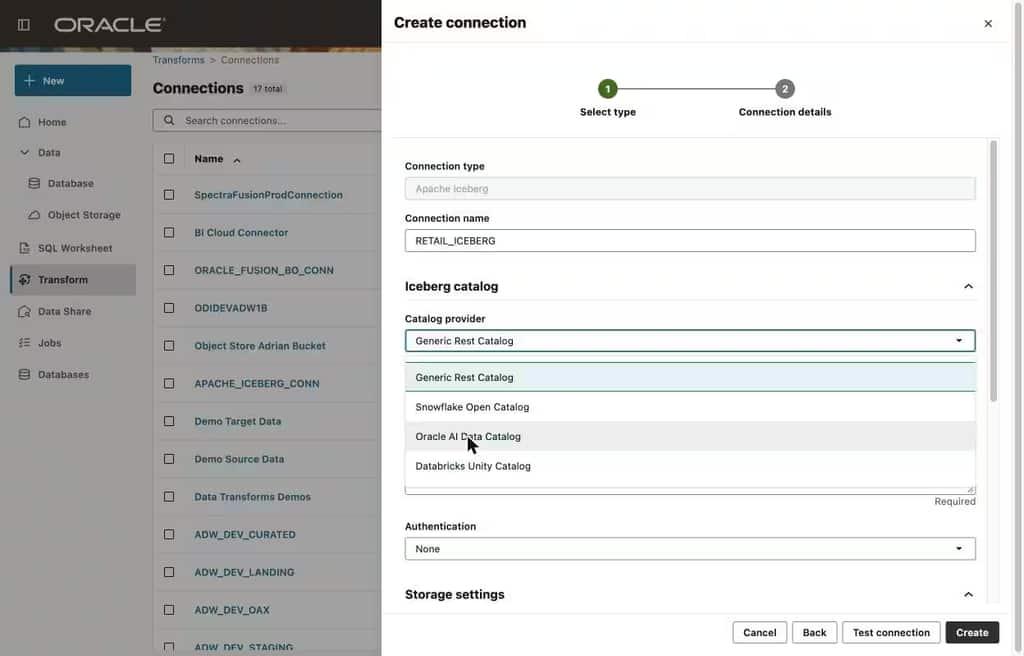
図2:Apache Iceberg接続のプロバイダ選択。
カタログの選択が重要な理由
カタログは、Icebergテーブルの検出、管理、アクセス制御を行うための重要な役割を担っています。データファイルをオブジェクト・ストレージのバケットに直接保存するのではなく、カタログを通じて書き込むことで、テーブルのアクセス権限やデータの来歴(リネージ)などの管理情報も適切に反映されます。これにより、データを利用するユーザーは、必要な管理情報が整った状態でテーブルを参照できます。例えば、前述の小売企業では、注文明細データをORDER_LINESテーブルに一度取り込むだけで、データサイエンス・チームはDatabricks Unity Catalogを通じて、分析担当者はAutonomous AI Lakehouseから、同じIcebergテーブルを利用できます。将来、データの利用先が変更された場合も、データパイプライン全体を作り直す必要はなく、接続設定を変更するだけで対応できます。
2 コンパクションとクラスタリング:Icebergテーブルを最適な状態に維持
Icebergテーブルのパフォーマンスが低下する理由
Icebergでは、既存のデータファイルを直接変更することはありません。データを更新するたびに、新しいParquetファイルが作成され、それらのファイルを参照する新しいスナップショットが生成されます。この仕組みにより、Icebergでは過去のデータを参照するタイムトラベル機能や、複数のエンジンからの安全な同時読み取りが可能になります。しかし、その一方で、パフォーマンス上の課題も生じます。例えば、15分ごとにデータをロードするテーブルでは、1日に約100回のコミットが発生し、そのたびに小さなデータファイルが追加されます。さらに、データの更新や削除によってもファイル数が増加します。その結果、クエリエンジンは大量の小さなファイルを開く必要があり、マニフェスト(データファイルの管理情報)も肥大化していきます。また、各ファイルにさまざまなキー値の範囲のデータが混在するようになると、ファイルごとの最小値・最大値を利用して不要なファイルを読み飛ばす最適化が効果を発揮しにくくなります。
コンパクション
コンパクションは、多数の小さなデータファイルを、より少数の大きなファイルにまとめる処理です。ファイルを再編成した結果は、新しいスナップショットとしてコミットされます。データの内容自体は変わりませんが、ファイル数が減ることで、ファイルのオープン、一覧取得、管理に伴う処理負荷を削減できます。また、マニフェストも小さくなるため、クエリ処理の効率が向上します。
クラスタリング
クラスタリングは、コンパクションからさらに一歩進んだ最適化手法です。指定した列の値が近いデータを同じファイルにまとめるように、データファイルを再編成します。例えば、ORDER_DATE(注文日)やCUSTOMER_ID(顧客ID)をクラスタリング列として指定すると、それぞれのファイルに格納されるデータの値の範囲が狭くなります。これにより、これらの列を条件に指定したクエリでは、ファイルのメタデータに記録された最小値・最大値を利用して、検索条件に一致しないファイルの大部分を読み取り対象から除外できます。その結果、不要なデータの読み取りを減らし、クエリのパフォーマンスを向上させることができます。クラスタリング列には、クエリの検索条件(WHERE句)や結合条件(JOIN句)で頻繁に使用される列を選択することが重要です。
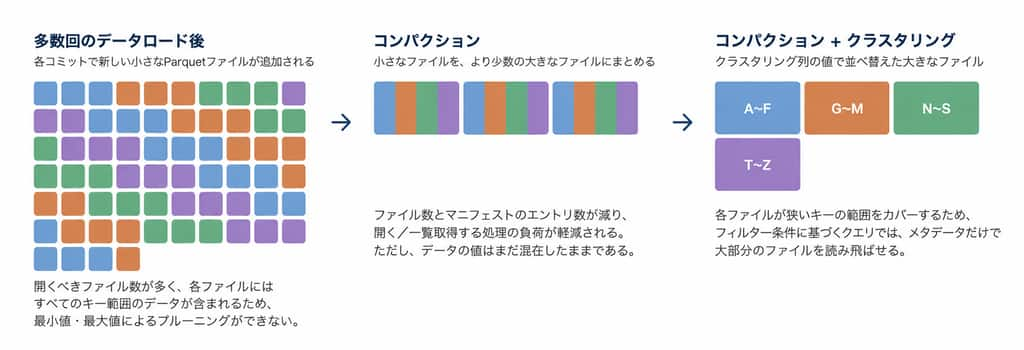
図3:コンパクションはファイル数を減らし、クラスタリングは値の範囲を狭めます。
ワークフローの処理ステップとしてテーブルのメンテナンスを実行
Data Transformsでは、Icebergテーブルのメンテナンスを別のシステムで管理する必要はありません。 データロードと同じワークフローにメンテナンス処理を組み込むことができます。ワークフローには、次の5種類の処理を追加できます。
- Parquetファイルのコンパクション。
- 指定した選択列によるクラスタリング。
- コンパクションとクラスタリングを1回の書き換えで実行。
- 増分コンパクションと増分クラスタリング。テーブル全体を書き換える必要がないため、処理負荷やコストを抑えられます。そのため、頻繁に実行されるデータロードの後にも、効率的にメンテナンスを実施できます。
例えば、前述の小売企業では、15分ごとのデータロード後に増分コンパクションを実行し、週に1回、ORDER_DATE(注文日)を基準としたテーブル全体のコンパクションとクラスタリングを実行する運用が効果的です。これらのメンテナンス処理は、通常のワークフローのステップとして組み込まれるため、ワークフローに設定されたスケジュール管理、実行状況の監視、エラー発生時の処理をそのまま利用できます
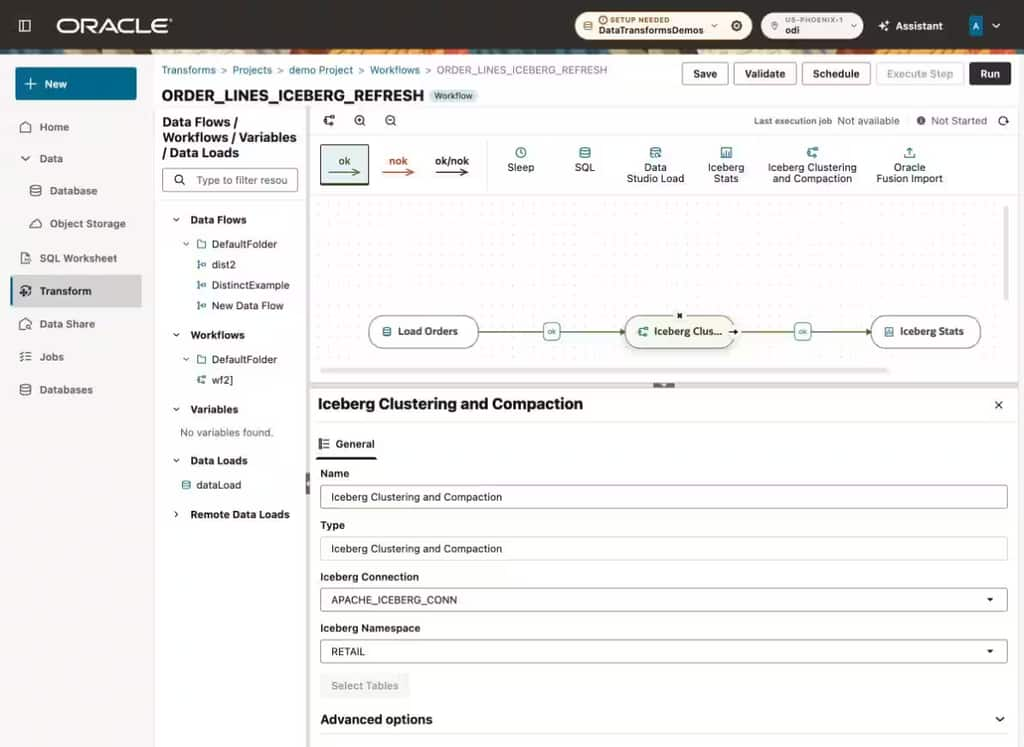
図4:ロード、保守、統計更新を1つのワークフローで実施。
3 スキャンせずメタデータから統計を得る
統計が重要な理由
Autonomous AI LakehouseがIcebergテーブルをクエリするとき、オプティマイザには、総行数、列ごとのNULL数、値の範囲、異なる値の数が必要です。これらの数値が、結合順序、結合方法、並列度、フィルタの選択性を決めます。情報がなければ推測するしかなく、大規模テーブルでは、数秒のクエリが数分になる場合もあります。ORDER_LINESのように15分ごとに変わるテーブルでは、統計もすぐ古くなってしまいます。
従来のトレードオフ
外部テーブルの統計を集める従来の方法は、全データかサンプルを読むことです。そのため、次の選択が必要です。
- 小さなサンプルは速い一方、不正確です。真の最小値、最大値、希少値を逃し、数%の行から推定する異なる値の数も、特に偏りのあるデータでは大きく外れがちです。
- 大きなサンプルや全件スキャンは正確です。しかし高コストです。毎回、オブジェクトストレージの大量のデータを読むことになり、数TBの表では、長い実行時間と計算費用がロードのたびに発生します。
実際には、どちらも選ばず、古い統計のまま運用するチームも多くあります。
Icebergが既に知っている情報
Icebergでは、統計がすでにテーブルのメタデータにあるため、このトレードオフを解消できます。エンジンはファイルを書き込む際、書いた全行から算出したレコード数、列ごとのNULL数、下限値、上限値を、ファイルとともにマニフェストへ記録します。スナップショットの要約には、テーブルの総レコード数があります。簡略化したマニフェスト項目は、次のようになります。
{ "data_file": {

    "file_path": "s3://retail/order_lines/data/00017-4a1c.parquet",

    "record_count": 1843902,

    "null_value_counts": { "order_date": 0, "promo_code": 1210334 },

    "lower_bounds": { "order_date": "2026-10-01", "customer_id": 100045 },

    "upper_bounds": { "order_date": "2026-10-07", "customer_id": 994812 }

} }
Data TransformsのIceberg Stats工程は、このメタデータを集約して、テーブルと列の統計を算出します。続いてデータベースへ公開し、オプティマイザが使えるようにします。データファイル自体は読みません。
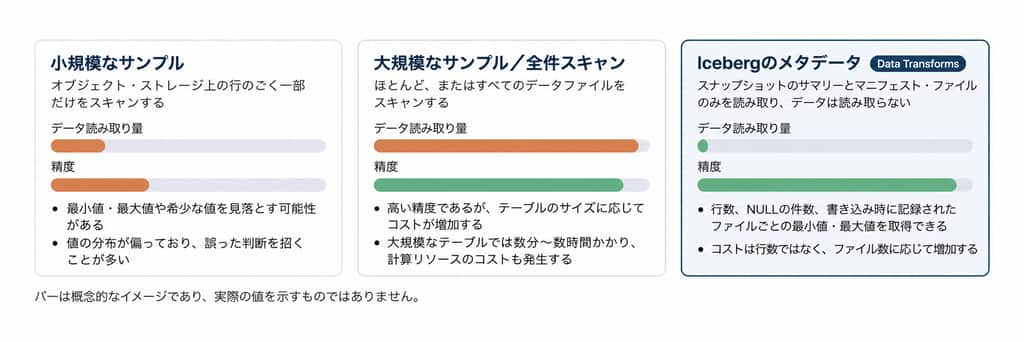
図5:Icebergの統計を得る3つの方法。
より速く、より正確に
メタデータの統計は、両方のサンプリングの欠点を補います。
- 大きなサンプルより高速です。作業量は行数よりもファイル数に比例します。マニフェストは元データのごく一部のサイズなので、数TBの表でも、ストレージ上のParquet全体ではなくメタデータを読むだけで済みます。ロードごとの更新も実用的です。
- 小さなサンプルより正確です。行数、NULL数、最小値、最大値は、ファイル書き込み時に全行から算出されるため、集約は推定でなく正確です。サンプルが見逃す端値や希少値も取り込まれます。
1点、注意があります。Icebergの書き込み側は、マニフェストを小さく保つため、長い文字列列の境界値を切り詰める場合があります。その場合、記録される最小値、最大値は文字列の接頭辞のみとなります。数値、日付、タイムスタンプの境界値は正確です。
Iceberg Statsの使い方
ワークフローへIceberg Stats工程を追加し、Icebergへの接続を選択します。続いてOracleへの接続と、Icebergデータを参照する外部テーブルが格納されているスキーマを指定します。統計情報は、指定したテーブルだけでなく、スキーマ内の対象となるすべての外部テーブルに対してまとめて更新することもできます。Iceberg Stats工程は、データロードやコンパクション、クラスタリングなどのメンテナンス処理の後に配置します。これにより、最新のコミットによって更新されたテーブルの状態が統計情報に反映され、Oracleオプティマイザがその情報を活用して、効率的なクエリ実行計画を選択できるようになります。
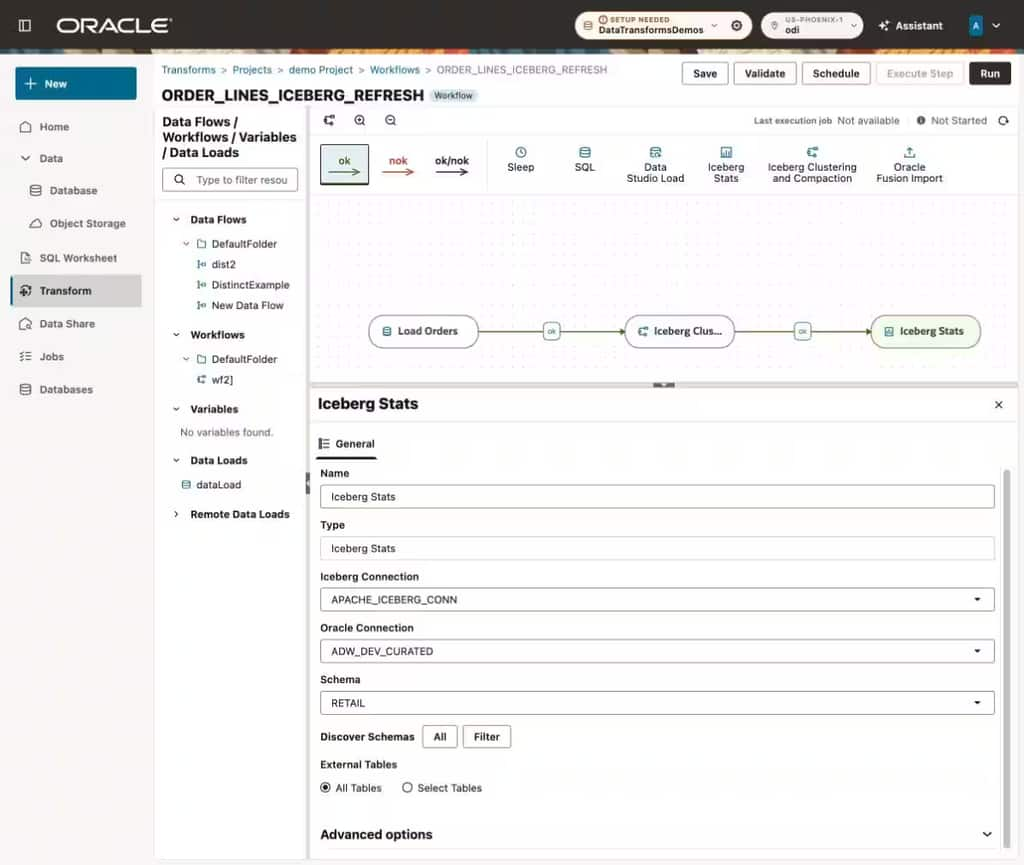
図6:Iceberg Stats工程の設定。
3機能の相互作用
コンパクション、クラスタリング、統計は、単独でも有用ですが、組み合わせると効果が高まります。コンパクションでマニフェスト項目が減るため、統計の算出が軽くなります。クラスタリングで各ファイルの値の範囲が狭まり、境界値が、ファイル除外とオプティマイザの両方に、より有用な情報となります。最新の統計があれば、最適化された配置をオプティマイザが活用できます。3つとも、良好に保たれたIcebergメタデータが処理の多くを担う、という考え方に基づきます。
4 Icebergの層とメダリオン構成
多くのチームは、Icebergテーブルをブロンズ、シルバー、ゴールドと呼ばれる層に整理します。生データをブロンズへ入れ、クレンジングと整合化をシルバーで行い、アナリストやアプリケーション向けにゴールドへ集計します。上述のカタログ、保守、統計は、それぞれの層で異なる意味を持ちます。Data Transformsでは、3層を一連のワークフローとして構築できます。
ブロンズでは、カタログを通じて一度ロードします。Data Loadが、注文管理システムの生の注文明細を、既存カタログ経由でORDER_LINES_RAWというIcebergテーブルへ書きます。書き込みと同時に登録されるので、すぐにガバナンスの対象となり、検出可能になり、すべての下流エンジンが同じコピーを参照します。頻繁な少量追記は小ファイルを生むため、ロードごとの増分コンパクションをこの層で行います。
シルバーでは、クレンジング、整合化、クラスタリングを行います。データフローは、Lakehouseの外部テーブル経由でブロンズを読み、再送レコードの重複除去、コードの標準化、製品と顧客のキー解決、検証に失敗した行の隔離を行います。クレンジング結果をLakehouseに書き、Data LoadがカタログへIcebergのORDER_LINESとして出力します。これが、アナリストとデータサイエンティストの共有テーブルです。現在、Icebergへ書き込むのはData Loadで、データフローはLakehouse内の変換を担当します。シルバーはクラスタリングの効果が特に大きい層です。ORDER_DATEやCUSTOMER_IDなど、フィルタと結合で使う列を選ぶことで、Autonomous AI LakehouseもDatabricksも、通常のクエリで多くのファイルを省けます。
ゴールドでは、利用側向けに集計します。DAILY_SALES_BY_CATEGORYやCUSTOMER_RETURN_RATEなどは、シルバーテーブルを結合し、特定の利用者向けに集計するデータフローで作り、同様にIcebergへ出力します。シルバーより小さく、読み取り頻度が高く、更新予定も予測しやすいため、再構築ごとの完全コンパクションとクラスタリングで小さく保ち、その後のIceberg Statsで統計を正確にします。
層ごとに1つのワークフローでも、3層全体で1つでも構いません。どの層も、ロードまたは変換、保守、統計更新という同じ順序です。並列ワークフローなら、独立したブロンズのロードを同時実行し、必要なブロンズが終わるとすぐシルバーを始め、依存するシルバーがそろってからゴールドを再構築します。別々の3チームがロードツール、Spark保守ジョブ、DB統計ジョブを持つ代わりに、メダリオンの各層を、1つのツール内の依存グラフ、スケジュール、監視画面にできます。
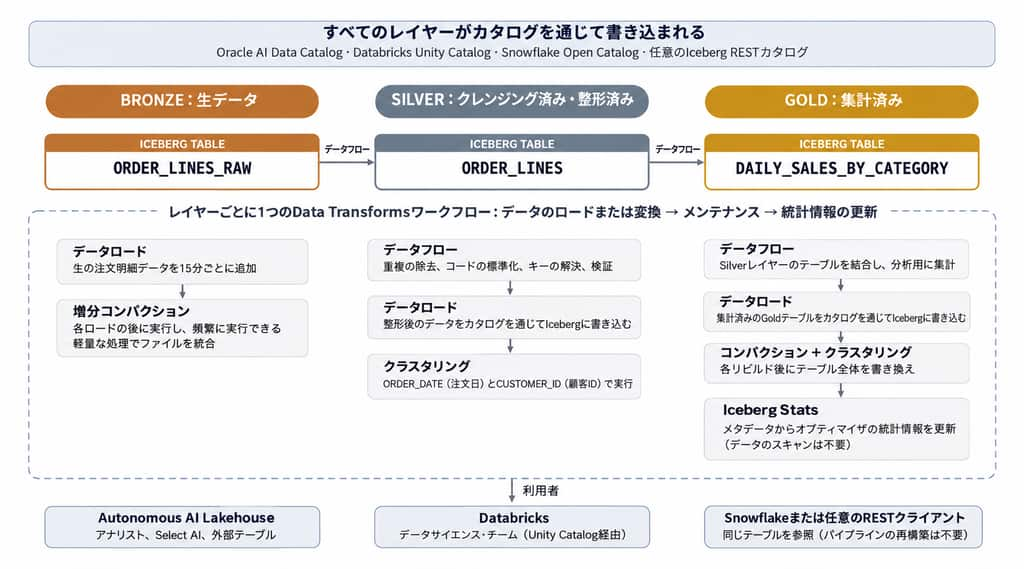
図7:各層のロード、保守、統計工程を1つのData Transformsワークフローに統合。
ここでもカタログの選択が重要です。すべてのレイヤーのデータをカタログを通じて書き込むことで、BronzeレイヤーやSilverレイヤーのテーブルを、当初は想定していなかった別のエンジンからも利用できるようになります。例えば、現在はデータサイエンス・チームがDatabricksからSilverレイヤーのテーブルを参照しているとします。翌年、新しいチームがSnowflakeを導入した場合でも、既存のデータパイプラインを再構築することなく、Snowflake Open Catalogを通じて同じIcebergテーブルにアクセスできます。このように、カタログを活用することで、将来的にデータの利用先や分析エンジンが増えても、既存のデータ資産を柔軟に共有・活用できます。
全体を組み合わせる
Data Transformsは、Icebergを単なる追加のファイル形式ではなく、正式なレイクハウスの出力先として扱います。1つのコネクタで、Oracle AI Data Catalog、Databricks Unity Catalog、Snowflake Open Catalog、任意のIceberg RESTカタログを通じて書き込み、ガバナンスと利用が行われる場所へ届けます。ロードが増えても、コンパクションとクラスタリングで効率を保ち、データをスキャンせずに算出する統計で、オプティマイザへ情報を提供します。
実際の運用で重要なのは、シンプルな仕組みを構築することです。Icebergのデータパイプラインでは、データのロード、コンパクションやクラスタリングによる最適化、統計情報の更新までを、1つのワークフローにまとめることをおすすめします。これにより、データの取り込みと同じスケジュールでメンテナンスや統計情報の更新を実行でき、常に最新のデータの状態に合わせた最適化が可能になります。また、これらの処理を別途実行・管理する必要もありません。
Oracle Data Transformsを使用して、データパイプラインの構築を始めましょう。datastudio.oracle.comからご利用いただけます。