※ 本記事は、Onur Kocberberによる”Reduce token usage by over 10x with Oracle Autonomous AI Lakehouse“を翻訳したものです。
2026年11月1日
Oracle AI Lakehouseは、データを移動せずに、Oracle製品やそれ以外のデータベース、カタログの最新データへアクセスできます。既存のデータ資産全体で、データアクセス、ガバナンス、分析、AIを統合します。
AI Data Catalog(AI-Cat)を通じて、Oracleとそれ以外のソースに共通の意味情報の層を提供します。Oracle Databaseの注釈、分析ビュー、関係性に定義された業務上の意味を再利用し、データ移動やアプリケーションごとの再定義なしに、既存の知的資産を生かします。カタログの注釈と情報拡充によって、この文脈をより広いデータ資産へ拡張します。
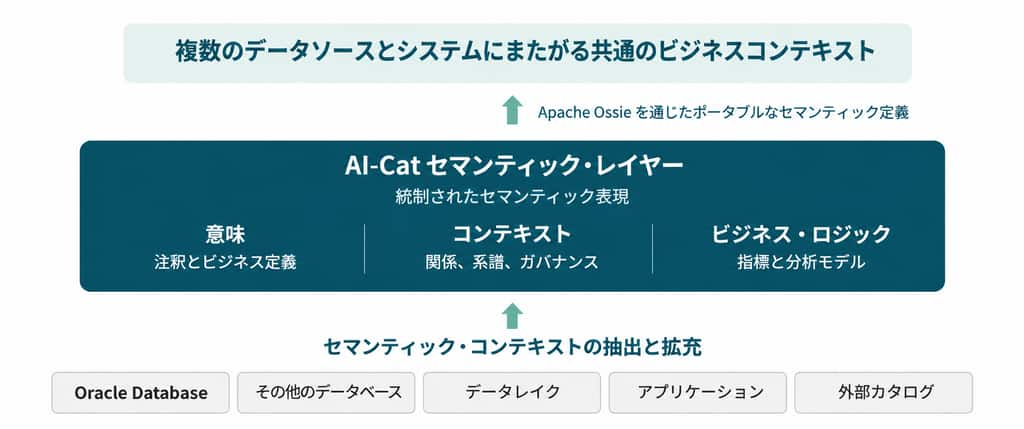
図1:複数ソースの意味情報が、データ資産全体で共通の業務の文脈を形成します。
データに意味付けが必要な理由
AIエージェントは、企業データの探索、SQL生成、業務上の質問への回答に利用され始めています。その前提として、関連するデータを見つけ、その意味を理解する必要があります。
データとメタデータが増えると、業務上の意味が技術的な名前からは分からないカタログ、スキーマ、テーブル、列を調べる必要があります。広範な取得はコンテキストと処理時間を消費し、探索時にもユーザー権限を守る必要があります。
図2は「2027会計年度の第2四半期の各月について、地域別の年度累計売上は?」への回答を比較します。暦年の第2四半期と解釈したり、年度累計(YTD)の計算前に第2四半期へ絞ったりすると、誤解を招く結果になります。分析ビューは会計カレンダーを定義し、年度初めから売上を累計してから第2四半期を選択します。
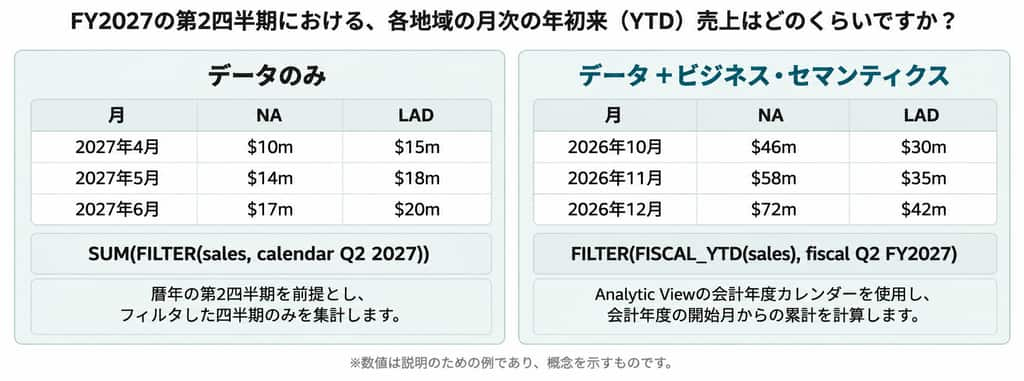
図2:会計年度の定義がないと、もっともらしい年度累計の回答でも、対象月と合計を誤ることがあります。
1 レイクハウス規模のエージェント型AI
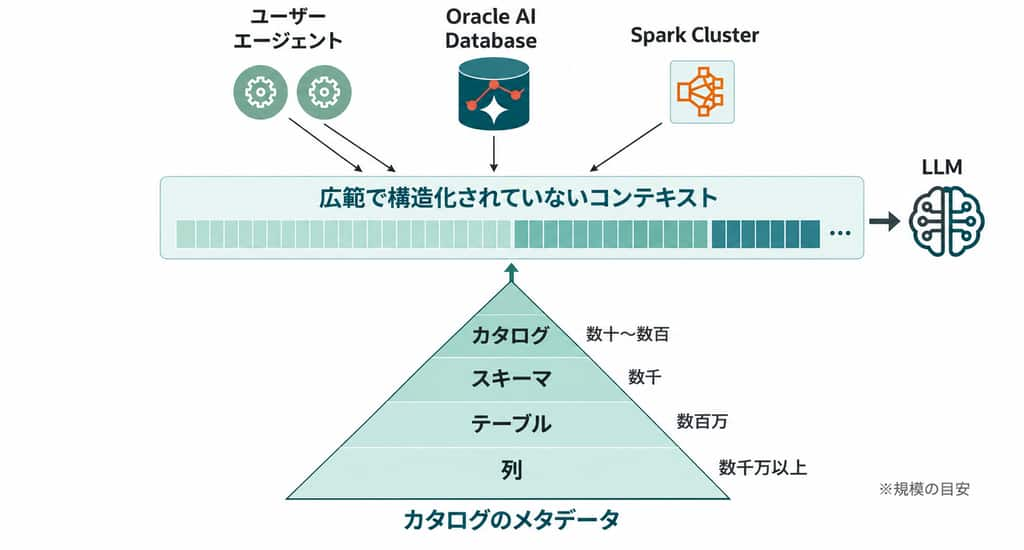
図3:カタログ階層の拡大に伴い、エージェントが調べる文脈も増えます。
レイクハウス規模の自然言語分析では、企業の複数ソースにまたがる業務上の意味を解釈し、必要な文脈を選ぶ必要があります。図3の階層拡大は、3つの課題の1つです。
- 規模の拡大に伴い、カタログ、スキーマ、テーブル、列の検索範囲が広がります。
- データの形態が異なれば、解釈すべきデータとメタデータの種類も変わります。
- ソースごとにガバナンスとアクセスルールが異なり、エージェントが利用できるものを決めます。
ユーザーの質問に結び付けずに大量のメタデータをLLMへ渡すと、遅延と誤った回答のリスクが増す可能性があります。無関係なメタデータはトークンも浪費します。
意味情報とカタログエージェント
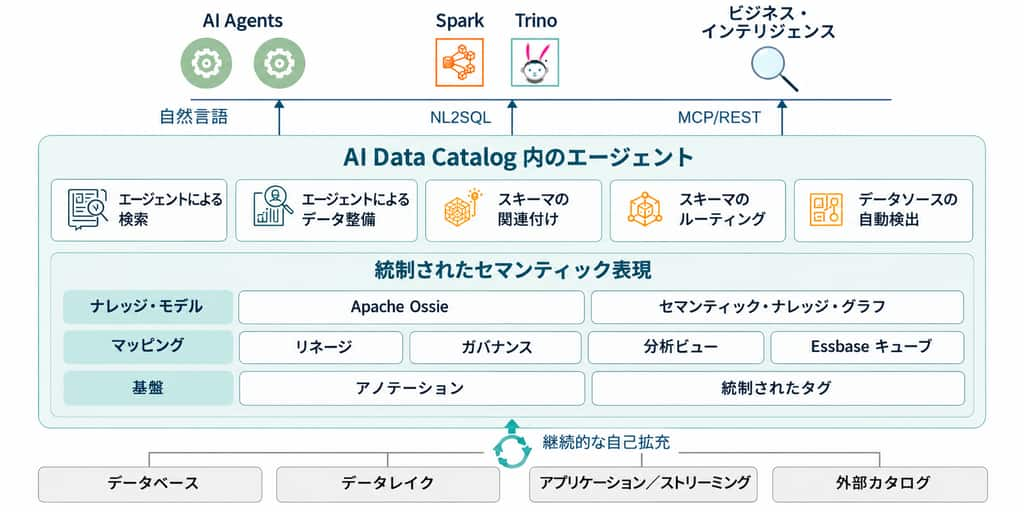
図4:意味情報の層が、カタログエージェントと、ガバナンスの下で管理される表現を結び付けます。
図4は、AI-Catの意味情報の層の構成です。以下の例はAgentic Searchと意味情報の拡充を示します。追加のエージェント種別や、さらに豊かな表現は今後の計画に含まれています。
カタログエージェントは、注釈、関係性、共通定義を使い、関連性があり、利用を許可された資産をAI-Cat APIで返します。利用側のエージェントは、その文脈を使ってSQL生成などを行います。
Agentic Searchによる絞り込み
Agentic Searchは、AI-Cat内部で動くエージェントを使います。質問に基づいてカタログとスキーマを絞り、表や列のメタデータを調べます。名前だけでは分からなくても、注釈から関連する表を特定できます。カタログツールは全工程でユーザー権限を適用し、絞った候補を下流へ返します。
ロールベースのアクセス制御(RBAC)により、メタデータの権限が異なるユーザーには、同じ質問でも異なる結果が返る場合があります。アプリケーションは、エージェントごとに別のメタデータアクセス方針を実装せず、取得時にAI-Catの認可を再利用します。
この探索をカタログ内部で行う理由
標準のカタログAPIも権限を適用しますが、広範な取得を繰り返すと、クライアント処理とコンテキストの負荷が増します。AI-Cat外にメタデータを保持するアプリケーションは、コピーを同期してアクセス制御を維持する必要があります。Search APIは内部で探索し、絞った候補を返します。
エージェントによる絞り込みの仕組み
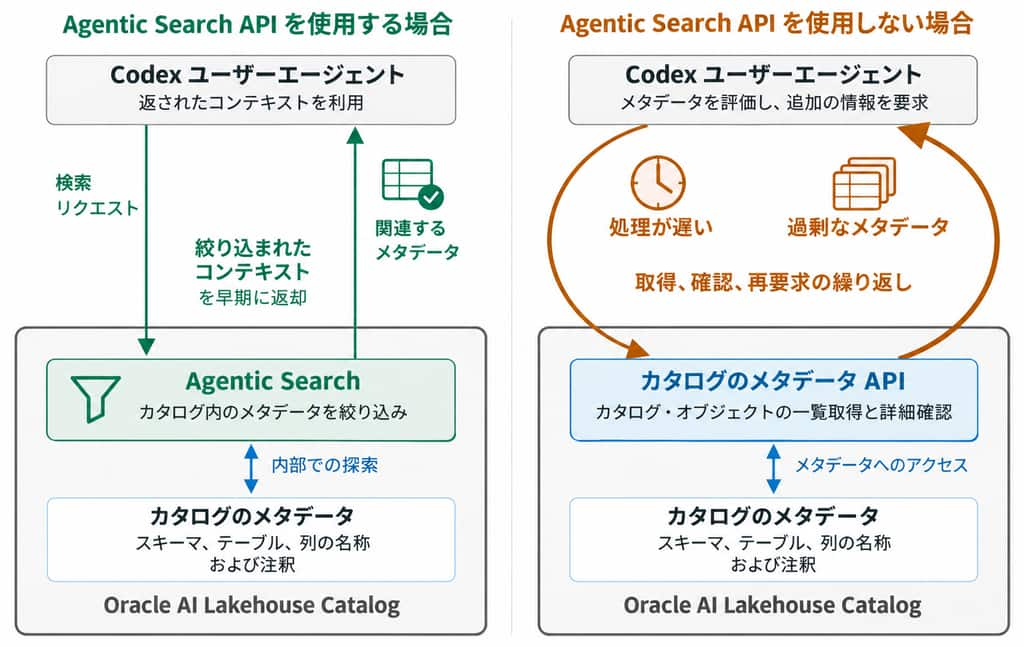
図5:Agentic Searchはカタログ内部でメタデータを絞ります。標準APIでは、ユーザー側エージェントが探索を繰り返します。
図5では、権限のあるスキーマを候補にし、どのスキーマとテーブルを調べるか計画します。メタデータツールは選択した説明やプロパティを並列バッチで取得し、カタログ全体を渡さずに、LLMが関連情報を評価できるようにします。
Agentic Searchの実行例
「最も費用の高い病院の処置は何で、どの医師が関係しているか?」に答えるには、下流のエージェントは、SQLを組む前に処置費用、実施された処置、医師情報を特定する必要があります。
AI-Catは、OracleとIcebergのカタログにある83スキーマを2つへ、736の表を4候補へ絞ります。17の列を調べた結果、Procedure(手術)、Undergoes(処置)、Physician(医師)という3つのIcebergテーブルに到達します。
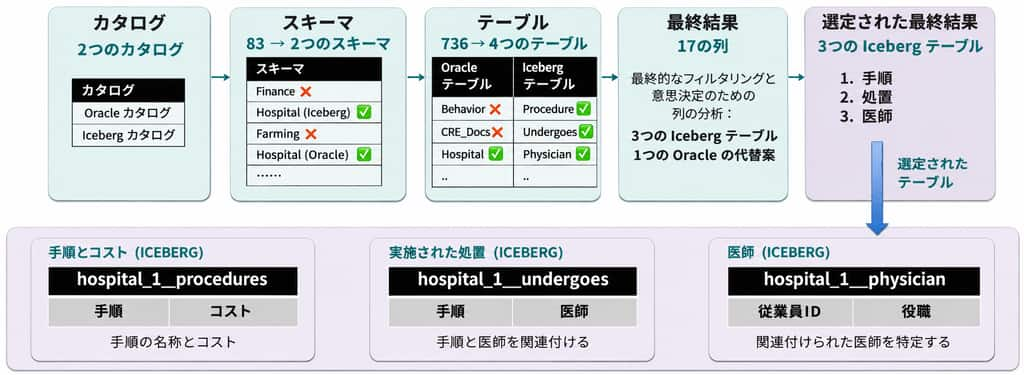
図6:OracleとIcebergのカタログを階層的に探索し、3つのIcebergテーブルを選択します。
クライアントのメタデータトークン数と遅延を削減する
図3は企業規模のカタログの複雑さを示しています。別の実験では、5,000の表と約50,000件の注釈を使用しました。実験時点の最新OpenAIモデルを使うCodexで、一覧取得APIのみの場合と、それにAgentic Searchを加えた場合を比較しました。
表1:カタログ側のAgentic Searchの有無による結果
| 指標 | 一覧取得APIのみ | 一覧取得APIとAgentic Search | 削減率 |
|---|---|---|---|
| カタログの応答サイズ | 602 KB | 0.768 KB | 99.9% |
| 総トークン数(CodexとAI-Catの合計) | 114万 | 329,000 | 71% |
| Codexのトークン数 | 114万 | 60,000 | 94.7% |
| 正規化したクライアント遅延 | 1倍 | 0.22倍 | 78% |
要点: テストした構成では、Agentic Searchは、メタデータ量と総トークン数を減らすとともに、Codexのクライアント遅延を78%削減しました。
2 複数ソースの意味情報をまとめる
Oracle Databaseは、注釈、業務定義、ワークロード情報、分析ビューなど、基幹業務の豊富な意味情報を持っています。
AI-Catは、ソースで管理される定義とカタログの注釈、情報拡充を組み合わせます。データをOracleの外へ移さず、その知的資産をOracleとそれ以外のデータで再利用できます。
Oracleと他のソースの注釈を再利用する
AI-Catは、サポート対象のOracle Databaseの既存注釈をカタログへ読み込みます。データベースオブジェクトとともに定義された意味を保持し、複数のアプリケーションで再利用できます。
たとえば、注釈はCUSTOMER_EXT.PNが米国の電話番号であることを示します。CUSTOMER_EXTはオブジェクトストレージ上のデータを参照するOracle外部テーブルで、注釈はそのアクセスに使うOracle側の列に定義されています。
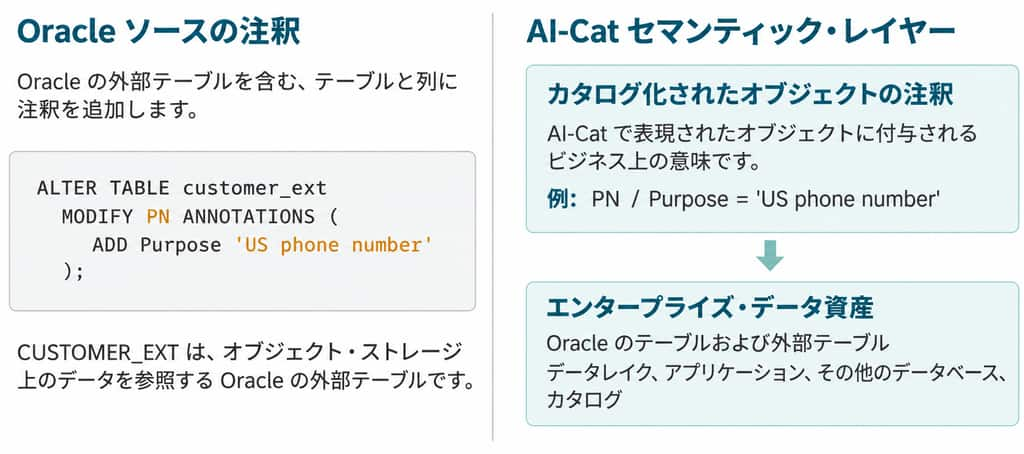
図7:ソースとカタログの注釈が、業務上の意味をデータ資産全体に広げます。
他の登録資産には、ソース自体に注釈機能がない場合も含め、AI-Catで直接注釈を追加できます。
注釈以外のOracle Databaseの豊富な意味情報を活用する
クエリ履歴は、スキーマに宣言されていない関係も含む実行済みの結合に加え、繰り返し使われるフィルタ、別名、式を記録します。Oracle Databaseにはこの情報がありますが、スキーマだけのアクセスではエージェントに伝わりません。実際のデータ値も、業務概念の表現を明確にします。
図8では、スキーマだけを使うと、2007年公開の否定的レビューを選ぶ年フィルタは無効です。データの文脈より”NEGATIVE”を、クエリ履歴より”SUBSTR(creationDate, 1, 4)”の指定を手助けします。実行時にこれを取得すると、実際の値と実績のある式に基づいてフィルタを選べます。
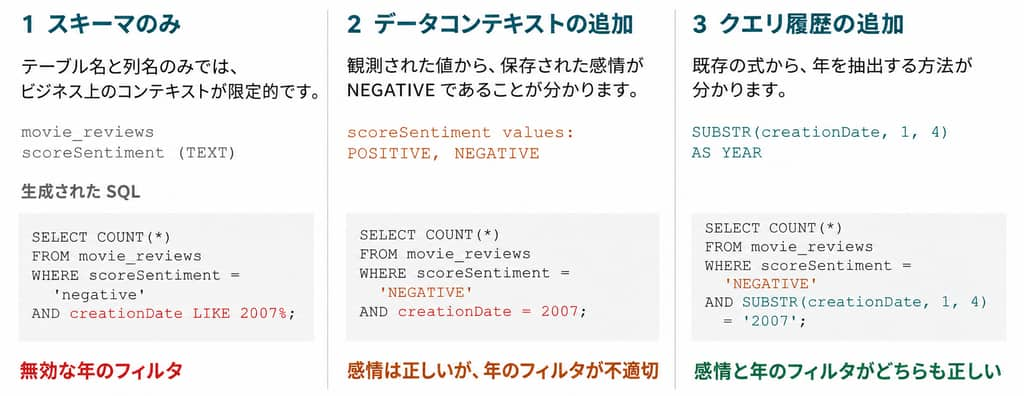
図8:データ値とクエリ履歴が、生成SQLに相互補完的な文脈を提供します。
分析ビューは、整備された指標、計算、集計規則、ディメンション、階層を追加します。監査情報はデータの使用を記録し、セキュリティポリシーはアクセス制約を定めます。AI-Catでこの情報を公開すれば、エージェントによる一貫した資産選択と業務指標の解釈を支援できます。
3 AIによる意味定義の支援と、データ資産全体での移植性
基盤データをカタログへコピーせず、データの変化に伴ってクエリ、変換、データモデルから意味を取り込み、意味情報の層が自ら充実していくようにしています。Data StudioとData TransformsのAI Enrichmentがその例です。
Data StudioのAI Enrichment
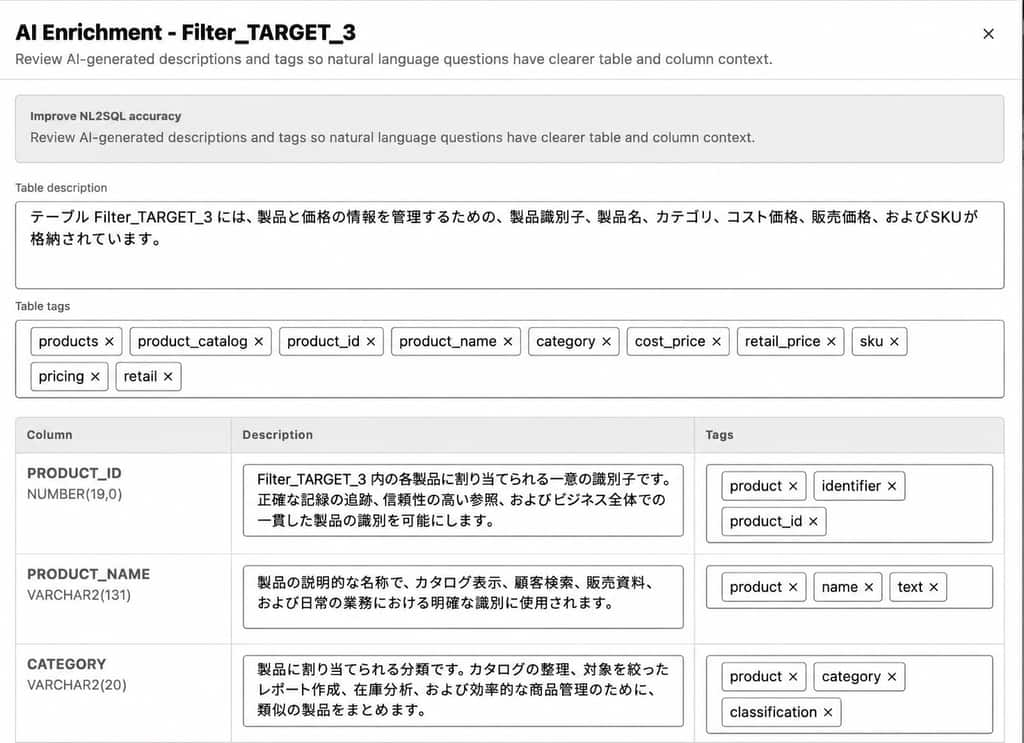
図9:AI Enrichmentは、ユーザーが確認するためのテーブルと列の説明、ラベルを提案します。
Data StudioのAI Enrichmentは、テーブルと列の説明を生成し、ラベルを提案して手作業を減らします。Oracleに接続した製品データの例では、識別子、カテゴリ、原価、価格を扱います。保存前にユーザーが確認し、修正できます。
Data Transformsのパイプラインによる情報拡充
Data Transformsのパイプラインでは、対象範囲を示すフィルタ、関係を示す結合、列の出所を示す変換が意味情報を提供します。生成された注釈は、出力の作成方法を説明します。
図10のパイプラインは、PRODUCTSをCATEGORY = ‘SOCCER’で絞り、SOCCER_PRODUCTSを作成します。図11の注釈は、この条件と列が変更なしで引き継がれたことを記録し、部分集合と製品カタログ全体を区別する助けになります。
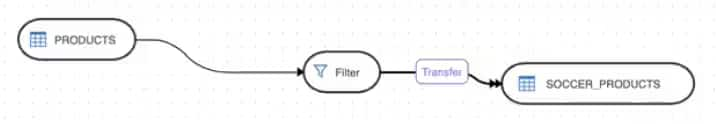
図10:Data TransformsがPRODUCTSを絞ってSOCCER_PRODUCTSを作成します。
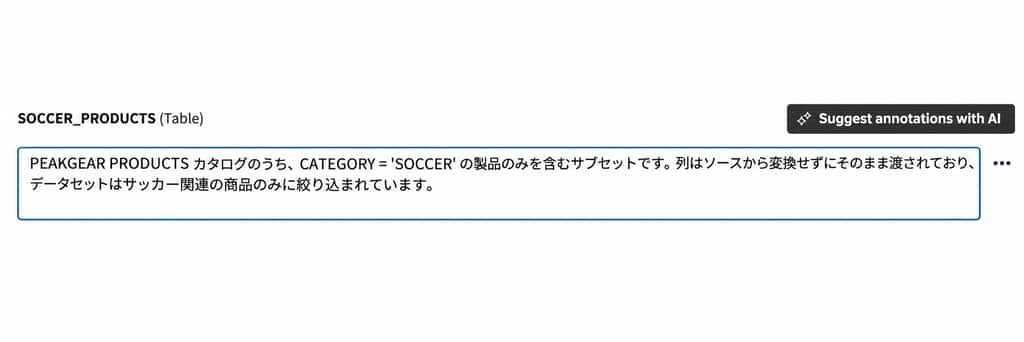
図11:AI支援の注釈が、部分集合の条件と列の来歴を記録します。
これらのAI生成注釈は、意味情報として再利用する前に、Data Transformsでユーザーが確認、修正できます。
要点: Oracleの既存の文脈とAIによる情報拡充が、Oracleとそれ以外の資産を横断する再利用可能な業務上の意味を提供し、探索とクエリ生成を支援します。
データ資産全体で意味定義を再利用する
ユーザー自身の意味定義やモデルを持ち込めるようにしながら、この豊富な意味情報を他のソースへ広げるには、どうすればよいでしょうか。
Oracle AI Lakehouseは、テーブルデータにApache Iceberg、来歴にOpenLineageなどのオープン標準を使います。意味情報の相互運用性でも同じ方針を採ります。
従来Open Semantic Interchange(OSI)と呼ばれていたApache Ossie(インキュベート中)をサポートします。これは、分析、AI、BIの各プラットフォーム間で意味メタデータを交換するための公開仕様です。共通表現には、データセット、列、指標、関係性が含まれます(ossie.apache.org)。
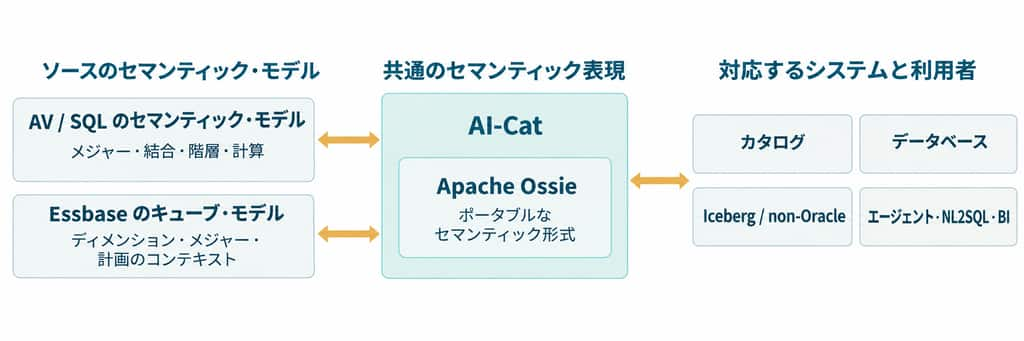
図12:分析ビューとEssbaseの意味定義を、互換システム向けの共通形式で表現できます。
たとえば、互換ツールやエージェントは、確立済みの収益定義をIcebergテーブルの対応する売上データへ関連付け、クエリ作成に利用できます。これにより、モデルを何度も作り直さずにOracleの意味モデルを他のデータへ拡張できます。
OracleはApache Ossieに貢献し、サポート対象のOracleの意味定義を、他のソースの列や関係へ対応付けられる共通形式で表現できるようにしています。ユーザー自身のデータセット、指標、関係性も同じ表現で記述し、互換性のある利用側で再利用できます。
結論
AI-CatはOracleの豊富な意味情報を再利用し、自己拡充によって広げ、レイクハウス全体の共通の業務文脈をエージェントに提供します。エージェントによる絞り込みは、その文脈で、関連性があり権限のある資産に検索対象を限定します。利用側のエージェントは、少ないメタデータとトークンで、より速く効率的に動けます。
プラットフォーム全体の情報は、Oracle Autonomous AI Lakehouseのイノベーションにより、企業全体のデータ資産でAIエージェントを活用をご覧ください。