Acompaña a Lucía, arquitecta de datos en Bogotá, mientras conecta fuentes de datos del lakehouse y usa un asistente para descubrir datos en Oracle AI Data Catalog.
Lucía está a cargo de las operaciones de un minorista de artículos deportivos en toda América Latina. Su próximo análisis requiere ventas en tiendas, actividad de carritos de compra en línea e inventario almacenado en distintos entornos de datos.
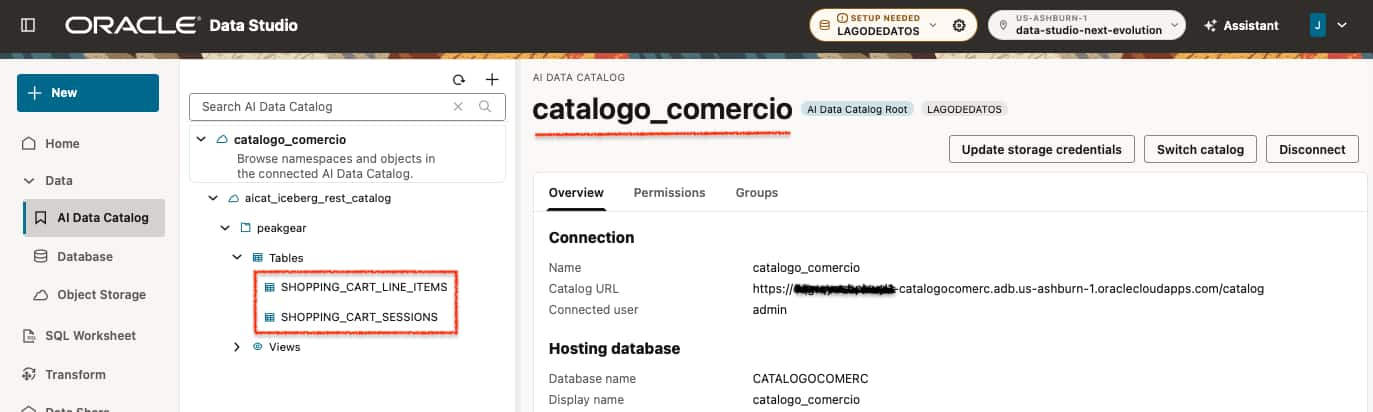
Oracle Data Studio le ofrece a Lucía una interfaz unificada para trabajar con distintas instancias de bases de datos y catálogos conectados. Puede ampliar y administrar estos recursos desde la interfaz de usuario o mediante el Asistente IA, lo que le permite centralizar la exploración de datos, el desarrollo de consultas SQL y el análisis en un solo espacio de trabajo. Lucía comienza explorando las tablas de carritos de compra en Oracle AI Data Catalog, catalogo_comercio.
Reunir las fuentes de datos
El espacio de trabajo admite conexiones a Databricks Unity Catalog, Oracle AI Data Catalog, AWS Glue y OCI Object Storage. El ejemplo de Lucía utiliza la siguiente estructura de tablas:
| Fuente o ruta de acceso | Tablas de ejemplo | Aporte |
|---|---|---|
| Databricks Unity Catalog | STORE_SALES_TRANSACTIONS, PRODUCTS | Ventas de tiendas y datos de referencia de productos. |
Oracle AI Data Catalog: catalogo_comercio | SHOPPING_CART_SESSIONS, SHOPPING_CART_LINE_ITEMS | Tablas Iceberg para la actividad del carrito y la tienda seleccionada en cada sesión. |
Bucket de OCI Object Storage: lagodedatos-fuentes | STORE_INVENTORY | Existencias en tienda y cantidades disponibles para prometer. |
| AWS Glue Data Catalog | SUPPLIER_STOCK | Datos registrados de existencias de proveedores para conocer la disponibilidad por producto. |
| Base de datos local | STORE_LOCATIONS | Datos de referencia de las tiendas. |
Cada conexión da al equipo acceso a una parte distinta del análisis. Las conexiones a catálogos identifican las tablas registradas; también se necesita acceso al almacenamiento subyacente.
Oracle documenta el acceso a catálogos externos, el montaje de AWS Glue y Oracle AI Data Catalog y un ejemplo de Unity Catalog para tablas de Databricks que cumplen los requisitos. Oracle AI Data Catalog proporciona metadatos de Iceberg; los archivos de datos de sus tablas registradas permanecen en el almacenamiento configurado.
Crear tu Autonomous AI Lakehouse Database
Lucía necesita relacionar el interés de los clientes con la disponibilidad de existencias en las plataformas de datos de su minorista. Autonomous AI Lakehouse le ofrece a su equipo un entorno SQL para analizar datos lakehouse compatibles junto con datos empresariales locales, usando los catálogos existentes y tablas Iceberg aptas. Provisiona LAGODEDATOS para desarrollar y ejecutar ese análisis, con ayuda de IA para generar SQL que su equipo pueda revisar y reutilizar.
Lucía abre el espacio de trabajo e inicia sesión.
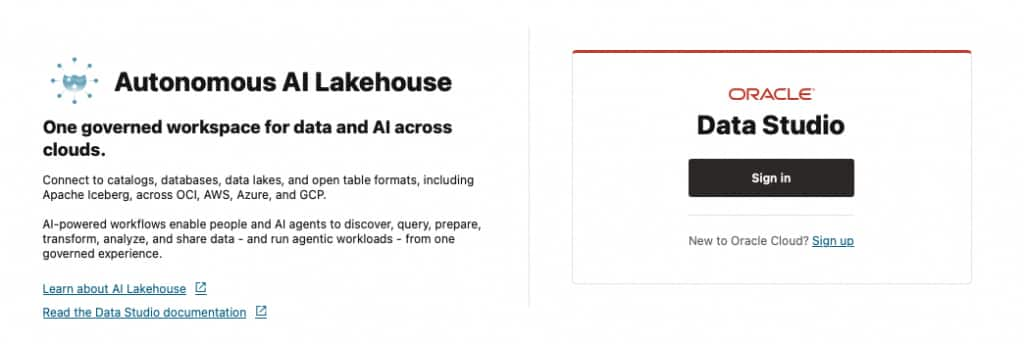
Empieza una solicitud de provisionamiento para una Autonomous AI Lakehouse Database:
Ayúdame a crear una base de datos Autonomous AI Lakehouse llamada LAGODEDATOS con 2 ECPU y 1 TB de almacenamiento para analizar datos de Databricks, tablas registradas en AI Data Catalog y AWS Glue, y archivos de OCI Object Storage.
Sigue el procedimiento de provisionamiento documentado para el asistente: revisa el formulario de creación generado, ingresa la contraseña del administrador, comprueba la configuración y confirma la creación. Verifica que la carga de trabajo sea Lakehouse y que la asignación de cómputo y almacenamiento corresponda a lo solicitado. Las 2 ECPU y el 1 TB utilizados aquí son valores de ejemplo admitidos por el modelo de cómputo, no una evaluación del tamaño que necesita la carga de trabajo del minorista.
Cuando el entorno esté disponible, conecta catalogo_comercio y el bucket lagodedatos-fuentes, junto con las fuentes de datos del Databricks y AWS Glue, y luego inspecciona las tablas en la interfaz del catálogo. Los nombres de las fuentes de datos permanecen visibles para que el equipo pueda identificar el origen de cada conjunto de datos.
Conectarse a AI Data Catalog
Conecta Data Studio al AI Data Catalog existente llamado catalogo_comercio, siguiendo las instrucciones para crear y conectarse a AI Data Catalog. Proporciona las credenciales del catálogo cuando se soliciten y comprueba que la base de datos conectada esté configurada para usar ese catálogo. Dentro del catálogo, los usuarios pueden recorrer los espacios de nombres disponibles y explorar los objetos de datos registrados.
Usar el asistente para buscar datos en AI Data Catalog
El asistente puede buscar entidades en Oracle AI Data Catalog. Lucía empieza con los datos del carrito en catalogo_comercio:
Busca las entidades SHOPPING_CART_SESSIONS y SHOPPING_CART_LINE_ITEMS en el AI Data Catalog. Muestra las coincidencias encontradas y sus referencias en el catálogo.
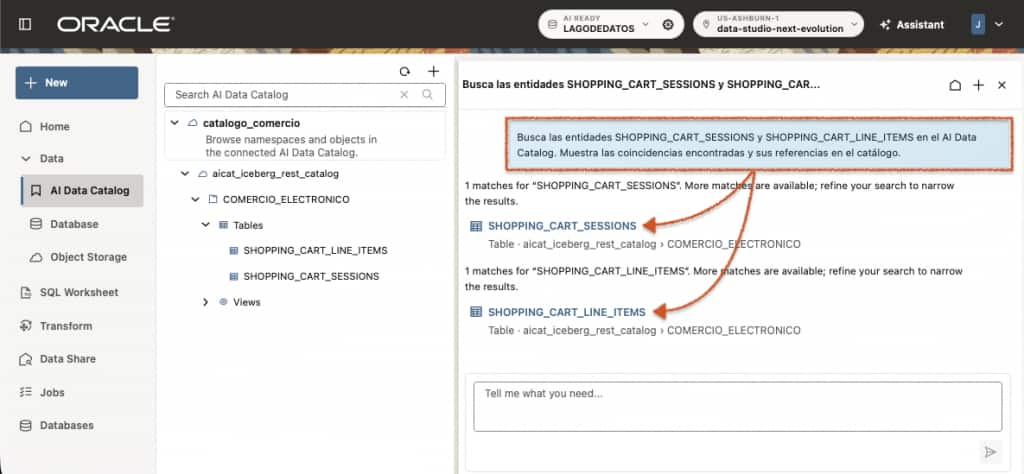
El asistente devuelve referencias a ambas tablas. Abre esas referencias e inspecciona los metadatos disponibles antes de generar SQL. Confirma que el catálogo, el espacio de nombres y los nombres de tabla correspondan a los datos que quieres analizar.
Generar SQL para consultar tablas en AI Data Catalog
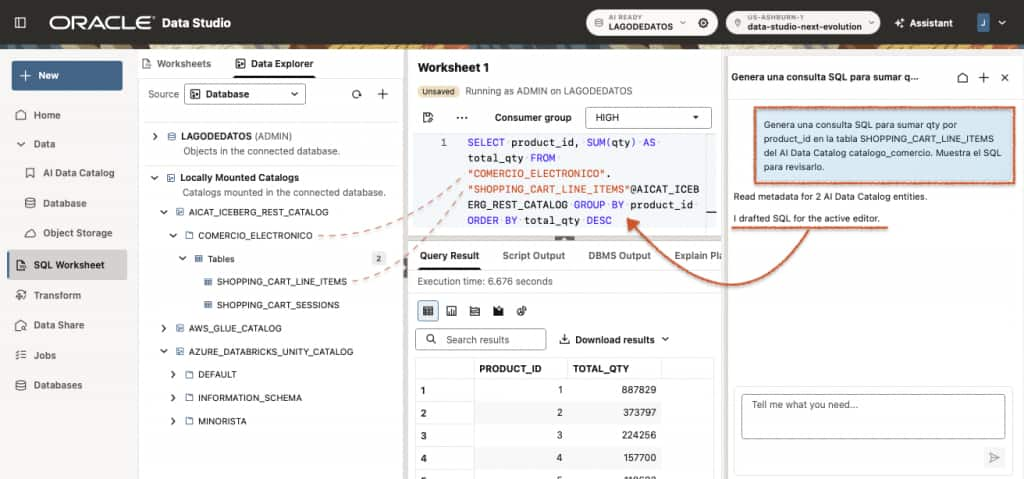
Lucía le pide al asistente que genere SQL para las partidas del carrito:
Genera una consulta SQL para sumar qty por product_id en la tabla SHOPPING_CART_LINE_ITEMS del AI Data Catalog catalogo_comercio. Muestra el SQL para revisarlo.
La solicitud se dirige a la tabla de catalogo_comercio. Lucía revisa el SQL generado, confirma que use la tabla y la agregación previstas, y lo conserva junto con el análisis para que su equipo pueda inspeccionarlo y reutilizarlo.
Cargar inventario desde OCI Object Storage
Lucía también necesita los datos de inventario de store_inventory.parquet, en el bucket lagodedatos-fuentes. Le pide al asistente que prepare una carga en una tabla de una base de datos local.
Carga el archivo store_inventory.parquet del bucket lagodedatos-fuentes a mi base de datos local como una tabla llamada store_inventory.
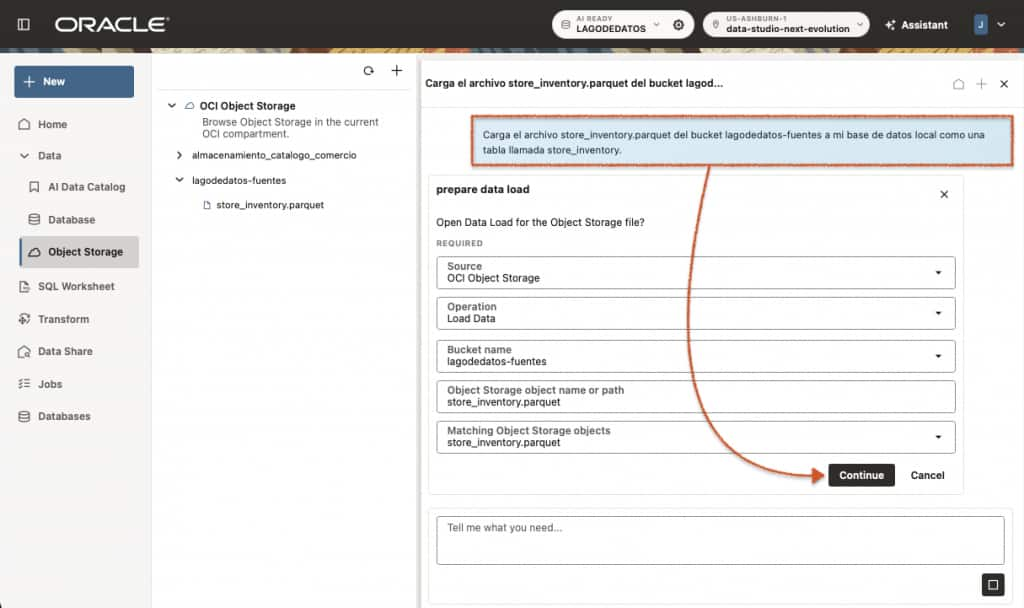
Revisa el bucket, la ruta del objeto y la base de datos seleccionada antes de continuar. Para completar la carga, sigue las instrucciones de carga, vinculación y alimentación de datos: selecciona el esquema de destino y la acción para la tabla, revisa las asignaciones de columnas y los tipos de datos, obtén una vista previa de los datos e inspecciona el SQL generado antes de crear el trabajo de carga. Consulta su avance y los errores en la página Jobs (Trabajos).
La operación Load data (cargar datos) copia los datos de origen en una tabla de la base de datos. La operación Link data (vincular datos) hace referencia a la fuente externa. Para este ejemplo, confirma que una copia local del inventario sea la opción deseada y decide cómo se actualizará antes de usarla en un análisis continuo.
Cuando el trabajo finalice correctamente, conéctate como propietario de la tabla de destino y comprueba el número de filas cargadas:
¿Cuántos registros hay en la tabla de inventario de la tienda?
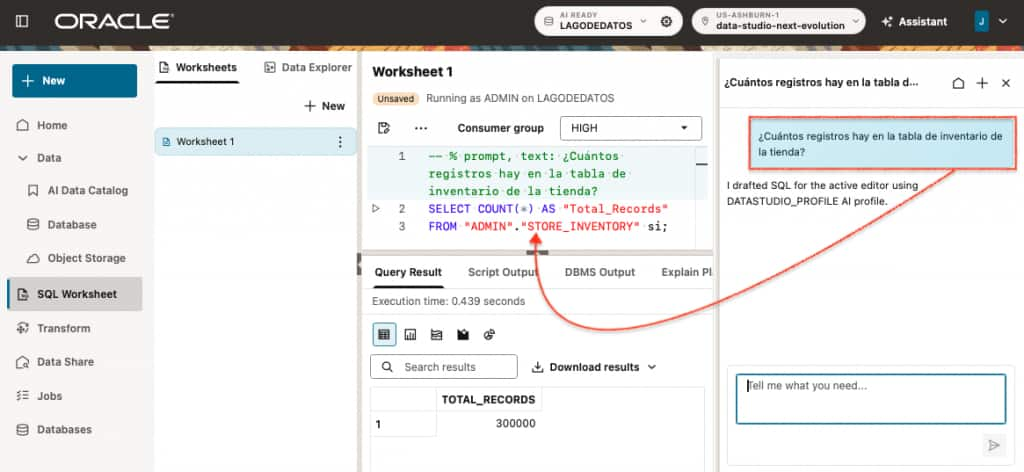
Mantener visibles las conexiones a las fuentes de datos y el flujo de trabajo de SQL
Oracle Data Studio reúne los componentes de un AI Lakehouse en un solo espacio de trabajo unificado, lo que permite a los equipos descubrir, acceder y analizar datos en varias plataformas sin cambiar constantemente de herramienta o entorno.
El análisis más amplio relaciona las ventas, los carritos de compra, el inventario de las tiendas y la disponibilidad de los proveedores. Estos conjuntos de datos pueden residir en distintos sistemas, entre ellos Oracle AI Lakehouse Databases, catálogos Apache Iceberg, AWS Glue, Azure Databricks Unity Catalog y OCI Object Storage.
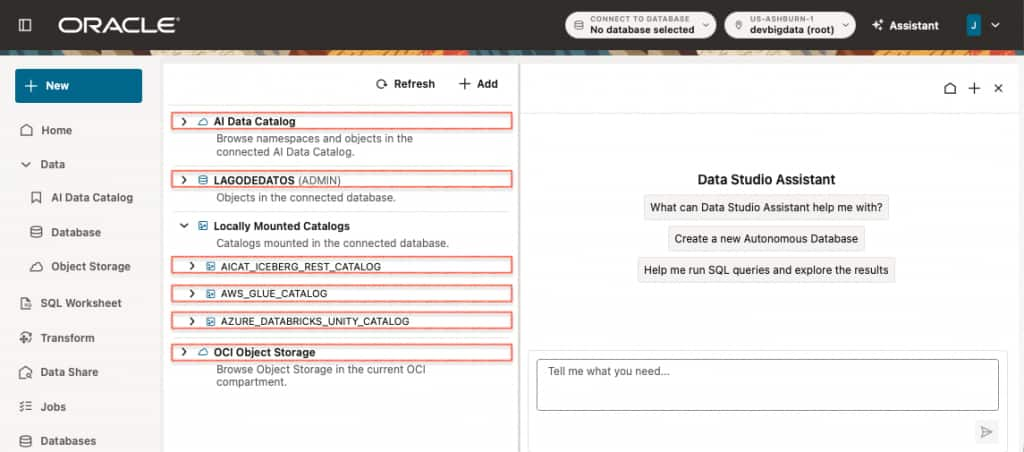
El asistente de Data Studio simplifica aún más esta experiencia al ayudar a los usuarios a explorar sus datos y generar SQL en lenguaje natural. Aunque el espacio de trabajo ofrece un punto de entrada común, las consultas que combinan varias fuentes de datos aún requieren validar las referencias de origen, las relaciones, los niveles de agregación y los resultados de ejecución.
Los equipos pueden empezar con una sola fuente y ampliar gradualmente el análisis a otros catálogos y entornos a medida que evolucionen sus necesidades.
De la demanda en los carritos de compra a las decisiones de reabastecimiento
Para identificar dónde se necesita revisar el inventario, Lucía le pregunta al Asistente de IA de SQL Worksheet:
¿Cuáles son las 10 combinaciones de producto y tienda que presentan los mayores faltantes de inventario según la demanda registrada en los carritos de compra durante los últimos siete días con datos disponibles?
Compara la cantidad total de productos en los carritos con el inventario disponible para prometer (ATP) de cada producto y tienda. Muestra el ID del producto, el ID de la tienda, la cantidad total en los carritos, el inventario disponible, la cantidad faltante y la fecha de la última actualización del inventario. Incluye únicamente las combinaciones en las que la demanda supera el inventario disponible y ordena los resultados de mayor a menor faltante.
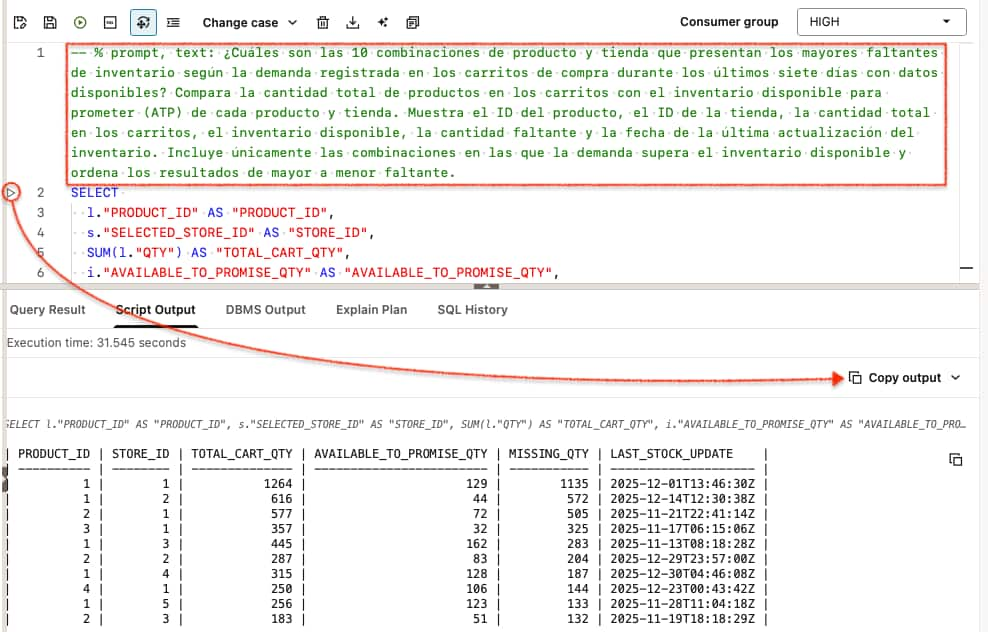
La comparación le proporciona a Lucía una lista de prioridades para su revisión. Los tres mayores faltantes de inventario son:
| Product ID | Store ID | Cart quantity | Available-to-promise quantity | Gap |
|---|---|---|---|---|
| 1 | 1 | 1,264 | 129 | 1,135 |
| 1 | 2 | 616 | 44 | 572 |
| 2 | 1 | 577 | 72 | 505 |
El siguiente paso de Lucía está claro: verificar las existencias y priorizar la revisión del reabastecimiento, comenzando por el Producto 1 en la Tienda 1. Una pregunta que abarcaba varias plataformas de datos de la empresa ahora tiene una respuesta concreta y un punto de partida para tomar medidas.
Ese es el valor de Data Studio: un espacio de trabajo unificado que conecta distintas instancias de bases de datos y catálogos, donde los equipos pueden descubrir datos, desarrollar SQL con asistencia de inteligencia artificial y transformar los resultados en decisiones de negocio. A medida que surgen nuevas preguntas, pueden ampliar y administrar sus fuentes de datos conectadas mediante la interfaz de usuario o el Asistente, integrando más datos en un mismo flujo de trabajo, desde el descubrimiento hasta la toma de decisiones.
Referencias
- Acceso al espacio de trabajo y requisitos previos – Ruta de acceso para continuar con el flujo de trabajo.
- Administración de catálogos externos de Oracle – Conceptos de catálogo y requisitos de acceso.
- Ejemplo de acceso a Databricks Unity Catalog – Exploración y consultas sobre tablas Iceberg compatibles que cumplen los requisitos.
- Oracle AI Data Catalog – Catálogo Iceberg REST administrado, metadatos y configuración del almacenamiento.
- Montar catálogos de AWS Glue e Iceberg – Conectar AWS Glue y Oracle AI Data Catalog a la vista de catálogo compartida.
- Descripción general de Autonomous AI Database – Tipos de carga de trabajo e información sobre regiones.
- Activate AI Agents on your entire enterprise data estate with innovations in Oracle Autonomous AI Lakehouse – Para obtener una visión más amplia del contexto de la plataforma.