※ 本記事は、Daniela Pavlencoによる”RAG at Scale: Keeping Evidence Current and Governed with Oracle AI Database“を翻訳したものです。(原文での読了時間:9分)
2026年11月8日
情報源や検索方法が増え、更新やアクセス管理が複雑になっても、RAGで使う根拠情報の信頼性を保つために
RAGを構築するときは、文書を取り込み、埋め込みを作成し、意味の似た内容を検索してプロンプトに加える、という単純な流れから始めることがよくあります。しかし、アプリケーションで扱う情報源や検索方法を増やし、文書の更新や権限ごとのアクセス制限にも対応していくと、この一連の処理を信頼できる状態に保つことが難しくなります。
扱うものを増やすたびに、関連するデータや設定にも食い違いがないように管理する必要があります。たとえば、元の文書を更新したら、分割した文章(チャンク)、埋め込み、メタデータ、有効・削除済みなどの状態、検索時の絞り込み条件も、その変更に合わせて見直す必要があります。質問と意味が近い検索結果であっても、内容が古い、新しい版に置き換えられている、現在の利用者にはアクセスが許可されていない、といった場合があるためです。
Oracle AI Databaseを使うと、回答の根拠を取得する処理の中で、構造化データ、ベクトル埋め込み、メタデータ、SQLによる絞り込み、データベースの制御を、まとめて扱いやすくなります。ただし、アプリケーションやモデル、一連の処理を取りまとめるロジックは、引き続き必要です。本記事では、RAGでデータを取り込んでから利用するまでの全体像を整理し、このシリーズで各テーマを詳しく説明している記事へ案内します。
主なポイント
- 情報源、検索方法、更新処理、権限ごとの制限を増やすほど、連動させるべきデータや設定も増えます。RAGを信頼して使うには、元の情報の状態、チャンク、埋め込み、メタデータ、検索ルールの間に食い違いがないようにする必要があります。
- Oracle AI Databaseを使うと、同じ根拠情報を取得する際に、リレーショナルデータ、ベクトル、メタデータ、SQLの条件、データベースの制御を、まとめて扱えます。その結果、データのコピーや、別々のシステム間で同期する箇所を減らせます。ただし、アプリケーションの処理ロジックまで不要になるわけではありません。
- アプリケーション側では引き続き、元の情報の変更を検出し、何を再処理するかを判断します。また、利用者の認証、アクセス権限の適用、モデルに渡す情報の構成、モデルの呼び出し、結果の評価も行います。
- 類似検索では、意味の近さに従って順位を付けます。それだけでは、根拠情報が最新か、正式な情報源に基づくか、必要な内容をすべて含むか、利用者が受け取ってよいかまでは確認できません。
- エージェントメモリには、やり取りが終わった後も残す情報を保存します。誰の情報か、どれだけ保持するか、どう訂正・削除するかを、独自のルールで管理する必要があります。メモリを使っても、外部の知識を検索する仕組みが不要になるわけではありません。
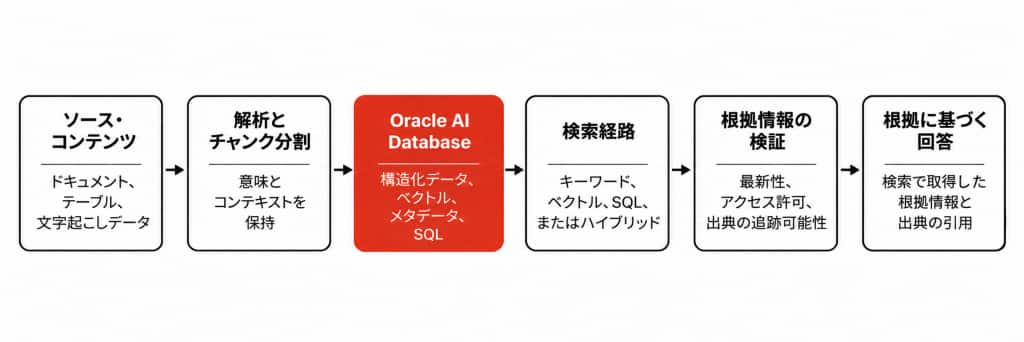
Oracle AI Databaseを使い、RAGの根拠情報を取り込んでから利用するまでの流れ
RAGデータのライフサイクル
信頼できる検索処理を設計するには、次の4つの段階を、つながりのあるものとして捉えると分かりやすくなります。
1. 元の意味を保つ。 元資料を解析してチャンクに分割する際は、それぞれを検索で取り出したときに内容を正しく解釈できるよう、必要な文脈とメタデータを残します。
2. 適切な根拠情報を探す。 質問の内容に応じて、キーワード検索、ベクトル検索、SQL、ハイブリッド検索を使い分けます。
3. 根拠情報を信頼できる状態に保つ。 回答の生成に使う前に、更新、削除、バージョン、アクセスルール、情報の出所や生成過程を示す来歴情報を反映します。
4. 結果を検証する。 検索の品質と回答の品質を別々に測定し、失敗したケースを、その後の変更で問題が再発していないか確認する回帰テストとして残します。
これらは、別々の製品を示したものではありません。同じ根拠情報を取り込んでから利用するまでの過程を、異なる観点で整理したものです。どこかの段階で確認や制御が不十分だと、後の回答生成の段階で、言語モデルに問題があるかのように見えることがあります。
1. 検索で取り出したときにも、元の意味が分かるようにする
検索で取り出せる情報の単位は、チャンクの分け方によって決まります。単に一定の文字数で区切ると、表とその見出しを別々にしたり、箇条書きを親の見出しから切り離したりすることがあります。会話の記録では、発言の意味を理解するために必要な話者や時刻の情報が、発言本文から離れてしまう場合もあります。目指すのは、テキストの長さを均等にそろえることではありません。検索結果として取り出したときに、その部分だけでも内容を理解できるようにすることです。
根拠となる文章には、メタデータも付けて引き継ぎます。元資料の識別子、文書のバージョン、タイムスタンプ、テナントの対象範囲、アクセスラベル、文書の種類、解析処理のバージョン、埋め込みモデルのバージョンなどです。これらの情報も、そのチャンクを検索で取得し、回答に引用してよいかを判断するうえで重要です。
取り込み方の詳細は、表、PDF、会話記録、メディアを対象にしたRAGのチャンク分割と解析で説明しています。設計上の原則は、内容を役立てるために必要な文脈を失ったまま、ベクトルに変換しないことです。
2. 質問に合う方法で、必要な根拠を探す
RAGで情報を取得する方法は、ベクトル検索だけではありません。正確な識別子やエラーコードを探すときは、語句の一致を確認する検索が必要になる場合があります。現在の件数や運用状態は、SQLで取得するのが適切です。一方、元の資料とは異なる言葉で尋ねられた質問には、ベクトル検索が向いています。完全一致と意味の近さの両方が必要な質問では、ハイブリッド検索を使う理由があるかもしれません。ただし、複数の検索指標を組み合わせることで、対象の処理における結果が改善すると、測定で確認できた場合に採用します。
類似検索では、ユーザーの質問を表す埋め込みと、文書のチャンクやレコードについて保存した埋め込みを比較します。選択した距離または類似度の指標を使い、ベクトルがどの程度近いかに従って順位を付けます。たとえば、コサイン距離では、距離が小さいほど意味が近いと判断します。この値は順位付けの手掛かりであり、「何パーセントの確率で信頼できるか」を表すものではありません。意味が近いというだけで、その内容が最新か、正式な情報源に基づくか、アクセスを許可されているかまでは判断できません。それらを確認するには、元資料のバージョン、有効・削除済みなどの状態、来歴情報、アクセス制御を調べる必要があります。
| 質問の内容 | 最初に試す取得方法 | その方法で確かめること |
|---|---|---|
| 正確なID、名前、エラーコードを探す | キーワード検索または全文検索 | 指定した語句と完全に一致すること |
| 元資料とは違う言い方で、同じ趣旨を尋ねる | ベクトル検索 | 意味が似ていること |
| 現在の件数や状態を調べる、条件で絞り込む | SQL | 正式な情報源の構造化データから事実を取得すること |
| 完全一致と意味の近さの両方を求める | ハイブリッド検索 | 互いに補い合う検索指標を組み合わせること |
Oracle AI DatabaseのOracle AI Vector Searchを使うと、リレーショナルデータと併せてベクトルを問い合わせ、SQLによる制御も適用できます。データベース側の概念については、Oracle AI Vector Searchユーザーズガイドを参照してください。
取得方法を比較する際は、どの方法でも同じ質問集合を使うべきです。本番RAGの評価:キーワード検索、ベクトル検索、SQL、ハイブリッド検索のどれを選ぶかでは、検索の評価指標と回答の評価指標を分ける、実践的な方法を説明しています。
3. 根拠情報を最新に保ち、アクセスや利用を適切に管理する
検索に使うデータは、正式な情報源から作った派生データです。元の内容を変更したときは、その影響を受ける検索用データと設定を、アプリケーション側ですべて整合させる必要があります。対象には、チャンク、埋め込み、元資料と埋め込みのバージョン、有効・削除済みなどの状態、テナントとアクセスに関するメタデータ、取得を許可するレコードを決める絞り込み条件が含まれます。これらに食い違いがあると、質問と意味が近くても、最新ではない情報、正式な情報源に基づかない情報、利用者にアクセスを許可していない情報を、ベクトル検索で返してしまう可能性があります。
- 変更されるレコードをすべて埋め込みに変換するのではなく、現在の構造化された事実は、その都度SQLで取得します。
- 文書を更新したときは、影響を受けるチャンクだけを増分更新し、元資料と埋め込みのバージョンを記録します。
- 削除したことや、新しい版に置き換えたことを、検索対象のレコードにも反映します。
- 古い情報と新しい情報の両方がある状況で、正しい結果を取得できるかを試す質問を用意します。
ここで使う用語は、検索システムの異なる部分を指しています。埋め込みとは、埋め込みモデルを使って、文章のチャンクから生成した数値ベクトルです。ベクトルストアのレコードとは、チャンクのテキスト、その埋め込み、元資料の識別子、バージョン、有効・削除済みなどの状態、その他のメタデータを保存するデータベースの行です。データベースのベクトル索引とは、類似検索を効率よく行うために、ベクトル列に作成する検索用の構造です。文書や埋め込みを別途コピーしたものを指すわけではありません。
ここでいう検証用の質問は、元資料の更新を正しく反映できるかを、意図的に試すために作成するテストクエリです。たとえば、元の文書を更新した後、新旧両方のバージョンが検索システム内にある状態で、現在の値を尋ねます。現在有効で利用者に許可された版を取得し、置き換え済みや削除済みの版を除外し、回答で現在の根拠情報を引用できれば、更新反映のテストに合格したと判断します。
情報を最新に保つ方法は、リアルタイムRAG:その都度SQLで取得する方法、増分の索引更新、最新情報を取得できるかのテストで説明しています。関連する索引のライフサイクルについては、RAG索引のずれを検出する:削除文書、古いチャンク、重複する埋め込みで扱います。後者の記事では、このずれを、元資料と索引の間に生じる整合性の問題として捉えています。
根拠情報を適切に管理するための確認や制御も、取得からモデルに渡すまでの同じ処理の中に組み込みます。モデルに情報を渡す前に、テナントの対象範囲、アクセスラベル、削除状態、来歴情報を使って、何を渡してよいかを判断すべきです。プロンプトで指示するだけでは、権限に基づくアクセス制限にはなりません。情報源を引用する場合も、その利用者が受け取ってよい根拠情報を参照していることが前提です。
セキュリティの設計は、企業向けRAGを安全にする:ACL、テナントフィルター、来歴情報、Oracle Deep Data Securityで詳しく説明しています。
4. RAGとエージェントメモリの役割を分ける
RAGでは、今回の質問に答えるために、外部の資料などから根拠情報を取得します。エージェントメモリには、ユーザーの好み、決定事項、要約、タスクの結果、長期的に保持する事実など、選んだ情報を、やり取りをまたいで保存します。どちらにも類似検索を使えますが、保持、訂正、削除、対象範囲について求められるルールは異なります。
RAGのレコードは、通常、元の文書やデータベースの行まで追跡できるようにしておくべきです。メモリのレコードでは、それに加えて、誰の情報か、いつまで有効か、何を根拠としているか、どう訂正または削除できるかも明確にする必要があります。会話のすべてのメッセージをメモリとして扱うと、不要な情報がモデルへの入力に増え、信頼性を損ないます。
エージェントメモリはRAGとは異なる:会話ID、長期保存する状態、対象範囲を限定した履歴の取得では、この役割分担と、永続メモリの対象範囲やライフサイクルのルールを明示すべき理由を説明しています。
5. 検索の失敗と回答生成の失敗を切り分ける
検索に問題がある場合も、回答の生成に問題がある場合も、表面上は同じ「誤った回答」として現れることがあります。どこを直すべきかは、モデルにどの情報が渡ったかによって判断します。必要な根拠が検索結果の上位k件に含まれていなければ、チャンクの分け方、埋め込み、絞り込み条件、順位付け、情報の新しさを調べます。根拠は含まれているのに、モデルが裏付けのない主張を作ったり、間違ったバージョンを引用したりした場合は、モデルへの入力情報の構成、プロンプト、生成処理を調べます。
取得したチャンクのID、元資料のバージョン、スコア、絞り込み条件、使った取得方法をログに記録します。
正解を定めた質問集合を使い、Recall@k、Precision@k、NDCG@kなどの指標で検索の品質を測定します。ここでkは、評価対象とする検索結果の件数です。
Recall@kでは、正解として分かっている関連情報のうち、検索結果の上位k件でどれだけ取得できたかを、割合で測ります。Precision@kでは、上位k件のうち、質問に関連する情報がどれだけ含まれているかを、割合で測ります。NDCG@kでは、関連性の高い根拠情報を、より上位に並べられているかを測ります。
回答については、根拠資料に基づいているか、内容が正しいか、引用が妥当か、答えられないときに回答を控えているかを、検索とは別に評価します。
古い情報、削除済みの情報、アクセス制限のある情報、重複情報を扱う質問や、裏付けとなる情報がない質問を、回帰テストのケースとして残します。
AIアプリケーションでベクトル検索の問題を調べる方法では、検索処理を後から調べられるようにする方法を中心に説明しています。評価ガイドでは、より広い観点から測定の進め方を説明しています。
Oracle AI Databaseを使い、別々に同期・調整する箇所を減らす
複数の仕組みに分けた構成では、元のシステム、チャンク分割のパイプライン、埋め込みの作成処理、検索用ストア、メタデータとアクセス制御の層、キャッシュで、同じ根拠情報を異なる状態で保持していることがあります。検索結果を安全に返すには、元の情報の変更、削除、権限の更新を、こうした各部分に反映する必要があります。
Oracle AI Databaseを使うと、構造化データ、ベクトル埋め込み、メタデータ、SQLによる絞り込み、データベースの制御を、同じ根拠情報の取得処理の中で、まとめて扱いやすくなります。そのため、別々の仕組みの間で同期・調整する箇所を減らせます。アプリケーションでは、最新のリレーショナルデータに基づく事実、文書検索、来歴情報、有効・削除済みなどの状態、アクセス権限を考慮した絞り込み条件を組み合わせられます。検索のためだけに、管理の基準となるデータを別の独立したストアへコピーする必要がありません。
それでも、アプリケーション側で行うべき処理は残ります。変更の検出、SQL、キーワード検索、ベクトル検索、ハイブリッド検索のどの方法で取得するかの選択、利用者の認証、モデルに渡す情報の構成、結果の評価は、引き続き必要です。1つのデータベースを使えば、すべての課題を解決できるという意味ではありません。どの根拠情報が最新で利用可能なのかについて、状態を同期させておく独立したシステムを減らせることが利点です。
解決したい問題に合わせて、次に読む記事を選ぶ
- PDF、表、会話記録、メディアから、意味を失わずに情報を取り出したい場合:表、PDF、会話記録、メディアを対象にしたRAGのチャンク分割と解析から始めてください。
- キーワード検索、ベクトル検索、SQL、ハイブリッド検索の使い分けを決めたい場合:本番RAGの評価:キーワード検索、ベクトル検索、SQL、ハイブリッド検索のどれを選ぶかを参照してください。
- 元資料の変更に合わせ、最新の内容を検索できるようにしたい場合:リアルタイムRAG:その都度SQLで取得する方法、増分の索引更新、最新情報を取得できるかのテストと、RAG索引のずれを検出する:削除文書、古いチャンク、重複する埋め込みを参照してください。
- テナントの対象範囲、アクセス制御、削除状態、来歴情報を取得処理に反映したい場合:企業向けRAGを安全にする:ACL、テナントフィルター、来歴情報、Oracle Deep Data Securityを参照してください。
- 外部の知識を検索するのではなく、エージェントが使う状態を会話をまたいで保存したい場合:エージェントメモリはRAGとは異なる:会話ID、長期保存する状態、対象範囲を限定した履歴の取得を参照してください。
- 誤答の原因が検索にあるのか、回答生成にあるのかを判断したい場合:AIアプリケーションでベクトル検索の問題を調べる方法と、評価ガイドを参照してください。
まとめ
RAGを、単に1回のベクトル検索を呼び出す処理と捉えると、運用を難しくしてしまいます。取り込み時に元の意味を保ち、質問に合う方法で検索し、根拠情報を最新に保ち、アクセスルールを適用する必要があります。さらに、メモリと外部の知識の役割を分け、検索の品質と生成の品質を別々に測定することも必要です。
Oracle AI Databaseを使うと、これらの処理に共通する、データと利用ルールを管理する層を用意できます。構造化データ、ベクトル、メタデータ、SQLによる制御をまとめて扱うことで、RAGシステムの規模を拡大しても、別々に整合性を保たなければならない処理を減らせます。
よくある質問
RAGでは、どの質問にもベクトル検索だけで対応できますか。
いいえ。意味が似た情報を探すには有効ですが、正確な識別子やエラーコードにはキーワード検索が必要になる場合があります。構造化データの現在の値はSQLで取得し、質問によってはハイブリッド検索を使うほうがよい場合もあります。ベクトル検索だけに限定せず、質問に合う取得方法を選んでください。
検索で取得する根拠情報を、最新に保つにはどうすればよいですか。
ベクトル索引は、元の情報から作った派生データとして扱います。元の内容を変更したら、影響を受けるチャンクを更新し、削除されたことや、新しい版に置き換えられたことを反映します。元資料と埋め込みのバージョンも記録してください。さらに、新旧の根拠情報が共存する状況でも、最新の情報を正しく取得できるかをテストします。
変更されるデータベースのレコードは、必ず埋め込みに変換すべきですか。
いいえ。頻繁に変わる構造化データの値は、可能であれば、その都度SQLで取得します。埋め込みは、意味の近さで探すことに利点があるテキストに向いています。RAGでは、現在の値をSQLで取得し、その裏付けや背景となる情報をベクトル検索やハイブリッド検索で取得する、といった組み合わせができます。
エージェントメモリとRAGは、同じものですか。
いいえ。RAGでは、今回の質問に答えるため、外部から根拠情報を取得します。エージェントメモリには、好み、決定事項、要約、タスクの結果など、選んだ情報を、やり取りをまたいで保存します。メモリには、誰の情報か、対象範囲はどこまでか、どれだけ保持するか、どう更新するかを、明示したルールが必要です。
誤答の原因が検索にあるのか、回答生成にあるのかを、どう見分けますか。
回答そのものを調べる前に、取得したチャンクのID、元資料のバージョン、スコア、絞り込み条件、使った取得方法を確認してください。必要な根拠が取得できていない、または古い情報を取得している場合は、検索や索引の処理に問題があります。根拠は取得できているのに、回答に裏付けがなかったり、内容が間違っていたりする場合は、プロンプト、モデル、情報を渡して回答を生成する部分を調べます。
構造化データ、ベクトル、メタデータを、まとめて扱うのはなぜですか。
Oracle AI Databaseにまとめて保存すると、同じ根拠情報を取得する処理に、SQL、メタデータによる絞り込み、来歴情報、更新、利用ルールの管理を適用しやすくなります。設計が不要になるわけではありませんが、状態を同期しておく必要がある独立したシステムを減らせます。
参考資料
- 表、PDF、会話記録、メディアを対象にしたRAGのチャンク分割と解析
- 本番RAGの評価:キーワード検索、ベクトル検索、SQL、ハイブリッド検索のどれを選ぶか
- エージェントメモリはRAGとは異なる:会話ID、長期保存する状態、対象範囲を限定した履歴の取得
- リアルタイムRAG:その都度SQLで取得する方法、増分の索引更新、最新情報を取得できるかのテスト
- 企業向けRAGを安全にする:ACL、テナントフィルター、来歴情報、Oracle Deep Data Security
- RAG索引のずれを検出する:削除文書、古いチャンク、重複する埋め込み
- AIアプリケーションでベクトル検索の問題を調べる方法
- Oracle AI Vector Searchユーザーズガイド