※ 本記事は、Venkatanathan Varadarajanによる”Connect, access, and govern multicloud data estates with Oracle Autonomous AI Lakehouse“を翻訳したものです。
2026年11月2日
企業のデータ資産は現在、オンプレミスやクラウド上の複数の業務用Oracle Database、分析用のOracle AI Lakehouse、Oracle Fusionなどのアプリケーションデータに分散しています。Oracle以外のデータソースや他社のカタログに企業データを保存するアプリケーションもあります。従来、これらの多様なデータ資産から価値を引き出すには、専門のデータエンジニア、業務アナリスト、管理者の協力が必要でした。AIエージェントの登場により、レイクハウス基盤が、(a)すべてのデータソースに安全に接続して横断アクセスを提供し、(b)ETLなしで最新データを利用し、(c)エージェントに業務の文脈を与える意味情報の層を提供する、一元的な画面を備えれば、これらを自動化できる可能性があります。
Oracle AI Data Catalogの紹介
本日発表するOracle AI Data Catalogは、AIに対応するために既存のものを置き換えることなく、オンプレミスのデータベース、既存のデータレイク、レイクハウスを統合します。多様なデータソースへの一元的なデータゲートウェイとして、AIエージェントとユーザーに、安全でガバナンスの下にある最新データへのアクセスを提供します。Oracleのデータソースを安全に接続するだけでなく、Oracleの企業向けセキュリティとガバナンスをOracle以外のソースにも適用します。さらに、豊富な意味情報を自動収集し、接続したすべてのデータ資産からAIエージェントが効率的に価値を引き出せるよう支援します。
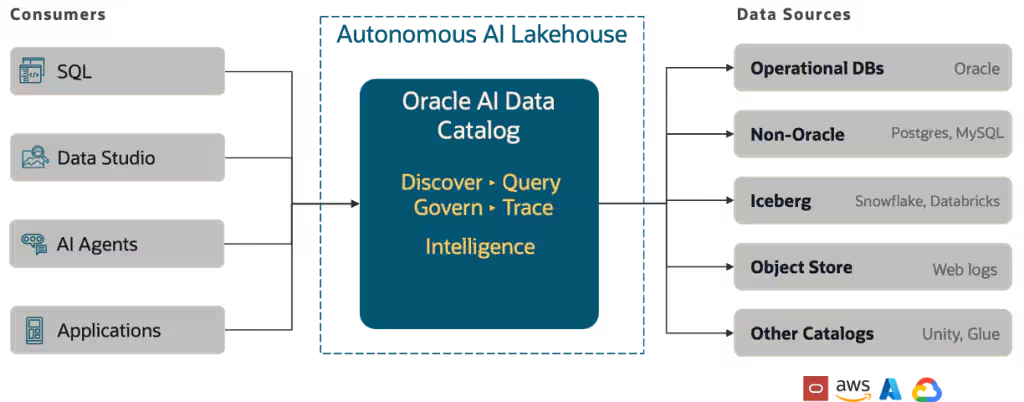
図1:Oracle AI Data Catalogの紹介
カタログはOracle Autonomous AI Lakehouseに組み込まれ、Iceberg RESTカタログを含みます。Oracleのデータベースエンジンを使い、Icebergカタログや他のデータベースなど、複数のデータソースを横断するクエリを実行できます。
Autonomous AI Lakehouseのデータカタログでは、ユーザーとエージェントは次の操作ができます。
- 検出: Oracle Data Studio、またはREST APIを使う独自クライアントから登録済みカタログを調べます。完全マネージドのIcebergカタログが含まれ、追加のカタログを接続してスキーマや名前空間、テーブルを参照できます。
- クエリ: エージェントで登録済みデータを検索したり、Autonomous AI LakehouseでSQLを実行したりします。テーブルやビューは、共通の3要素名
<schema>.<object>@<catalog>で参照します。同じ構文をSparkベースのクエリエンジンで使えるSparkコネクタも提供します。 - 統制: ユーザー、グループ、ロールをカタログで一元管理し、ロールベースのアクセス制御(RBAC)でカタログオブジェクトへの権限を割り当てます。これらの権限は接続されたクライアントやクエリエンジンからの要求を制御し、ソース側の権限も引き続き適用されます。
- インテリジェンス: AIによるメタデータ拡充、注釈(Annotation)、分析ビューを追加し、登録資産に業務上の意味や文脈を与えます。これはAI分析の改善に役立ちます。AIによる意味に基づく絞り込みで、数百の登録データソースを効率的に検索できます。
- 追跡: OpenLineage対応システムは、データ変更をOracle AI Data Catalogへ報告できます。カタログはデータ資産全体の来歴レポートをまとめ、ユーザーはOracle Data StudioやREST APIから照会できます。OpenLineageプラグインを設定するか、Oracle Data TransformsやOracle Databaseから来歴を自動収集することで、レイクハウスのワークフロー全体にわたり出所を追跡できます。
すべてのデータを接続する
レイクハウス全体のデータ接続を実現するには、既存のあらゆるカタログとの相互運用性が重要です。そのため、次のようなソースへの接続が必要になります。
- クラウドやオンプレミスにまたがる業務データを持つOracle Database
- PostgreSQLやMySQLなど、Oracle以外のデータベース
- Icebergカタログに登録された、オブジェクトストレージ上の外部構造化データ
- Microsoft Purview、AWS Glue、Unity Catalogなどのカタログの集合
スキーマとテーブルを含むデータベースカタログだけでなく、Unity Catalogのようなカタログの集合にも接続する必要があります。このような集合を「メタレイク」と呼びます。データ管理担当者はカタログをメタレイクにまとめ、外部のメタレイクにも接続できます。
Oracle AI Data Catalogは、データベースや他のカタログを一か所で接続する「カタログのカタログ」、統合メタレイクを提供します。さらに、OCI Object Storage、Azure、オンプレミスのストレージにあるすべてのIcebergテーブルを管理する、標準のネイティブIcebergカタログも提供します。
Oracle Data Studioでカタログを見つけて参照する
データカタログは、https://datastudio.oracle.comから利用できるData Studioの中心部となります。管理者はカタログを作成し、データソースを接続し、ガバナンスルールを設定できます(後述)。権限を持つユーザーはData Studioにログインし、アクセスできるレイクハウスのカタログを参照し、組み込みAIアシスタントやSQL Worksheetで直接クエリできます。
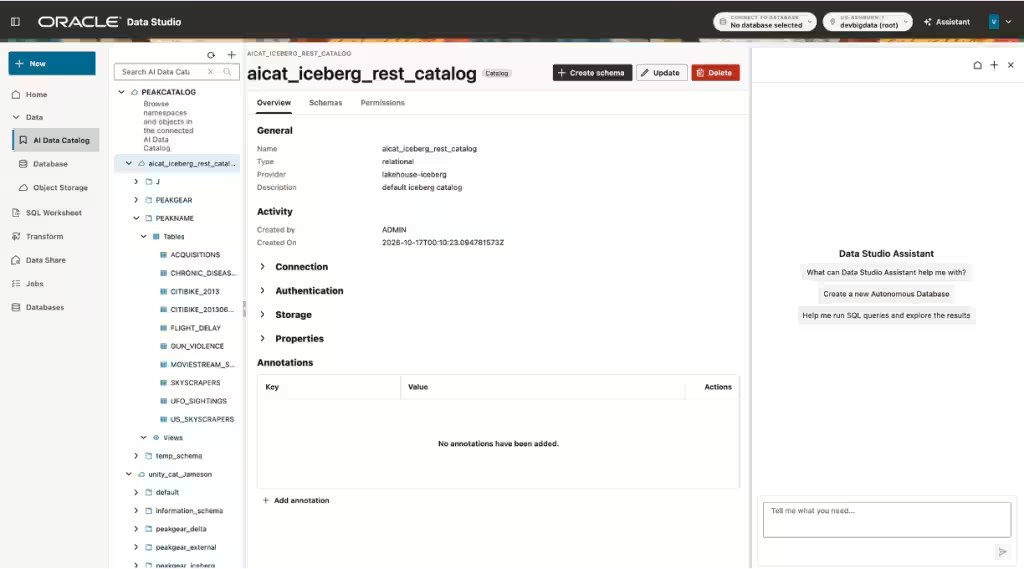
図2:Oracle Data Studioのカタログナビゲータ
アクセス制御を一度だけ定義し、全体に適用する
データをAutonomous AI Lakehouseに格納している場合、ユーザーはソース側ですべてのガバナンスルールを適用できます。しかし、すべてのデータソースが同じ強力なポリシーを備えるわけではありません。Oracle AI Data Catalogは、Oracle以外も含むすべてのソースに統一的なガバナンスを提供します。管理者はメタデータとデータのアクセス権限をロールにまとめ、ユーザーやグループに割り当てられます。管理しやすいよう、データソース全体、その中のオブジェクトやテーブルの集合など、階層内の異なる単位でロールを一元定義し、必要に応じて付与、取り消しができます。
Oracle AI Lakehouseからカタログに接続されたデータへアクセスする
カタログに列挙されたデータソースには、さまざまな方法でアクセスできます。
- Oracle AI Lakehouseで、自然言語や3つの部分(xx.yy@zz)からなるカタログ識別子を使うSQLにより、作成、更新、クエリを行います。例:
SELECT * FROM SALES.ORDERS@SALES_DB - 既存のSpark基盤でOracle Sparkコネクタを使い、カタログ内のデータをクエリします。
- MCPツールで、AIエージェントからカタログに直接アクセスします。
- 独自クライアントからREST APIを使い、カタログのメタデータを直接照会します。
前述のとおり、すべてのカタログアクセスは、管理者がOracle AI Data Catalogに定義したポリシーで一元管理されます。権限を持つユーザーとエージェントは、ETLを行わずに、データが利用可能になるとすぐアクセスできます。
カタログのデータに意味と業務上の文脈を付加する
AIエージェントが効果的かつ効率的に動けるよう、ユーザーはカタログオブジェクトに業務上の意味を追加できます。組み込みエージェントはその文脈を自動的に利用して、関連データを見つけます。
カタログのデータには、次の3つの方法で意味情報を付加できます。
- メタレイク、カタログ、スキーマ、テーブル/ビュー、列という階層の各段階に、自由形式の注釈を付けます。エージェントは注釈を使って関連データを探せます。
- Oracle AI LakehouseのAIによる拡充機能で、カタログ、スキーマ、オブジェクト(テーブル、ビュー、列)の説明を自動生成します。
- Oracle AI Lakehouseでデータの上に分析ビュー(一般にセマンティックビューとも呼ばれます)を作り、属性ディメンション、業務指標、階層を定義します。Apache Ossieの移植可能なYAML形式で、セマンティックビューを容易にインポート、エクスポートすることもできます。
データの来歴から出所を追跡し、理解する
クエリ対象を特定した後、ユーザーはレポートで使う前に来歴を確認し、信頼できる出所かを確かめられます。Oracle Data Transformsのデータフローによる変更や、監視対象のOracle Database内のデータ変更も含まれます。OpenLineageイベントを生成するSpark、Trino、dbt、Apache Airflowなどの他社システムから、イベントを受け取るように設定することもできます。これにより、データエンジニアはレイクハウス内のすべての変更と移動が追跡されることを確認できます。
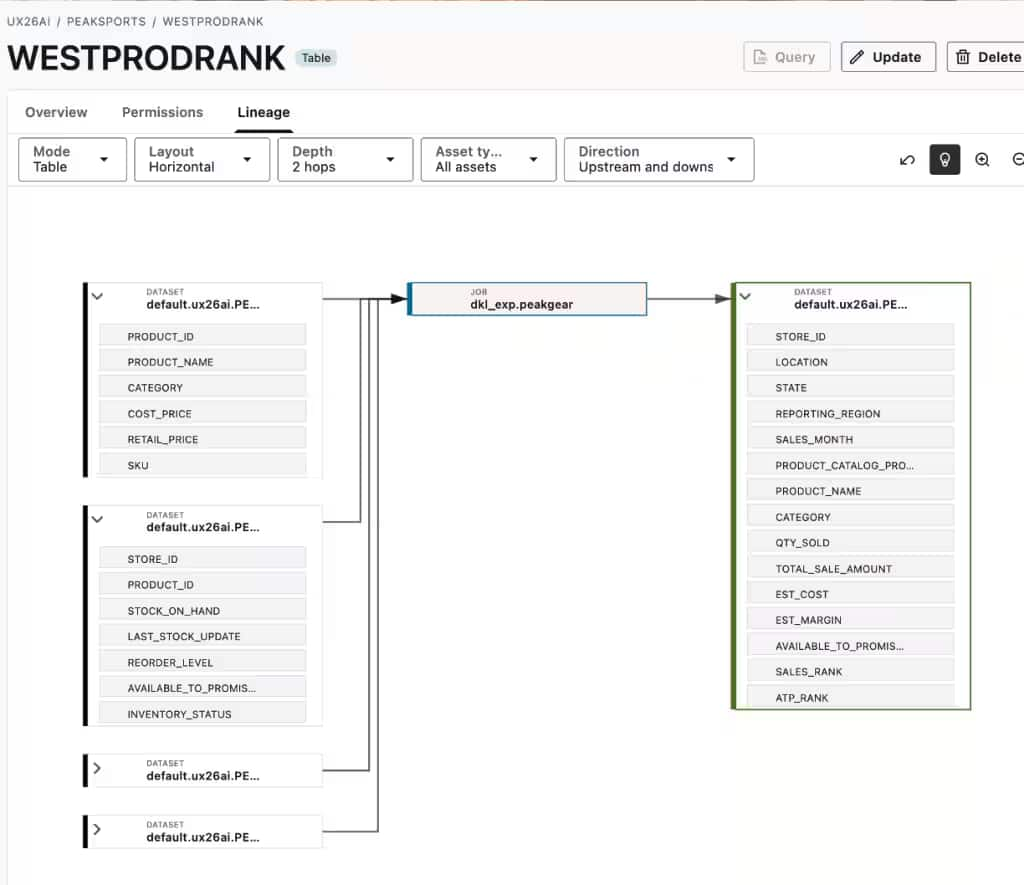
図3:OpenLineageで収集したテーブルのデータ来歴の例
機能を組み合わせたユースケース
小売企業が、注文明細をオンプレミスのOracle Database、顧客情報をマネージドクラウドデータベース、製品情報をUnity Catalog経由で登録されたIcebergテーブルに保存している例を考えます。管理者はこれらをOracle AI Data Catalogに接続し、適切なカタログ権限を持つdata_analystロールを定義して、アナリストに付与できます。アナリストはData Studioにログインしてカタログに接続し、次のSQLで3つのソースを直接結合できます。
SELECT o.order_id, c.customer_name, p.product_name FROM "sales"."order_lines"@ORACLE_ORDERS o JOIN "crm"."customers"@ORACLE_CRM c ON o.customer_id = c.customer_id JOIN "products"."items"@UNITY_ICEBERG p ON o.product_id = p.product_id;
カタログに意味情報を付けると、組み込みAIアシスタントに「カタログの注文明細、顧客、製品テーブルを使い、各注文IDと顧客名、製品名を表示して」と依頼することもできます。アシスタントは、確認して実行できる3ソース横断のSQLを生成できます。Oracle AI Data Catalogは、異種ソースの検出、クエリ、アクセス制御、意味情報、来歴を共通のカタログ操作にまとめます。マルチクラウドのレイクハウスで動くAIエージェントは、好みのクライアントを使い、関連データの発見から理解、クエリまで進めやすくなります。まずはデータソースを接続し、Oracle Data Studioでカタログを調べてください。
Autonomous AI Lakehouseと、AIエージェントによって企業データを活用する方法をご覧ください。