原文:MySQL Development as it Happens, Part 2 – Vector Indexes
原著者:Henrik Ingo
本記事は、上記の英語記事をAIを使用して日本語に翻訳したものです。翻訳には誤訳や不正確な表現が含まれる可能性があります。内容の確認にあたっては英語原文を参照してください。
MySQL Server開発の最新動向に関する前回のブログ記事では、今年MySQLの開発プロセスがどのように変化してきたかを概説しました。
- MySQLの開発をGitHubの公開mysql-serverリポジトリに移すことを発表しました。
- MySQLコミュニティ全体のコントリビューターに参加を呼びかけました。
- Contributor Summitを2回開催し、オラクルのエンジニアとMySQLコミュニティ・メンバーがロードマップのカテゴリーを策定し、MySQLのロードマップ向けのプロジェクトを提案し、その一部に共同で取り組み始めました。
- 何より、7月初旬にはすでに、オープンソースのMySQL Community Editionへ重点を大きく移し、真に重要な成果であるMySQL 9.7 LTSとMySQL 26.7(イノベーション・リリース)を届けるため、エンジニアたちが懸命に作業を進めていました。
今回は、4つの戦略的重点分野の一つであるAI & Cloudを掘り下げ、VECTOR INDEXのサポートを詳しく見ていきます。
プロジェクトの最新情報
その前に、前回の記事から数週間、数か月の間にあったプロジェクト全般のニュースをお伝えします。
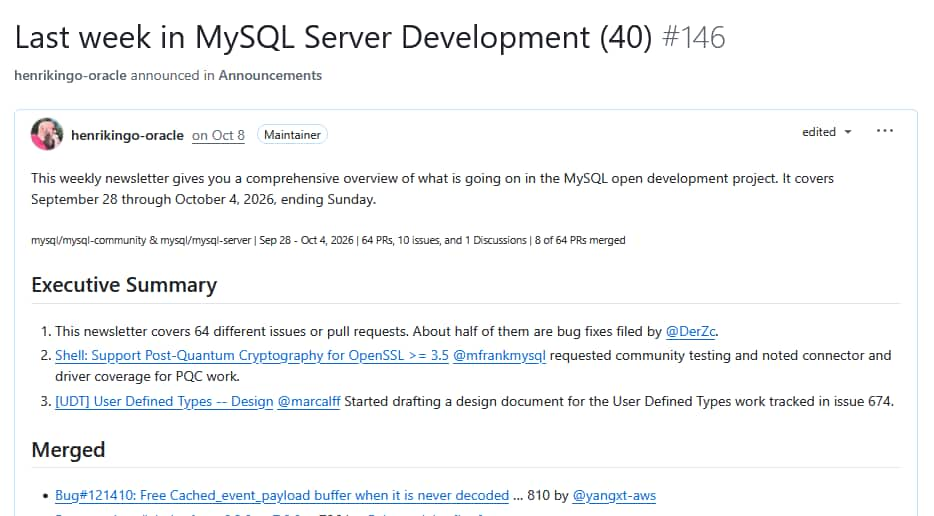
プロジェクトのコントリビューターと、関心を持って見守っている方々の双方が、プロジェクトで起きていることを漏れなく把握できるよう、週刊ニュースレターの発行を始めました。主な内容は、その週に活動があったすべてのGitHub Issueとプル・リクエストへのリンクを網羅した一覧です。
GitHubリポジトリには、おなじみのMySQL Test Run、フォーマッタ、そしてもちろん欠かすことのできないOCAボットを組み込みました。オープンソースのMySQL開発をすべて移せるよう、公開mysql-serverリポジトリの準備を引き続き進めています。作業の大半は外からは見えませんが、私たちにとって大きな変更です。基本的には、MySQLの各派生版とバージョン間でのパッチの流れが完全に逆転し、公開MySQL Community Editionリポジトリがすべての開発の新たなアップストリームになります。
ベクトルとは何か、どのようにインデックスを作成するのか
それでは、今回の主題であるベクトル・インデックスを掘り下げましょう。ベクトルをご存じの方は先に進んでいただいて構いませんが、まずは簡単な背景説明から始めます。
学校では数学の先生から、ベクトルとは矢印だと教わりました。より正確には、長さと向きを持つものです。そうかもしれませんが、同じように習った方も、その説明はいったん忘れてください。ここでは単純に、ベクトルは数値のリストです。一つのINTやFLOATのようなものですが、数値が複数あり、それらが一まとまりとなり、CPUがまとめて処理できる、といった具合です。典型的な数学表記は、次のようになります。
example_vector = v = (1.0, 4.12, 0.0 , 0.23 , 1.23)
もっと数学的に表現したければ、数値を縦に並べた列としてベクトルを書くこともできます。このようなブログ記事では、横に並べた方がわかりやすいと思います。
また、ベクトルを空間内の点として考えると便利な場合もあります。実際、次の2要素のベクトルは、
p = (50.848448, 4.353823)
地球上のある位置の緯度と経度を表せます。そして、これこそベクトルが矢印のように見え始める例です。欧州のよく知られた場所を指す矢印です。より正確には、私たちの多くがビールを1杯、2杯と飲んだことのある、ベルギーのある場所です。
つまり、上のpは2次元空間のベクトルの例です。3つの数値を持つベクトルを作り、3次元空間の点として考えることもできます。そうすれば、建物の何階にいるかをより正確に伝えられます。
AIの計算で使われるベクトルは、それぞれ数百、あるいは数千の数値を持ち、N次元であるといいます。3次元を超える空間の姿を想像するのは困難ですが、関連する数学はそれほど難しくありません。「距離」のような関数を考え、2~3次元で行うことを拡張して、代わりに1000個の数値で同じことを行えばよいのです。
ある意味では、MySQLは空間インデックスという形で、何年も前からベクトルをサポートしていたともいえます。(ここでは、世界は実際には平面ではなく曲面であるために空間インデックスが行う必要のある処理は、すべて無視しています。)今度は、2次元の代わりにN次元で同じようなことを行いたいのです。
AIにおけるベクトル
では、人工知能でベクトルが使われるのはなぜでしょうか。空間内の点が突然これほど重要になるのはなぜでしょうか。簡単にいえば、AIではあらゆるものを数値に符号化し、単純ながら強力な計算をそれらに対して行い、その先で有用なものを得るからです。
たとえば、典型的なユースケースとして、このブログ記事のようなテキストを処理したいAIを考えられます。ブログ記事に対する計算を効率的に行うため、記事ごとに一つのベクトルを作り、その中の数値で単語の出現を表すようにします。たとえば、この記事のここまでのテキストは、次のようなベクトルで表せます。
blog=(18,26,26,8,8,7,7,7,7,24,16,7,8,23,14,6,15,11,19,10,7,11,6,10,12, …)
これは、次の単語の出現回数を表しています。
(MySQL , a , and , are , be , blog , development , for , have , in , is , like , numbers ,
of , on , post , that , this , to , vector , vectors , we , will , with , you …)
これらは、この記事のここまでに出現した単語です。
ここで、これらのベクトルを、各単語が一つの次元となる空間内の点として考えると、世界中のすべてのブログ記事を含む空間ができます。私たちのベクトルは、AIモデルにとって何らかの意味を持つ空間に埋め込まれるため、「埋め込み(embedding)」になりました。なお、この単純な例では単語が「トークン」ですが、常にそうであるとは限りません。
ブログ記事を、それ以上の意味をあまり持たない単なる「単語の袋(bag of words)」に単純化したとしても、この空間内で二つのベクトルが近ければ、それらが表す実際のブログ記事にも、おそらく多くの共通点があるだろうと直感的に考えられます。
この例では、ベクトルやMySQL、AIについて書かれた記事は多数あるでしょう。一方で、ビールやベルギーについての記事はさらに多くあります。この記事は両方に触れているので、ブログ記事の宇宙では、人々が書くこうした大きく異なる二つの話題群の中間のどこかに位置することになります。
データベースはベクトルに対して何をする必要があるのか
上の例では、ベクトルは各ブログ記事を直接符号化したものでした。実際には、AIモデルで使われるベクトルの値は、モデルが経る学習プロセスから得られます。ただし、この記事はベクトルとデータベースについてのものなので、ここで話を止めます。他の多くのアプリケーションと同じく、実際の計算レイヤーは私たちの担当ではありません。必要なのは、ベクトルを保存し、AIが必要としたときに返すことだけです。そして、ベクトルとはN次元の数値にすぎません。
もう一つ、扱える必要があるのは距離の概念です。二つのベクトルが近いか遠いかを判断する必要があり、通常はそれが「類似している」か異なるかという意味になります。私たちが暮らす3次元の世界では、いわゆるユークリッド距離を使います。
_________
d = \/ x 2 +y 2
または _______________
d = \/ x 2 +y 2 +z2
これはN次元でも有用であることがわかっています。上のzの後に、さらに変数を追加するだけです。ただし、他の距離関数も使われます。最終的には、どの距離関数かはそれほど重要ではなく、どの場合もインデックス付けと検索はおおむね同じように機能します。
AIがデータベースからベクトルを取得するとき、通常は、ある点に近い他のベクトルをすべて取得したいと考えています。近傍のベクトルは、入力ベクトルが表すある話題と、その周辺について私たちが持つすべての知識を表します。たとえば、「今夜この後、Fosdemのビール・イベントに行きますか?」という文に「類似」するすべてのブログ記事を、データベースへの問合せで取得する必要があるかもしれません。
そのためには、この文についても単語の袋を作ります。上と同じ符号化を用いると、次のようになります。
question=(0,0,0,1,0,0,0,0,0,0,0,0,0,0,0,0,0,0,1,0,0,0,0,0,1, …1,…)
これは、次の単語の出現回数を表します。
(…, are , …, to , …, you …,beer, …)
ご覧のように、質問を表すこのベクトルの「近く」にあるベクトルを検索し、同じ単語を含む他のテキストを見つけられます。ここで「近い」が正確に何を意味するかは、使う距離関数によります。ユークリッド距離も使えますが、その場合、結果の大半が同程度の長さにもなります。たとえばハミング距離は、各次元で1か0だけを数えます。ある単語が何度繰り返されても、1としてしか数えません。実際には、いわゆるコサイン距離がよく使われており、私たちのプロジェクトでも実装される予定です。
要件における理想は「ハイブリッド検索」です。これは、フル機能のSQLデータベースで従来から使っている他のすべての問合せ述語と、ベクトル検索パラメータを併用できることを意味します。問合せオプティマイザが、データベース内の他のすべてのインデックスから選択すると同時に、ベクトル・インデックスの使用も検討できるということかもしれません。さらに進めれば、ベクトル、数値、単語のすべてを内部に埋め込んで走査するインデックス構造を使うことも考えられます。複合インデックスが単一列インデックスより効率的なことが多いのと、ある意味では同様です。
ここまでの内容をまとめると、AIモデル用のベクトル取得は、基本的には次のSQL問合せです。
… ORDER BY distance([input point p], [vector column v]) LIMIT k
唯一の注意点は、ベクトルとその距離がN次元空間に存在することです。
kNN、ANN、その他の用語
したがって、問題を最も単純に定式化すると、pに対するk個の最近傍(k Nearest Neighbors)を返すことになります。素朴な実装では、データセット全体を一度検索する、すなわちO(N)の時間で実行できます。これを改善するため、K-D木やR木などのアルゴリズムがあります。しかし残念ながら、これらが役立つのは、2次元や3次元の空間インデックスのような低次元の場合に限られます。
しかし、はるかに強力でわかりやすい最適化は、問合せに対する厳密に正しい答えを気にしないことが多い、という気付きから生まれます。関心のある領域のベクトルを1000個ほど取得したくても、最後に返されるベクトルが中心点から999番目か1001番目かは、まったく重要ではないかもしれません。そのため、ベクトル検索やベクトル・インデックスについて語るとき、大半の場合は、さまざまな近似最近傍(Approximate Nearest Neighbor)アルゴリズム、略してANNを指しています。一見すると、とんでもない考えに聞こえるかもしれません。データベースは、書込み時にデータを失わず、読取り時に厳密で正しい結果を返すという点で、非常に精密かつ正確であることに慣れているからです。しかし、AIのほとんどのユースケースでは、その重要性は低いのです。考えてみれば、このように情報の一部が失われる曖昧な想起は、人間の脳の働き方そのものでもあります。(AIがまねているものです。)
最後に、近似的な答えを許容する道へ進むと、多くのベクトル・インデックス実装では、インデックスに必要なメモリーを減らすために量子化も適用します。たとえば32ビット浮動小数点値を、わずか16ビットの精度でインデックス付けでき、8ビットも一般的です。ビット数を32から16に減らすと、必要なメモリーは半分になりますが、精度はほとんど損なわれず、主に最も遠い点に影響します。これらは、もともと結果セットの中で最も重要性が低い点です。同様に、インデックス付けの前にベクトルの次元数を削減することもできます。ベクトルの一部の要素が他よりはるかに重要な場合が多いため、距離の計算やベクトルのインデックス付けでは、重要性が低いとわかった次元を単に無視できます。(単純な例として、常にゼロ、あるいはゼロに近い場合などです。)
HNSW
初期から存在し、広く使われているアルゴリズムは、Hierarchical Navigable Small Worldと呼ばれます。基本的には、新しいアルゴリズムが超えるべき基準となっています。
基本的な考え方は、ベクトルをグラフに格納し、各ベクトルを最も近い近傍と辺で結ぶことです。ANN検索では、入力ベクトルに近い開始点を見つけ、そこからグラフを走査して最も近いk個の点を探します。
ただし、HNSWは単なるグラフ走査ではなく、階層化された複数のレイヤーで動作します。データセット全体から、少数のベクトル点をサンプリングします。問合せは、まずこれらのノードだけを検索して最近傍を探します。見つかると、通常のグラフ走査を開始します。ただし、この走査ではレイヤー1の他のノードと、レイヤー2のノードの両方を考慮します。まばらなレイヤー1の他のノードより、レイヤー2のノードまでの距離の方が短い可能性があります。レイヤー2のノードからも走査を続け、おそらく主に次のレイヤーへと下り、すべてのノードを含むレイヤーを見つけるまで進みます。
現実世界に例えると、近くの都市のある住所まで車で行くようなものです。まず、目的の都市に着くための適切な高速道路を選びます。次に、適切な出口から一般道へ下ります。最後に住宅地に入り、目的地に着くまでゆっくり走ります。
計算機科学で例えるなら、基本的にはグラフ版のスキップ・リストです。
HNSWは、人気のあるHNSWlibを通じて利用されることがよくあります。たとえばpgvector、Lucene、ClickHouse、DuckDBはいずれも、何らかのHNSWインデックスの実装をサポートしています。
InVerted File Index(IVF)
もう一つの主要なベクトル・インデックス方式は、InVerted File Indexと、それを基にした派生方式です。これらのアルゴリズムでは、まず通常はk-meansクラスタリングを使い、ベクトルをクラスタに分割します。なお、これはk近傍法とはまったく別のものです。実際の問合せでは、最初に入力ベクトルに最も近いクラスタを決め、そのクラスタ内のデータを処理して最も近いk個のノードを見つけます。
HNSWとIVFの大まかな比較
データ構造とアルゴリズムのレベルでHNSWとIVFの違いを理解したので、実際の実装でどのような違いが生じ、その理由が何かも考えられます。HNSWはグラフを中心とする構造なので、インデックス・スキャンで、必要な限り遠くまで、広く、かなり自由にインデックスを走査できる利点があります。
ただし、このようなグラフ走査が、すべての場合で最も効率的な方法とは限りません。また、グラフ・データ構造によくあるように、HNSWはメモリー内に収まる場合に最もよく機能する傾向があります。
一方、IVFは非常にコンパクトで単純な構造です。原点を、ベクトルが密集したn次元空間の領域へ移動します。そこから、ユーザーの問合せで定義された空間の領域を単純に走査します。たとえば、典型的なWHERE DISTANCE(point, col) < 0.7は、n次元の球を定義します。
一方でIVFの弱点は、ベクトルを実際に別々のクラスタ、すなわちパーティションに分割することです。別のIVFクラスタに一部属するデータ点を簡単に問い合わせる方法はありません。そのため、問合せ対象が、あるパーティションの境界にある空間のまばらな領域に位置する場合、IVFインデックスの問合せ結果がやや不正確になることがあります。
ScaNN
後者の方式に属する興味深いアルゴリズムが、Googleのチームが開発したScaNNです。ベクトルの量子化を最適化し、圧縮率を最大化しながら、それに伴う誤差を最小化することに焦点を当てています。報告によると、さまざまなベンチマークで最大4~8倍の高速化が示されています。
このライブラリはGoogleによってオープンソース化され、MySQLへの組込みを目指す新しいプル・リクエストの中核となっています。もちろん、組込みは厳密なレビューとベンチマークを行い、他のすべての選択肢と比較した後です。ただ、少なくとも学術文献を見る限り、その点では有望に見えます。
Vamana
最も新しく加わったのはIntelで、同社のインデックス・アルゴリズムであるVamanaを提案しています。Vamanaはグラフ型インデックスの系統なので、基本的にはIVFとScaNNを、HNSWとVamanaに比較していることになります。MySQLには、この4つのライブラリすべてが含まれるかもしれません。あるいは少なくとも、お気に入りのベクトル・インデックス・ライブラリを組み込めるAPIを提供する可能性があります。
MySQLでベクトル・インデックスを構築する
このプロジェクトのGitHub上の議論を読むと、その大部分はSQL構文の設計、数学、InnoDBの内部構造、ベンチマークが混ざり合った内容です。低レベルで感情を交えないエンジニアリングの話です。
注意して見なければ、InnoDBにベクトル・インデックスを追加するプロジェクトが、実は過去50年間に大きな注目を集めた技術の、ある種の同窓会のようなものだとは、すぐには気付かないかもしれません。最も人気のあるオープンソース・データベースMySQLにベクトル検索を組み込むため、現在このプロジェクトは、GoogleのCloud SQLチームが最近オープンソース化したScaNNライブラリを中心に進めています。そして、オラクルのInnoDBチームが、その統合とベンチマークを行っています。
Amazon(AWS)も積極的に参加しています。実際、このプロジェクトが始まるきっかけは、5月のContributor SummitでのHugo Wen氏の発表でした。そして今週のContributor Summitでは、IntelとPerconaが、それぞれ追加したいと考えているコントリビューションを発表します。
さらに、まさにオープンソースらしく、イスタンブールの一人のオープンソース・ハッカー、Alkin「セーリングをするために生まれ、データベースの仕事を余儀なくされている」Tezuysal氏が、MyVectorプラグインによって、上記のすべてに先行しています。すでに3月から本番環境で使われています。MyVectorについては後で詳しく説明します。
これは、多くの人気オープンソース・プロジェクトが規模を拡大する際に起きることの典型例です。かつてMySQLは、小さくシンプルで、必要十分なデータベースとして知られていました。今や、誰もが存在感を示したいと考え、どれが最速かを確かめるために最高のエンジンを競わせる、データベース版モナコ・グランプリになっています。つまり、このプロジェクトの開発者にとって重要な検討事項は、提供されているさまざまなライブラリに適応できるモジュール型アーキテクチャに投資し、MySQLユーザーにとって最良の選択肢を分析することです。同時に、もちろん原点を大切にし、過剰な分析や過剰な設計に陥ることなく、シンプルで使いやすいものを比較的タイムリーにリリースしたいという思いもあります。確かに、ある意味では恵まれた悩みですが、触れておく価値はあります。プロジェクトの拡大に伴うこうした課題に直面しているのは、MySQLだけではありません。
さまざまな種類のアルゴリズムをテストすることは、全体の半分にすぎません。もう一つの議論は、インデックスをどのように格納すべきかです。インデックスの対象であるメイン表にリンクしたInnoDB表(別名「サブ表」)として格納するか、それともInnoDBのセカンダリ・インデックスのページ形式を使って構築すべきか、というものです。直感的には後者の方が「正統」に思えますが、ロックや可視性のような繊細な領域で、はるかに多くの作業が必要になる可能性があります。
ユーザーの観点で最も興味深いのは、おそらくCREATE VECTOR INDEXと、そのインデックスからベクトルをSELECTするための構文について議論しているチケットです。
作業は進行中です。このプロジェクト・ボードで、参加エンジニア間の議論を追えます。
MyVectorとその他のプラグイン実装
上記のコントリビューターは、MySQLコアにネイティブなインデックス型を作成すること、より正確にはInnoDBのセカンダリ・インデックスまたはサブ表として作ることに合意していますが、MyVectorもあります。
Alkin Tezuysal氏が作成したMyVectorは、MySQLプラグインおよびユーザー定義関数です。MySQLコミュニティのすべての方から、より多くのコントリビューションを募ることに注力している今、これは非常に重要な話題です。プラグインには、MySQL組織でコミッター権限を持つ人や、さらに言えばマネージャーに許可を求めることなく、誰でも作成でき、誰でも利用できるという優れた特徴があります。サードパーティによる拡張性については、近いうちに別の記事で改めて取り上げます。
MyVectorは、まさにHNSWとIVFをサポートし、近似および厳密なkNN検索、複数の距離関数にも対応しています。また、基になるデータが変化すると、バイナリ・ログの監視を通じてインデックスの自動メンテナンスが起動されます。
MyVectorには、ネイティブ・インデックスプロジェクトに対する非常に重要な利点があります。すでに利用可能で、希望すれば今すぐダウンロードして試せることです。
InnoDBチームがInnoDBコアにネイティブなベクトル・サポートを組み込んでいるとしても、コミュニティが代替アルゴリズムを実装することを妨げるものはありません。特にHNSWのようによく知られたものなら、なおさらです。これは、プラグインとコンポーネントのフレームワークを使い、新機能でMySQLを拡張する好例です。モジュール化され、規模の拡大に対応できる方法でMySQLと開発者コミュニティを拡大することは、現在注力している主要分野であり、このシリーズの次回の記事で取り上げます。
もちろん、人気のあるオープンソース・プロジェクトに、ベクトル検索用のプラグインが一つしかないとは思わないでしょう。そのとおりです。たとえば、少なくとも他に5つはあります。
結論
MySQLコミュニティは、InnoDBにベクトル・インデックスのサポートを追加するプロジェクトのもとに、まさに結集しています。最先端の4つのアルゴリズム(ScaNN、IVF、HNSW、Vamana)が候補となり、私たちはオープンソース版の恵まれた悩みに直面しています。何らかのベンチマークや他の試験を行って最良のものを見つけ、一つの勝者を選ぶべきでしょうか。それとも、この4つすべて、さらに他のものも利用・交換できるプラガブルなAPIを作り、最終的にはどれを好むかをユーザーに教えてもらうべきでしょうか。ハイブリッド検索をどこまで高度にしたいのでしょうか。これらの問いへの答えや、その他の情報について、このブログを引き続きご覧ください。
次回はMySQLコンポーネント・フレームワークについて説明し、MySQL Coreサーバーの拡張性に関する議論や考えを、より幅広く共有します。