IMPORTANTE: Este artigo serve como um guia inicial para a implantação do seu cluster OCI Search with OpenSearch, não consistindo em uma recomendação oficial ou definitiva para o serviço. Cada caso de uso deve ser avaliado individualmente. Recomendamos fortemente que, antes de mover seu ambiente para produção, sejam executados rigorosos testes de estresse e validação para confirmar se o dimensionamento atual suporta a demanda esperada.
Disco disponível não garante capacidade de busca. Um cluster pode comportar o próximo terabyte e não sustentar as consultas adicionais dentro do orçamento de latência. Também pode absorver a ingestão média e acumular horas de atraso quando precisa recuperar um nó.
Dimensionar exige relacionar volume, trabalho por consulta, concorrência, atualizações e recuperação. O projeto precisa funcionar durante picos e operações transitórias, não somente com todos os recursos disponíveis.
Este artigo utiliza dois cenários: observabilidade com ingestão contínua e catálogo de e-commerce sensível à latência. Os objetivos e configurações numéricas são exemplos de planejamento, não resultados de um teste executado aqui.
1. Arquitetura: separe responsabilidades
OCI Search with OpenSearch administra a infraestrutura e disponibiliza operações gerenciadas de aplicação de patches, atualização de versão, redimensionamento e backup. O cliente continua responsável pelos documentos, mappings, consultas, retenção, permissões e critérios de aceitação. A manutenção do serviço não substitui a gestão dos dados da aplicação.
A tabela apresenta os papéis de nós documentados para o serviço até a data de publicação deste artigo. Os exemplos de APIs deste artigo utilizam o OpenSearch 3.6 como referência.
| Papel | Trabalho principal | Critério de dimensionamento |
|---|---|---|
| Leader / cluster manager | Eleição, estado do cluster e alocação de shards. | Estabilidade do plano de controle; índices, campos, shards e alterações de estado. |
| Data | Armazenamento, indexação, busca e agregações nos shards. | CPU, heap, memória fora do heap, disco e recuperação. |
| Coordinator | Distribui requisições e combina resultados. | Concorrência, fan-out, agregações e tamanho das respostas. |
| Search | Atendimento de searchable snapshots com cache local. | Conjunto histórico consultado, cache e acesso ao Object Storage. |
| ML | Tarefas de modelos por meio do ML Commons. | Modelo, inferência, concorrência e recursos necessários à execução. |
| Dashboards | Interface de consulta e visualização. | Usuários simultâneos e disponibilidade da interface. |
Coordenadores não substituem data nodes; search nodes não são sinônimos de coordenadores. Nos searchable snapshots, o armazenamento remoto e o cache local introduzem um caminho de consulta distinto.
Uma arquitetura lógica de ingestão e consulta de referência é:
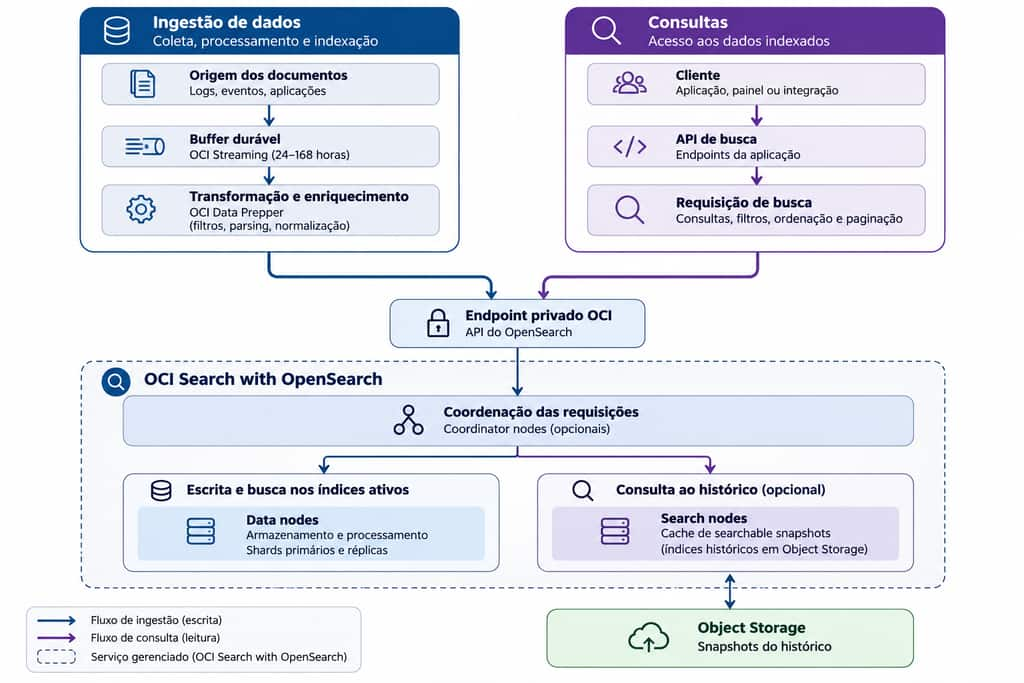
Plano de controle: leader nodes mantêm estado e alocação do cluster; não são uma etapa obrigatória de passagem das consultas.
ML nodes: processamento de modelos, quando adotado; separados do caminho básico de indexação e busca textual.
O desenho separa o caminho de escrita do caminho de consulta. Na escrita, a origem produz os documentos, o buffer durável absorve variações de chegada e o processamento prepara os dados antes da indexação. Na consulta, a API encaminha a pesquisa ao endpoint do cluster; a coordenação distribui o trabalho aos shards necessários e reúne os resultados. O buffer e a transformação representam componentes da arquitetura proposta, não etapas obrigatórias de toda implantação.
A coordenação é uma função do processamento das requisições; os coordinator nodes dedicados são uma opção para isolá-la dos data nodes. Os leaders mantêm o plano de controle, enquanto search nodes e ML nodes acrescentam caminhos específicos quando a solução utiliza searchable snapshots ou processamento de modelos.
Os leader nodes mantêm as decisões que afetam o cluster como um todo, como a composição do cluster e a alocação dos shards. Entre os nós elegíveis a líder, um é eleito para conduzir essas mudanças. Essa responsabilidade pertence ao plano de controle e é diferente de executar a busca nos dados ou combinar os resultados de uma consulta.
A topologia proposta utiliza três nós elegíveis a líder. Com os três na configuração de votação, são necessários dois votos para formar quórum, isto é, a maioria que permite eleger o líder e confirmar mudanças no estado do cluster. Se um desses nós falhar, os outros dois ainda podem formar essa maioria. Em uma separação de rede que produza grupos de dois nós e de um nó, apenas o grupo com dois poderá confirmar essas decisões.
Esse mecanismo evita o split-brain: dois grupos assumirem, ao mesmo tempo, o controle do mesmo cluster. A continuidade das consultas depende também da disponibilidade dos shards e da capacidade dos data nodes.
Uma réplica oferece outra cópia do shard, mas a proteção depende de onde cada cópia está. Na OCI, um Availability Domain (AD) corresponde a um ou mais data centers isolados de outros ADs da região. Um Fault Domain (FD) é um agrupamento de hardware e infraestrutura dentro de um AD. Distribuir recursos entre esses domínios reduz a exposição a uma mesma falha localizada.
Considere um exemplo com o primário de um shard no FD-1 e sua réplica no FD-2. Se o FD-1 ficar indisponível, a cópia no FD-2 poderá sustentar a recuperação desse shard, desde que permaneça íntegra e acessível. Se ambas as cópias dependessem do mesmo domínio afetado, estarem em máquinas diferentes não seria proteção suficiente. O exemplo ilustra a fronteira de falha; não representa uma alocação manual exigida do cliente.
O serviço utiliza a localização dos nós em Availability Domains e Fault Domains para orientar a distribuição dos shards. Com a configuração de awareness habilitada, o OpenSearch procura manter primário e réplicas em domínios diferentes, sempre que a capacidade permitir. Essa distribuição é best-effort: depende de nós saudáveis, réplicas, domínios distintos e espaço disponível. Por isso, o teste de resiliência deve verificar a alocação efetiva, não apenas a existência de réplicas.
Para os cálculos deste artigo, assumimos seis data nodes distribuídos em três domínios, com dois nós em cada um, e três leaders em domínios separados. Em uma região com um único AD, o evento considerado é a perda de um FD; em uma região com três ADs e distribuição equivalente, é a perda de um AD. Essa premissa precisa ser confirmada na implantação.
Separe a preparação dos dados da indexação
Antes de indexar um documento, pode ser necessário interpretar uma mensagem de log, normalizar datas, converter tipos ou enriquecer campos. Esse processamento prepara o documento que chegará ao índice; ele não substitui o trabalho de armazenamento e indexação dos data nodes. No OCI Search with OpenSearch, OpenSearch Pipelines com Data Prepper oferece uma camada para executar essas transformações, com suporte documentado a clusters 2.x ou posteriores no realm OC1.
Neste desenho, o Data Prepper prepara os documentos, enquanto os data nodes executam a indexação. Essa separação permite medir a capacidade de indexação independentemente: quando o parsing limita a vazão, ampliar apenas os data nodes não resolve o gargalo.
Para absorver picos e interrupções, a arquitetura proposta utiliza o OCI Streaming antes do Data Prepper. O Streaming mantém os eventos persistidos e disponíveis para releitura durante a retenção configurada, enquanto o Data Prepper os consome, transforma e encaminha ao OpenSearch. A retenção deve cobrir a interrupção prevista e o tempo necessário para processar o atraso acumulado. Esse armazenamento persistente não deve ser confundido com o buffer padrão em memória do Data Prepper.
No OCI Streaming utilizado neste desenho, a retenção configurável é de 24 a 168 horas, com padrão de 24 horas. O processamento deve ocorrer antes que os eventos expirem. Ao escolher a retenção, considere o atraso já existente, a duração da interrupção e o tempo de drenagem após a retomada. Se esse período puder ultrapassar a retenção disponível, planeje outra fonte persistente para reprocessamento; o Streaming, isoladamente, não cobre essa janela.
2. Defina qual será o contrato de desempenho
Escolher nós antes de definir o comportamento esperado da aplicação deixa o dimensionamento sem critério de aprovação. Para este projeto, o contrato de desempenho reúne os objetivos de serviço (SLOs): qual carga será atendida, em quanto tempo, com qual atualização dos dados e sob qual condição de falha. Ele funciona como a referência comum para comparar configurações e decidir se um ganho de desempenho justifica seu custo.
As métricas descrevem aspectos diferentes da experiência. A meta de 1.000 consultas por segundo representa a vazão pretendida no catálogo. O p95 de 200 ms significa que pelo menos 95% das requisições da amostra definida devem terminar nesse prazo; o p99 indica o tempo dentro do qual aproximadamente 99% das requisições observadas foram concluídas. Ao compará-los com a mediana, é possível identificar diferenças entre o comportamento típico e os tempos próximos do extremo lento da distribuição. Esses percentis precisam ser avaliados junto da taxa de erros e da carga realmente atendida, não apenas sobre um conjunto reduzido de respostas rápidas.
Já o prazo de visibilidade mede outra jornada: desde a alteração na origem até ela aparecer em uma busca. Ele inclui espera no buffer, transformação, envio, indexação e refresh. Por isso, uma pesquisa que responde rapidamente ainda pode apresentar dados atrasados. A tabela separa esses objetivos para que a arquitetura seja avaliada tanto pela rapidez das respostas quanto pela atualização do conteúdo.
Os seguintes valores são objetivos ilustrativos do projeto, não SLAs da OCI:
| Requisito | Observabilidade | Catálogo |
|---|---|---|
| Dados | 100 GiB/dia; 30 dias de retenção ativa | 240 GiB primários indexados |
| Escrita | Contínua; pico de taxa de entrada de até 5× a média, com duração e frequência definidas no ensaio | Atualizações incrementais e reconstrução periódica |
| Busca | Filtros temporais e agregações predefinidas | Texto, filtros e facetas; 1.000 consultas/s no pico |
| Latência | p95 até 3 s nas consultas operacionais selecionadas | p95 até 200 ms; p99 até 500 ms |
| Visibilidade | 99% dos eventos pesquisáveis em até 60 s | 99% das alterações pesquisáveis em até 5 s |
| Falha planejada | Perda de um dos três domínios utilizados no exemplo, tornando indisponíveis dois dos seis data nodes | Mesmo evento, com capacidade sobrevivente para o tráfego definido |
Especifique também a janela permitida de degradação, taxa de erros e tempo para recompor a redundância. Sem esses valores, não existe critério completo para aprovar o teste de falha.
Colete distribuição do tamanho dos documentos, cardinalidade dos campos, consultas mais frequentes, atualizações e exclusões. Caracterize também a carga de pesquisa: quantas consultas precisam ser atendidas simultaneamente, quais períodos dos logs elas abrangem e quais filtros e agregações executam. Receber 100GB de logs por dia descreve o volume de ingestão, mas não determina, sozinho, a CPU necessária para pesquisar os dados armazenados.
Nos cálculos de dados abaixo, GiB e TiB são unidades binárias. Nas tabelas de recursos e preços, GB preserva a unidade publicada pela OCI. Reconcilie valores em bytes antes de converter capacidade lógica em recursos e unidades faturáveis.
3. Mapping e consultas fazem parte do sizing
O mapping é o contrato que define como cada campo do documento será interpretado e indexado. Isso influencia quais operações a busca consegue executar e quais estruturas precisam ser mantidas para atendê-las. Portanto, o tamanho do JSON recebido não basta para estimar o custo do índice: a mesma informação, modelada de maneiras diferentes, pode exigir trabalho diferente de armazenamento, indexação e consulta.
Modele para as operações necessárias
Um mapping controlado evita que cada atributo recebido crie estruturas pesquisáveis sem necessidade. O limite upstream de index.mapping.total_fields.limit é 1.000 campos; aumentá-lo não corrige um esquema sem controle. Use contrato explícito no catálogo e templates controlados nos logs.
No catálogo do exemplo, título e descrição precisam de busca por palavras e recebem o tipo text. SKU e categoria representam valores exatos e usam keyword. Preço, disponibilidade e data têm tipos próprios porque serão comparados ou filtrados conforme sua semântica, não como linguagem natural. A configuração dynamic: strict transforma campos inesperados em erros explícitos de indexação; o pipeline precisa tratar esses erros, em vez de repetir indefinidamente o mesmo documento.
O exemplo utiliza os 12 shards primários calculados adiante. O refresh de um segundo é um ponto de partida para o objetivo de visibilidade de cinco segundos, não uma garantia ponta a ponta.
PUT /catalogo-v1
{
  "settings": {
    "number_of_shards": 12,
    "number_of_replicas": 1,
    "refresh_interval": "1s"
  },
  "mappings": {
    "dynamic": "strict",
    "properties": {
      "sku": { "type": "keyword" },
      "titulo": { "type": "text", "analyzer": "brazilian" },
      "descricao": { "type": "text", "analyzer": "brazilian" },
      "categoria": { "type": "keyword" },
      "preco_centavos": { "type": "long" },
      "disponivel": { "type": "boolean" },
      "atualizado_em": { "type": "date" }
    }
  }
}
Teste o analisador brazilian com _analyze e termos reais, incluindo marcas e siglas. SKU deve permanecer exato. O analisador oferece normalização linguística, mas a adequação ao domínio precisa ser avaliada.
Para oferecer opções de refinamento da busca, como marca e categoria, acompanhadas da quantidade de resultados de cada opção — recurso conhecido como facetas —, utilize campos keyword para esses atributos. Isso permite agrupar pelos valores completos, em vez de pelos termos produzidos pela análise textual. Evite habilitar fielddata em campos text apenas para realizar essas agregações, pois essa estrutura pode consumir uma parcela significativa do heap. Para refinamentos por faixa de preço ou período, mantenha os campos numéricos ou de data e utilize as agregações correspondentes.
Use nested quando um documento contiver uma lista de objetos e a busca precisar combinar atributos de um mesmo elemento dessa lista. Por exemplo, uma camiseta pode ter uma variante azul/P e outra vermelha/G. Uma consulta por azul/G não deve retornar esse produto, pois essa combinação não existe. Ao mapear as variantes como nested e consultar cor e tamanho dentro da mesma consulta nested, o OpenSearch verifica os dois critérios em cada variante, sem misturar seus atributos. Essa precisão tem custo; cada variante é indexada como um documento interno separado. Por isso, a escolha deve ser justificada pelas consultas que a aplicação precisa executar.
Reduza trabalho sem degradar a relevância
Uma busca de catálogo precisa distinguir condições obrigatórias de critérios de relevância. Ao pesquisar “notebook para desenvolvimento”, categoria e disponibilidade determinam quais produtos podem aparecer; a correspondência no título e na descrição ajuda a definir sua ordem. Um produto indisponível deve ser excluído, mesmo que seu título corresponda perfeitamente à busca, logo estar disponível e ser da categoria notebook não entram em relevância e sim em filtros obrigatórios.
POST /catalogo-v1/_search
{
  "size": 20,
  "query": {
    "bool": {
      "must": {
        "multi_match": {
          "query": "notebook para desenvolvimento",
          "fields": ["titulo^3", "descricao"]
        }
      },
      "filter": [
        { "term": { "categoria": "notebooks" } },
        { "term": { "disponivel": true } }
      ]
    }
  }
}
O documento precisa atender aos dois filtros e à consulta textual em must. bool.filter verifica as restrições sem acrescentar pontos ao _score, a pontuação usada para ordenar os resultados por relevância. Assim, não se calcula relevância para condições que exigem apenas “sim” ou “não”.
O multi_match pesquisa título e descrição. titulo^3 dá mais peso à correspondência no título, mas não garante que qualquer resultado com uma palavra nesse campo apareça primeiro. A consulta também não exige a frase exata. size:20 limita a resposta a até 20 documentos, não o trabalho total da busca.
Paginação e avaliação
Para percorrer muitas páginas, avalie search_after em vez de aumentar indefinidamente o deslocamento de from/size. Ele continua a partir do último resultado recebido. Associado a Point in Time – PIT, mantém a mesma visão dos dados durante a navegação. Utilize ordenação com desempate estável e encerre o contexto quando não for mais necessário.
O peso três é uma hipótese: compare configurações usando consultas reais e produtos classificados quanto à relevância. A Ranking Evaluation API permite avaliar essa ordenação. Uma consulta mais rápida só representa uma melhoria se também preservar a qualidade dos resultados.
4. Dimensione recursos no estado normal e no estado degradado
4.1 Meça o volume primário antes de multiplicar cópias
O dimensionamento de armazenamento precisa responder a duas perguntas: quanto espaço os dados ocuparão com suas réplicas e quanta capacidade deve permanecer disponível após uma falha. Esses valores são diferentes: os dados podem caber com todos os nós funcionando e deixar de caber, com a margem necessária, quando parte do cluster fica indisponível.
Primeiro, meça o espaço ocupado pelos dados indexados
O tamanho dos documentos na origem não é necessariamente igual ao espaço utilizado no OpenSearch. O mapping determina quais estruturas serão criadas para os campos, enquanto o codec influencia a compressão. Por isso, indexe uma amostra representativa com as configurações pretendidas antes de estimar o armazenamento de todo o período de retenção.
Nessa medição, considere apenas o armazenamento primário: a soma do espaço dos shards primários, sem suas réplicas. Na CAT Indices API, pri.store.size apresenta esse valor; store.size inclui também as réplicas existentes. Usar o total nessa etapa e depois multiplicá-lo novamente pelas réplicas contaria as mesmas cópias duas vezes.
O fator de indexação relaciona o tamanho obtido ao tamanho da amostra na origem:
k_indexacao = armazenamento_primario / tamanho_dos_dados_na_origemPor exemplo, se uma amostra de 10 GiB ocupar 12 GiB nos shards primários, o fator será 12 / 10 = 1,2. Nesse caso, cada GiB recebido corresponde a aproximadamente 1,2 GiB de armazenamento primário
O guia da Oracle utiliza, como hipótese inicial, redução de 25% a 40% por compressão e contabiliza separadamente o overhead de indexação. Neste artigo, k_indexacao reúne o efeito líquido dessas duas parcelas: armazenamento primário dividido pelo volume recebido. Na decomposição do guia, essa relação corresponde aproximadamente a (1 + overhead_de_indexacao) / razao_de_compressao. O valor 1,2 é uma hipótese didática mais conservadora que a redução descrita no guia, não uma garantia de limite superior. Substitua-o pela medição da amostra, sem aplicar novamente os mesmos fatores de compressão e indexação.
Depois, acrescente as réplicas
Para logs, estime o volume primário multiplicando a entrada diária pelo período de retenção e pelo fator de indexação:
D_primario = entrada_diaria x dias_retidos x k_indexacao
D_copias   = D_primario x (1 + replicas)
Com entrada de 100GB/dia, retenção de 30 dias e fator assumido de 1,2:
D_primario = 100 x 30 x 1,2 = 3.600 GiBUma réplica significa uma cópia adicional de cada shard primário, distribuída em outro nó – não um único nó contendo uma cópia completa do cluster. Assim, o planejamento passa a considerar duas cópias de cada parte dos dados.
D_copias = 3.600 x (1 + 1) = 7.200 GiBOs 7.200 GiB representam o espaço estimado dos dados com a redundância escolhida. Ainda não representam toda a capacidade que deve ser provisionada.
Reserve capacidade para operar após uma falha
Considere seis data nodes com a mesma capacidade de disco. O cenário exige suportar a perda de dois deles e recompor as cópias nos quatro sobreviventes, sem ultrapassar 75% de ocupação.
Isso estabelece duas condições: após a falha, restam dois terços da capacidade inicial; dessa capacidade sobrevivente, apenas 75% devem estar ocupados. Os 75% são uma meta deste projeto, não um padrão obrigatório do serviço.
O modelo de planejamento é:
C_total >= (D_copias + D_transitorio) / [u x (1 -f )] Para entender a divisão, faça a conta em duas etapas:
Capacidade necessária após a falha:
7.200 / 0,75 = 9.600 GiB

Capacidade inicial para que sobrem 9.600 GiB após perder um terço:
9.600 / (2/3) = 14.400 GiB
Portanto, com u = 0,75, f = 1/3 e D_transitorio = 0:
C_total >= 7.200 / [0,75 X (1 – 1/3)]
C_total >= 14.400 GiB
Os dados não passaram a ocupar 14.400 GiB. Continuam ocupando aproxidamente 7.200 GiB com uma réplica. A capacidade adicional permite suportar a perda dos nós e preservar a margem escolhida.
D_transitorio = 0 serve apenas para obter esse piso. O dimensionamento definitivo precisa estimar as necessidades transitórias, considerando a capacidade útil disponível, não apenas o tamanho nominal dos volumes.
Compare a operação normal com a capacidade sobrevivente.
A tabela mostra duas configurações possíveis, utilizando 1 TiB = 1.024 GiB. Nesta comparação, os valores de 2 TiB e 3 TiB representam capacidade útil considerada no modelo, após reconciliar as reservas do ambiente. Não correspondem automaticamente ao valor nominal a informar no provisionamento. As porcentagens da tabela só permanecem válidas quando a capacidade útil real atende a esses valores.
| Configuração | Ocupação normal | Ocupação após perder dois nós e recompor as cópias |
|---|---|---|
| 6 × 2 TiB | 58,6% | 87,9% |
| 6 × 3 TiB | 39,1% | 58,6% |
Na primeira configuração, os seis nós oferecem 12.288 GiB. Com dois indisponíveis, restam 8.192 GiB; acomodar novamente os 7.200 GiB nesse espaço resultaria em 87,9% de ocupação, acima da meta de 75%.
Essa é a ocupação projetada após recompor as cópias, não necessariamente a observada imediatamente após a falha. O modelo pressupõe que sobreviveu uma cópia utilizável de cada shard e que as regras de alocação permitem a reconstrução nos nós restantes.
Espaço livre não significa alocação permitida
O OpenSearch utiliza watermarks, patamares de ocupação de disco que acionam proteções por nó. Na documentação upstream 3.6, os padrões são:
| Nível | Ação de proteção |
|---|---|
| Low – 85% | Restringe novas alocações de shards no nó, com exceção documentada para primários de índices recém-criados. |
| High – 90% | Faz o cluster tentar mover shards para outros nós. |
| Flood stage – 95% | Aplica bloqueio de escrita aos índices afetados para evitar o esgotamento de disco. |
Na configuração de seis nós de 2 TiB, a ocupação média projetada de 87,9% já supera o low watermark padrão. Assim, a recomposição pode encontrar restrições antes de alcançar a distribuição calculada, mesmo havendo espaço bruto livre. Com seis nós de 3 TiB, os 58,6% projetados deixam mais margem.
A média, porém, não substitui a verificação do nó mais ocupado e das regras de alocação. A conta demonstra uma condição de espaço; não garante que todos os shards serão alocados nem determina quanto tempo a recuperação levará.
4.2 Tamanho e quantidade de shards
Um índice é dividido em shards primários, cada um responsável por uma parcela dos documentos. Uma réplica mantém outra cópia dessa parcela; ela não cria uma partição nova do conjunto lógico. O data node é o recurso que hospeda essas cópias e executa operações sobre elas. Essa distinção evita confundir quantidade de máquinas, quantidade de partições e quantidade de cópias armazenadas.
A escolha equilibra granularidade e custo de distribuição. Shards menores permitem dividir os dados em mais unidades de alocação e recuperação, mas aumentar sua quantidade também amplia o trabalho de manter e consultar essas unidades. Shards maiores reduzem a quantidade de partições, porém exigem transferir mais bytes quando precisam ser movidos ou recuperados. Por isso, o tamanho-alvo deve ser relacionado tanto ao padrão das consultas quanto ao tempo de recuperação pretendido.
O guia da Oracle propõe 10–30 GB por shard para leitura predominante, 30–50 GB para escrita predominante e até 25 shards por GB de heap como verificação de densidade. São heurísticas, não um limite físico de 50 GB ou uma promessa de latência.
Primarios = arredondar_para_cima(D_primario_do_indice / tamanho_alvo)
Copias    = Primarios x (1 + replicas)
O catálogo de 240 GiB, com alvo de 20 GiB, resulta em 12 primários e 24 cópias. Nos logs, aproximadamente 120 GiB primários por dia podem começar com três primários por geração. Trinta gerações, com uma réplica, resultariam em cerca de 180 cópias, antes dos índices de sistema e margens de retenção.
As aproximadamente trinta gerações correspondem ao volume nominal do exemplo, não a uma contagem fixa imposta pelo calendário. O rollover pode antecipar a criação de novas gerações quando um primário alcança o limiar de tamanho. O número efetivo depende do volume, da distribuição entre shards e da avaliação da política.
A verificação de densidade é diferente do dimensionamento de execução. Com heap de 32 GB, a regra de 25 shards por GB resulta em 800 cópias de shards por nó como referência de densidade, não como uma meta de ocupação. Um nó pode atingir seu limite de CPU ou latência com muito menos shards, dependendo do trabalho que recebe. Já cluster.max_shards_per_node=1000 participa de uma proteção global proporcional à quantidade de data nodes não congelados.
Diferencie shards armazenados de shards alcançados por consulta. Uma busca ampla no catálogo pode consultar uma cópia de cada um dos doze primários lógicos. Mais réplicas oferecem alternativas de atendimento concorrente, mas não dividem automaticamente esse fan-out.
No exemplo de logs, consultas frequentes a todo o período podem ativar muitos shards. Nesse caso, os quatro OCPUs por data node da configuração inicial precisam ser reavaliados. Igualmente, adicionar nós não altera o número de primários de um índice existente; aumentar particionamento exige uma estratégia própria, como reindexação.
4.3 Heap não é toda a memória
A referência geral da Oracle é aproximadamente 50% da RAM para heap, normalmente até 32 GB, com 64 GB de RAM por data node. Para grande parte dos casos de uso, 64 GB de memória por data node é o “teto” recomendado. No entanto, 64 GB não é um limite rígido do serviço.
RAM adicional pode favorecer cache e estruturas fora do heap sem exigir aumento proporcional da JVM. Observe memória após GC, tempo de coleta, breakers, buffers e recursos nativos. A Nodes Stats API expõe métricas da JVM e dos pools de memória. Não deduza o heap efetivo apenas da RAM contratada.
A referência próxima de 32 GB também se relaciona ao uso de compressed oops, uma representação compacta das referências a objetos na JVM. Não conclua apenas pelo tamanho nominal da RAM que esse mecanismo está ativo ou desativado. Consulte a configuração efetiva:
GET /_nodes/jvmVerifique jvm.mem.heap_max_in_bytes e jvm.using_compressed_ordinary_object_pointers. O primeiro informa o heap máximo reportado; o segundo indica o uso das referências comprimidas, quando essa informação estiver disponível.
Para o catálogo deste artigo, 64 GB por data node é o ponto de partida do ensaio. A comparação com mais memória deve responder a uma hipótese específica: o recurso adicional reduz a pressão de memória ou melhora o comportamento da busca sob a mesma carga? Compare p95/p99, GC, rejeições e leituras de disco sem alterar simultaneamente as demais variáveis. Assim, a decisão de aumentar memória fica vinculada a um resultado observável, e não à suposição de que mais RAM produzirá, por si só, a latência desejada.
4.4 CPU, QPS e concorrência
QPS indica quantas consultas são processadas por segundo; latência é o tempo que uma consulta leva para terminar; concorrência é a quantidade de consultas em andamento, incluindo as que aguardam execução. Essas medidas estão relacionadas, mas não são intercambiáveis.
A lei de Little relaciona suas médias em regime estável: L = λ x W. Com 1.000 consultas/s e latência média de 120 ms, existem aproximadamente 120 consultas em andamento. Isso não significa que sejam necessárias 120 CPUs: parte dessas consultas pode estar esperando dados, comunicação entre nós ou uma oportunidade de execução. A relação utiliza a média, não o p99.
Como verificação inicial, o guia da Oracle recomenda partir de pelo menos uma vCPU por shard ativo e apresenta a aproximação de duas vCPUs e 8 GB de memória por 100 GB de armazenamento requerido. Essas heurísticas ajudam a selecionar candidatos ao teste; não descrevem, sozinhas, a complexidade das consultas nem sua concorrência. O modelo a seguir acrescenta a demanda de CPU por consulta, mas só se torna uma estimativa empírica quando alimentado por medições representativas.
Segundos de CPU medem processamento
Para dimensionar CPU, precisamos saber quanto processamento cada consulta consome. Essa quantidade pode ser expressa em segundos de CPU, que somam o tempo de execução utilizado pelos processos e suas threads. É diferente do tempo decorrido no relógio.
Por exemplo, na contabilidade de tempo de CPU:
Uma vCPU executando trabalho durante 10 segundos:
1 x 10 = 10 segundos de CPU

Quatro vCPUs executando trabalho durante os mesmos 10 segundos:
4 x 10 = 40 segundos de CPU
No segundo caso, passaram apenas 10 segundos no relógio, mas foram consumidos 40 segundos de CPU, somados entre os quatro processadores lógicos. O mesmo raciocínio permite somar o processamento de uma consulta distribuída entre diferentes data nodes.
Considere agora um ensaio hipotético em que 10.000 consultas acrescentem 400 segundos de CPU ao consumo agregado dos data nodes, depois de descontado o trabalho que já ocorreria sem elas:
d_cpu = processamento atribuído às consultas / quantidade de consultas

d_cpu = 400 / 10.000
d_cpu = 0,040 segundo de CPU por consulta
Cada consulta consumiu, em média, 40 milissegundos de processamento. Isso não significa que respondeu em 40 ms: sua latência também inclui esperas, enquanto parte do processamento pode ocorrer em paralelo.
Para estimar esse consumo, a Nodes Stats API oferece process.cpu.total_in_millis, um contador acumulado do tempo de CPU do processo. Compare a variação entre o início e o fim do teste, somando os data nodes. O contador não separa automaticamente busca de outras atividades; essa separação exige ensaios controlados.
A CPU dos data nodes não atende somente às buscas.
Enquanto responde às consultas, o cluster pode continuar recebendo documentos, atualizando índices e recuperando sua redundância. O dimensionamento precisa considerar o processamento dessas atividades, não atribuir toda a capacidade às pesquisas. Os pools e as estatísticas do OpenSearch distinguem operações de escrita, manutenção de índices, recuperação e gerenciamento da JVM.
| Atividade | Trabalho que precisa ser considerado |
|---|---|
| Indexação, atualizações e exclusões | Processar documentos e modificar as estruturas do índice. |
| Refresh e merges | Disponibilizar alterações para busca e combinar segmentos do índice. |
| Garbage collection – GC | Recuperar memória da JVM que deixou de ser utilizada |
| Recuperação de shards | Reconstruir cópias e processar dados necessários à recuperação, além do consumo de rede e disco |
Essas atividades aparecem nas estatísticas de índices e JVM; merges, por exemplo, também representam trabalho de CPU e I/O associado à indexação.
No modelo, b representa o orçamento de CPU para essas outras atividades, somado nos data nodes e expresso em segundos de CPU por segundo de relógio. Assumir b = 9,6 significa destinar 9,6 segundos de processamento agregado a essas operações a cada segundo – não acrescentar 9,6 segundos à latência de cada consulta.
O valor b = 9,6 foi escolhido apenas para demonstrar a conta; não foi medido neste ambiente. Mantê-lo igual nas duas alternativas representa a hipótese de mesma demanda agregada das atividades de fundo, não de mesmo percentual reservado. Ele corresponde a 25% do orçamento de CPU da primeira alternativa e a aproximadamente 16,7% da segunda. Em um dimensionamento real, reestime esse consumo para cada cenário, especialmente durante recuperação.
Essa é uma parcela do planejamento, não uma reserva de CPUs dedicadas configurada no serviço. Seu valor deve refletir o cenário avaliado: durante uma recuperação, o trabalho adicional pode ser maior. Também é necessário evitar dupla contagem: o processamento já atribuído às buscas em d_cpu não deve ser descontado novamente em b.
Segundos de CPU medem processamento
O modelo inicial permanece:
QPS_cpu <= (n x v x u_cpu – b) / d_cpun é o número de data nodes disponíveis; v, a quantidade de processadores lógicos por nó; e u_cpu, a utilização máxima adotada no planejamento. Depois de aplicar esse limite, descontamos o orçamento b e dividimos o processamento restante pelo consumo médio de cada consulta.
u_cpu e b têm funções diferentes. Planejar utilização de 60% deixa uma margem de 40% para variações. Dentro dos 60% planejados, uma parte atende às buscas e outra às demais atividades. Não devemos considerar todo esse orçamento como disponível para consultas.
Para o exemplo, mantemos as hipóteses:
d_cpu = 0,040 segundo de CPU por consulta
u_cpu = 60%
b = 9,6 segundos de CPU por segundo
Em shapes x86 da OCI, uma OCPU corresponde a duas vCPUs. Como são threads de um núcleo físico, essa equivalência não deve ser interpretada como garantia de ganho linear de desempenho. A demanda por consulta precisa ser medida no hardware e nas condições de concorrência pretendidos.
Com quatro nós sobreviventes de oito OCPUs, a conta fica:
Processadores lógicos disponíveis:
4 x 16 = 64

Orçamento dentro da utilização-alvo:
64 x 0,60 = 38,4 segundos de CPU por segundo

Parcela disponível para buscas:
38,4 – 9,6 =  28,8 segundos de CPU por segundo

Limite estimado pela restrição de CPU:
28,8 / 0,040 = 720 consultas/s
Aplicando as mesmas hipóteses à segunda configuração:
| Capacidade sobrevivente | Conta | Limite estimado por CPU |
|---|---|---|
| 4 nós x 8 OCPUs | (4 × 16 × 0,60 – 9,6) / 0,040 | 720 consultas/s |
| 4 nós x 12 OCPUs | (4 × 24 × 0,60 – 9,6) / 0,040 | 1.200 consultas/s |
A primeira alternativa não atende ao objetivo de 1.000 consultas/s dentro desse modelo. A segunda passa pela verificação de CPU, mas não comprova a meta de latência p99. A conta pressupõe a demanda por consulta e o orçamento de outras atividades informados; ambos precisam ser validados, inclusive no estado degredado.
O modelo cobre CPU dos data nodes, não toda a aplicação. Coordenação, rede, armazenamento e concentração de trabalho em poucos shards continuam sujeitos a avaliação própria.
4.5 IOPS e throughput de storage
O storage precisa atender a três necessidades: guardar o volume de dados, executar operações de leitura e escrita e transferir bytes na velocidade exigida pela carga. Capacidade é medida em bytes; IOPS é a quantidade de operações de I/O por segundo; throughput é o volume transferido por segundo. Operações pequenas podem pressionar o limite de IOPS antes de atingir o máximo de transferência, enquanto operações maiores podem atingir o limite de throughput com menos IOPS.
No OpenSearch, o mesmo recurso atende à indexação, às leituras e às operações de manutenção. Os merges combinam segmentos do índice, e a recuperação transfere dados para recompor cópias. Essas atividades podem disputar I/O com a aplicação. Por isso, possuir espaço livre não comprova que a camada de armazenamento sustentará a carga, e documentos por segundo não se convertem diretamente em operações de disco.
Como referência do produto Block Volume, o nível Balanced publica 60 IOPS/GB até 25.000 IOPS e throughput de até 480 MB/s por volume. Os máximos dependem do tamanho de I/O:
| Volume Balanced | Máximo de IOPS, I/O de 4 KB | Máximo de throughput, I/O de 1 MB |
|---|---|---|
| 100 GB | 6.000 | 48 MB/s |
| 500 GB | 25.000 | 240 MB/s |
| 1 TB | 25.000 | 480 MB/s |
A tabela descreve características do produto OCI Block Volume no nível Balanced, não se limitando a apenas essa possibilidade de nível. Seus máximos utilizam tamanhos de operação distintos: não representam, necessariamente, IOPS e throughput máximos atingidos ao mesmo tempo. Também não constituem uma especificação de desempenho entregue por data node do OCI Search with OpenSearch.
No dimensionamento do cluster, a decisão deve partir da vazão efetivamente observada durante busca, ingestão e recuperação. Se a latência piorar apenas durante merges ou cópia de shards, investigue a disputa de I/O antes de atribuir o problema à CPU. Um aumento de armazenamento só deve ser considerado solução para desempenho quando o comportamento da configuração do serviço e o ensaio confirmarem esse benefício.
5. Topologias candidatas e critérios de custo
As topologias abaixo reúnem as restrições calculadas nas seções anteriores. A quantidade de nós precisa ser suficiente para distribuir os dados e preservar capacidade após a falha escolhida; os recursos de cada nó precisam suportar o trabalho que permanecerá nele. A tabela é o ponto de partida para o exemplo desse artigo, não uma lista de tamanhos obrigatórios para utilizar o serviço e nem referência obrigatória. Cada caso de uso precisa ser avaliado. Os cálculos apresentados no artigo são um ponto de partida e devem ser validados por meio de testes de carga que reproduzam as condições reais da aplicação.
Os dois exemplos abaixo utilizam E5 Flex como referência de plataforma. Seis data nodes refletem o cenário de falha escolhido; não são um mínimo para novos clientes. Configurações menores devem passar pelo mesmo processo com seus próprios objetivos.
Na observabilidade, o armazenamento foi ampliado para acomodar retenção e recomposição das cópias nos sobreviventes. Os quatro OCPUs por data node no cenário de observabilidade são uma hipótese de ensaio. Como essa escolha fica abaixo da estimativa proporcional ao armazenamento sugerida pelo guia, sua adoção exige evidência de que ingestão, consultas sobre o histórico e recuperação atendem às metas. Sem essa medição, a tabela não deve ser usada como recomendação de capacidade para produção.
| Componente | Observabilidade | Catálogo |
|---|---|---|
| Leaders | 3 x 2 OCPUs / 32 GB | 3 x 2 OCPUs / 32 GB |
| Data nodes | 6 x 4 OCPUs / 64 GB | 6 x 12 OCPUs / 64 GB |
| Capacidade útil-alvo por data node, usada nas contas | 3 TiB | 1 TiB |
| Coordenadores, quando adotados | 2 x 2 OCPUs / 32 GB | 2 x 4 OCPUs / 32 GB |
| Dashboards, para HA da interface | 2 x 2 OCPUs / 8 GB | 2 x 2 OCPUs / 8 GB |
| Réplicas por primário | 1 | 1 |
| Search e ML nodes | Fora da configuração-base | Fora da configuração-base |
O armazenamento provisionado deve ser suficiente para entregar essa capacidade útil. Confira a unidade do campo de configuração e confronte o provisionamento com os bytes reportados pelo sistema de arquivos. Não aplique novamente uma reserva que já esteja excluída da capacidade utilizada no cálculo.
As contagens e combinações de OCPU/memória estão dentro das faixas publicadas para os papéis apresentados; disponibilidade e capacidade útil devem ser confirmadas no ambiente. Coordenadores são candidatos a teste, não uma exigência decorrente apenas do número de data nodes.
No catálogo, 240 GiB primários com uma réplica ocupam aproximadamente 480 GiB. A coexistência com uma versão reconstruída de tamanho semelhante dobra esse valor antes das margens. A escolha de disco não depende apenas desse total: inclui reindexação, crescimento e desempenho observado.
A comparação de custo deve manter iguais os objetivos de desempenho e de recuperação. Uma configuração mais barata que atende apenas com todos os nós disponíveis não é equivalente àquela dimensionada para o evento de falha definido. Na avaliação deste projeto, inclua os recursos da topologia, o armazenamento, os backups e o caminho de ingestão. Relacione o total à carga efetivamente atendida dentro das metas; isso evita comparar apenas o preço de máquinas com responsabilidades ou reservas diferentes.
6. Ciclo de vida, ingestão e busca sob atualização
O dimensionamento considera uma carga, mas essa carga muda durante a vida do índice. Logs continuam chegando, dados antigos perdem frequência de acesso e produtos são atualizados enquanto usuários pesquisam. O ciclo de vida define como acomodar essas mudanças sem deixar o crescimento do índice, a manutenção e as reconstruções competirem de forma imprevisível. Os mecanismos a seguir tratam etapas diferentes desse problema.
Data streams e ISM para eventos; aliases para catálogos
Data streams agrupam backing indexes, encaminham novas escritas ao índice corrente e exigem um campo temporal, normalmente @timestamp. São adequados ao fluxo predominantemente append-only dos logs. No catálogo, prefira índices versionados e aliases estáveis.
Para os logs, rollover significa passar as novas escritas para outra geração de índice, mantendo as gerações anteriores disponíveis para consulta. ISM automatiza a ação conforme as condições da política. Usar tamanho junto de idade ajuda a lidar com dias de volumes diferentes: um pico pode atingir o limite de tamanho antes de completar um dia. O fragmento abaixo expressa essa decisão, sem representar toda a política de retenção.
{
  "rollover": {
    "min_primary_shard_size": "40gb",
    "min_index_age": "1d"
  }
}
Esse é um fragmento de ação ISM, não uma política completa. min_primary_shard_size considera um primário individual; min_size, a soma dos primários. A ação ocorre quando uma condição é atendida na avaliação periódica, portanto pode haver ultrapassagem do limiar. Para aliases, configure o alias de rollover e o índice de escrita; em data streams, ISM infere o destino.
Defina retenção por idade do índice, tempo desde rollover ou semântica dos eventos. Excluir um índice 30 dias após sua criação não significa reter cada evento por 30 dias. Eventos atrasados e exigências de retenção mínima ou máxima precisam entrar no desenho.
Compressão e histórico pesquisável
Depois que uma geração deixa de receber o fluxo principal de escrita, sua frequência de consulta pode mudar. Nesse ponto, a pergunta é quanto processamento e armazenamento vale reservar para o histórico. Compressão altera a representação dos dados; searchable snapshots alteram também o caminho de acesso, utilizando armazenamento remoto e cache local. São decisões diferentes, a avaliar contra a frequência de consulta e o prazo de resposta exigido para esses dados.
Para avaliar compressão, compare o index.codec padrão com alternativas como best_compression ou zstd, quando suportadas pela versão e pelo tipo de índice. O codec controla a compressão dos campos armazenados e pode alterar espaço ocupado, consumo de CPU e latência. Indexe a mesma amostra com cada configuração e compare armazenamento primário, ingestão e consultas. Alterar o codec não reescreve imediatamente os segmentos existentes; uma migração para outro índice exige planejar reindexação e espaço temporário.
Searchable snapshots permitem consultar dados mantidos no Object Storage com cache nos search nodes integrado ao ISM. Use essa alternativa para histórico somente após medir cache frio, cache aquecido e recuperação. O histórico pode ter um SLO diferente do índice ativo.
Controle a pressão antes de ampliar filas
O cliente de ingestão – a aplicação ou o componente do pipeline que envia documentos ao OpenSearch – precisa controlar quanto trabalho envia e como reage quando o cluster não consegue acompanhá-lo. Continuar aumentando o envio durante uma sobrecarga pode provocar mais rejeições, em vez de aumentar a quantidade de documentos indexados.
No desenho proposto, backpressure significa reduzir o ritmo de envio e manter os eventos pendentes no armazenamento persistente, em vez de acumular requisições indefinidamente. O OCI Streaming pode cumprir esse papel, conservando mensagens para processamento e releitura dentro da retenção configurada.
Considere um exemplo: chegam 10.000 eventos/s, mas o pipeline consegue concluir apenas 8.000. Acumulam-se 2.000 eventos a cada segundo. O buffer absorve essa diferença temporariamente; não resolve uma entrada permanentemente superior à capacidade de processamento.
Ajuste o tamanho dos lotes e a quantidade de envios simultâneos
A Bulk API permite reunir várias operações em uma única requisição, reduzindo a necessidade de uma chamada individual para cada documento. O guia upstream recomenda iniciar os testes com lotes de 5-15 MiB: esse valor se refere ao tamanho da requisição, não de cada documento. É um ponto de partida para experimentação, não um tamanho ideal para qualquer cluster.
Além do tamanho, controle a concorrência. Requisições em voo são aquelas que já foram enviadas e cuja resposta ainda não chegou. Como exemplo de configuração do cliente, um limite de quatro requisições permite enviar um novo lote somente quando uma delas termina.
Nos testes, altere tamanho e concorrência separadamente. Primeiro, mantenha a concorrência fixa e compare tamanho de lote; depois, mantenha o tamanho e varie os envios simultâneos. Observe documentos indexados por segundo, latência e rejeições. Enviar mais lotes só representa ganho se o cluster conseguir concluí-los sem comprometer as demais cargas.
Verifique o resultado de cada operação
Uma resposta HTTP bem-sucedida da Bulk API não significa que todos os documentos foram indexados. O lote pode conter operações concluídas e outras rejeitadas. Verifique o campo errors e os resultados individuais em items.
Por exemplo, em um lote hipotético de 1.000 documentos, 990 podem ser indexados e dez falhar. A resposta permite identificar esses dez; não é necessário reenviar automaticamente os 1.000. O tratamento depende do motivo da falha:
| Situação | Tratamento |
|---|---|
| Rejeição por sobrecarga, como 429 | Reduzir a pressão e tentar novamente após uma espera |
| Documento incompatível com o mapping | Separar para correção; repetir o mesmo conteúdo não resolve a incompatibilidade |
As falhas de cada operação e suas causas devem orientar o reprocessamento
Nas retentativas, use espera progressiva, aumentando o intervalo entre tentativas, com uma variação aleatória chamada jitter. Essa variação evita que vários clientes voltem a enviar seus lotes exatamente ao mesmo tempo, recriando a sobrecarga. Limite as tentativas e preserve os itens ainda pendentes para tratamento posterior.
Também diferencie falha confirmada de resultado desconhecido: um timeout sem resposta não comprova que a operação deixou de acontecer. O reenvio precisa considerar a possibilidade de repetição.
Em operação index, reutilizar o mesmo _id no mesmo índice e com roteamento consistente permite atuar sobre o mesmo documento. Isso, porém, não impede que uma atualização antiga substitua uma mais recente; essa proteção exige controle de versão ou concorrência.
Separe visibilidade na busca de persistência dos dados
Refresh responde à pergunta “quando o documento aparece nas pesquisas?”. Aumentar index.refresh_interval, por exemplo para 30s, reduz a frequência dessa operação e pode favorecer a ingestão quando a aplicação aceita esperar mais pelas alterações. O intervalo não representa uma garantia de prazo ponta a ponta: antes do refresh, o evento pode ter passado tempo no buffer e no processamento.
Durabilidade responde a outra pergunta: “a operação confirmada já foi persistida para recuperação após uma falha?”. O translog é o registro de operação utilizado nessa recuperação; sua persistência não depende de o documento já estar visível na busca. Portanto, um documento pode estar confirmado e persistido, mas ainda aguardar refresh para aparecer nos resultados.
Com index.translog.durability=request a confirmação aguarda a sincronização do translog com o armazenamento. Com async, essa sincronização ocorre em segundo plano: uma falha antes dela pode causar perda de operações que o cliente já considerava concluídas. Aumentar o intervalo de refresh e adotar durabilidade assíncrona são decisões diferentes; a segunda altera o risco de perda de dados.
Cache e atualizações precisam coexistir no teste
O request cache guarda resultados de consultas em cada shard, permitindo reaproveitá-los quando uma consulta elegível se repete. Por padrão, isso se aplica a buscas com size=0: elas não retornam documentos individuais, mas podem calcular agregações, como a quantidade de produtos por marca.
Quando os dados mudam, o resultado armazenado pode deixar de representar o catálogo. Por isso, refreshes que tornam alterações pesquisáveis invalidam os resultados correspondentes no request cache. Teste a busca enquanto produtos são inseridos, atualizados e excluídos, não apenas repetindo consultas sobre uma base sem alterações. Assim, o ensaio considera a necessidade de refazer trabalho, além de reaproveitá-lo.
Existem outros mecanismos: o query cache reaproveita informações entre consultas, enquanto o cache de arquivos do sistema operacional mantém dados dos arquivos em memória. Portanto, nem todo benefício de cache vem de uma resposta já calculada.
Para algumas agregações, o OpenSearch utiliza global ordinals, estruturas auxiliares que associam os valores de um campo a identificadores numéricos. Ativar eager_global_ordinals antecipa sua construção para o refresh, evitando que a primeira consulta que necessita delas pague esse custo. A contrapartida é mais trabalho durante o refresh; as estruturas também ocupam heap. Avalie por campo, especialmente quando houver alta cardinalidade — muitos valores distintos —, pois o consumo de memória pode ser elevado.
Já o force merge combina segmentos, as partes internas que armazenam os dados de cada shard, reduzindo sua quantidade. Ele exige espaço temporário para reescrever os dados e deve ser reservado a índices que não receberão novas escritas. Em índices ainda atualizados, pode produzir segmentos grandes e prejudicar o desempenho. Não é uma correção genérica para consultas lentas.
Migração segura não termina na troca do alias
Um alias é um nome lógico que a aplicação utiliza para acessar um índice. Por exemplo, catalogo pode apontar para catalogo-v1 e, depois da migração, para catalogo-v2. A troca pode ser atômica — remover o vínculo antigo e criar o novo na mesma operação —, mas mudar o destino das consultas não garante que o novo índice contenha os dados corretos.
A API _reindex copia documentos, mas não acompanha continuamente as alterações posteriores da origem. Também não copia automaticamente mappings e settings: configure o destino antes da carga. No comportamento padrão, documentos copiados podem sobrescrever outros com o mesmo ID no destino.
Imagine que um preço passe de R$ 100 para R$ 90 durante a migração. Se a atualização chegar primeiro ao novo índice e a cópia antiga chegar depois, o preço pode voltar incorretamente para R$ 100. Para impedir isso, carga inicial e atualizações concorrentes devem utilizar uma versão crescente por produto, gerada na origem. Se R$ 100 corresponde à versão 7 e R$ 90 à versão 8, version_type=external rejeita a versão 7 quando a 8 já está armazenada. O pipeline precisa reconhecer esse conflito, não repetir indefinidamente uma versão ultrapassada. As versões internas de índices independentes não substituem essa numeração comum.
Para este projeto, o procedimento proposto é criar o destino, copiar uma visão consistente da origem e aplicar as alterações e exclusões registradas desde aquele ponto. Antes da troca, interrompa novos envios ao índice antigo, aguarde os já iniciados terminarem e confirme que suas alterações chegaram ao destino. Sem um registro confiável das mudanças, planeje uma janela de pausa de escrita que permita copiar e validar os dados sem alterações concorrentes.
O protocolo também deve preservar marcadores de exclusão: registros que identificam quais produtos foram removidos e em qual versão. Durante o período em que eventos antigos ainda possam ser reenviados, esses registros devem ser consultados pelo pipeline para impedir que uma cópia atrasada recrie um produto excluído.
Prepare também o retorno ao índice anterior, chamado rollback. Apenas devolver o alias não atualiza seus documentos: no plano proposto, o índice antigo deve continuar recebendo as mudanças ou permitir reaplicá-las antes de voltar a atender à aplicação. A troca do alias muda o acesso; a sincronização preserva o estado dos dados.
7. Recuperação, redimensionamento e continuidade
Durante uma falha, o cluster precisa atender ao tráfego com menos recursos e recompor as cópias perdidas. São dois objetivos relacionados, mas distintos: uma réplica sobrevivente pode permitir a retomada do atendimento antes de a redundância ser reconstruída. O planejamento deve medir por quanto tempo a aplicação fica fora da meta e por quanto tempo os dados permanecem com menos cópias do que o previsto.
Planeje backlog para resize e manutenção
O buffer deve cobrir tanto mudanças de capacidade quanto manutenção do serviço. A Oracle documenta patches programados para a terceira semana de cada mês, sem garantia de ocorrerem no mesmo dia, além de intervenções não programadas quando necessárias. Durante o patching, as leituras permanecem disponíveis, mas as escritas ficam bloqueadas. A duração da janela está relacionada à quantidade de índices e shards, conectando a estratégia de particionamento ao planejamento da ingestão.
Para redimensionamento, diferencie a operação utilizada: a documentação atual informa que o resize horizontal in-place mantém leituras e escritas; o aumento isolado de armazenamento também não exige modo somente leitura. Outras operações podem bloquear escritas temporariamente. Mesmo sem bloqueio, desempenho e requisições individuais podem ser afetados. O plano deve considerar interrupções e períodos em que a capacidade de ingestão fique abaixo da entrada. Se a taxa de entrada é lambda e o bloqueio de escrita dura T, o buffer precisa comportar pelo menos lambda x T, acrescido das margens. Após a retomada:
T_drenagem ~= backlog / (capacidade_de_processamento - entrada)Considere um exemplo didático: uma entrada de 1.000 eventos por segundo durante dez minutos sem escrita gera 600.000 eventos pendentes. Se a capacidade após a retomada for 1.600 eventos por segundo, apenas os 600 excedentes por segundo estarão disponíveis para reduzir o atraso, pois 1.000 continuam chegando. Nesse modelo, a drenagem leva 1.000 segundos, ou 16 minutos e 40 segundos. O cálculo assume taxas constantes e não inclui novas interrupções; o buffer em bytes também depende do tamanho dos eventos.
Uma capacidade igual à entrada normal não drena backlog. Dimensione armazenamento do buffer, retenção e processamento excedente; o retorno da API de escrita não significa que os dados já estão atualizados.
Backup, CCS e CCR resolvem problemas diferentes
CCS consulta clusters remotos. CCR replica índices para seguidores e permite aproximar dados dos consumidores ou manter uma cópia operacional em outra região. Não é escrita ativa-ativa sobre o mesmo índice, nem backup histórico independente de erros lógicos.
| Mecanismo | Comportamento documentado |
|---|---|
| Backup automático gerenciado | Gerado diariamente, mantido por 14 dias e associado ao mesmo compartimento do cluster. Essas configurações não são ajustáveis pelo cliente. |
| Backup manual pelo serviço | Criado sob demanda; pode utilizar outro compartimento e também possui retenção de 14 dias. |
| Snapshot API do OpenSearch | Mecanismo separado, com repositório em um bucket Object Storage indicado pelo cliente e opções como seleção de índices e renomeação na restauração. |
A Snapshot API oferece maior controle sobre o conteúdo e a restauração, mas exige administrar o repositório, as permissões e a retenção dos snapshots. O armazenamento no bucket é cobrado. Nos três mecanismos, valide a disponibilidade da cópia e execute restaurações; a existência de um backup concluído não comprova, sozinha, o prazo de recuperação da aplicação.
A replicação de buckets é assíncrona, não copia automaticamente objetos anteriores à política e propaga exclusões. Portanto, uma cópia remota em andamento não comprova um snapshot restaurável. Valide o conjunto completo e sua retenção; não manipule isoladamente arquivos do repositório.
RPO — Recovery Point Objective — é a perda máxima de dados aceitável, normalmente expressa em tempo. RTO — Recovery Time Objective — é o prazo máximo aceitável para restabelecer a aplicação. Esses objetivos devem orientar a escolha entre backups, snapshots e replicação; não pertencem exclusivamente à Snapshot API.
Um backup diário não garante, por si só, um limite máximo de perda de 24 horas. Quando os backups são produzidos e disponibilizados regularmente, a exposição pode ser da ordem de um dia; atrasos, falhas e a idade do último ponto efetivamente restaurável podem ampliar esse intervalo. Verifique o RPO pelo conteúdo recuperável e meça o RTO até a aplicação voltar a operar, incluindo restauração, replay, validação e aquecimento.
8. Segurança e governança
A segurança da solução combina controles com responsabilidades diferentes. A conectividade privada delimita os caminhos de rede até o cluster. As políticas IAM determinam quem pode administrar os recursos OCI. Dentro do OpenSearch, os papéis do Security plugin definem quais operações cada identidade pode executar sobre os índices. A separação permite conceder acesso à aplicação sem entregar, ao mesmo tempo, capacidade de administrar toda a infraestrutura.
No desenho proposto, a identidade de ingestão recebe as ações necessárias para escrever nos índices de destino; a identidade de consulta recebe leitura sobre o conjunto autorizado; e a operação utiliza permissões próprias para manutenção. Essa divisão reduz o alcance de uma credencial comprometida e permite revisar o acesso por responsabilidade. A conta administrativa inicial serve para configurar usuários e papéis, não como credencial compartilhada por todos os componentes.
Para pessoas que acessam o Dashboards, a integração SAML conecta a autenticação ao provedor de identidade corporativo e permite relacionar os usuários aos papéis de acesso. Isso concentra a gestão do acesso humano no fluxo de identidade da organização. Os clientes de aplicação mantêm uma identidade e um mecanismo de autenticação próprios. Nos OpenSearch Pipelines, a integração documentada com Vault mantém os secrets fora do YAML do pipeline e permite controlar quem pode obtê-los.
Quando diferentes grupos compartilham um índice, document-level security limita quais documentos cada papel pode ler, enquanto field-level security limita os campos legíveis. Por exemplo, uma equipe pode consultar apenas os registros de sua unidade sem receber determinados campos sensíveis. Essas regras são aplicadas na camada de autorização, em vez de depender apenas de um filtro montado pelo cliente. DLS e FLS protegem leitura: permissões de escrita e exclusão precisam ser restringidas separadamente. Inclua as regras no teste de carga e teste acessos que devem ser negados, além dos permitidos.
A governança mantém esses controles verificáveis ao longo do tempo. Definir um responsável pelo índice e aprovar mudanças de retenção evita que uma alteração operacional remova dados antes do prazo previsto. Revisar papéis e rotacionar credenciais acompanha mudanças de equipe e de aplicações. Proteger snapshots estende o controle às cópias dos dados. No desenho proposto, logs de consulta, tracing e diagnóstico também devem evitar exposição desnecessária de conteúdo sensível. A validação de certificados TLS integra essa proteção ao confirmar a identidade do endpoint ao qual o cliente envia credenciais e documentos.
9. Validação
As contas anteriores produzem uma configuração candidata. A validação verifica se essa configuração atende ao contrato da seção 2 quando documentos, consultas, atualizações e falhas ocorrem nas condições previstas. O resultado esperado não é apenas um pico de vazão: é uma faixa de operação na qual latência, atualização dos dados, erros e recuperação permanecem aceitáveis para a aplicação.
Protocolo de aceitação
Use OpenSearch Benchmark com corpus e consultas representativos, aquecimento, repetições e controle de variáveis. Registre versão, shape, mappings, shards, réplicas, refresh, durabilidade e cache. A documentação recomenda ambientes comparáveis e modificações isoladas.
Comece estabelecendo uma referência com carga controlada e dados representativos. Aumente a taxa de chegada por etapas para identificar quando a latência ou os erros deixam de atender à meta. Em seguida, repita a carga com atualizações e com os eventos transitórios relevantes ao projeto. Ao modificar uma configuração, repita as mesmas condições para verificar se a mudança removeu o limite observado ou apenas deslocou o problema. Esse procedimento é a proposta de ensaio para os cenários do artigo.
O protocolo proposto deve testar carga sustentada e pico; consultas durante ingestão e reindexação; falha do domínio planejado; recuperação e drenagem de backlog. Searchable snapshots exigem ensaios separados de cache frio e aquecido.
Meça a latência na API da aplicação e no gerador de carga. Um cliente que reduz a taxa enviada quando o servidor fica lento pode ocultar sobrecarga; preserve e publique o modelo de chegada. Registre taxas oferecida, aceita e concluída, timeouts, rejeições e resultados parciais. Relate percentis das requisições bem-sucedidas junto da taxa de erro, nunca isoladamente.
Observabilidade por nó, não apenas por média
A medição na aplicação responde se o contrato está sendo cumprido; as métricas do cluster ajudam a explicar o motivo. Uma média de CPU moderada pode esconder um nó sobrecarregado, e uma latência média baixa pode coexistir com p99 elevado. Compare os dados na mesma janela temporal e preserve a identificação do nó. Isso permite relacionar a degradação observada pelo cliente ao comportamento de recursos, shards e operações.
A OCI publica CPUUtilization, JVMMemoryPressure, CurrentClusterStorage, IndexingRate, SearchRate e latências, com dimensões como nodeName. Atenção: as taxas documentadas estão em operações por minuto; não as compare diretamente a QPS da aplicação. A telemetria do serviço também não substitui o p99 ponta a ponta.
Use as APIs abaixo para percorrer a investigação: o estado do cluster mostra a alocação das cópias; configurações e informações dos nós registram o ambiente efetivo; estatísticas mostram consumo e filas; a listagem de shards e a recuperação ajudam a localizar distribuição e transferências. Execute as consultas com uma identidade autorizada e relacione as respostas à janela do problema observado.
GET /_cluster/health
GET /_cluster/settings?include_defaults=true&flat_settings=true
GET /_nodes/jvm,os,thread_pool,settings
GET /_nodes/stats/process,jvm,fs,indices,thread_pool,breaker
GET /_cat/shards?v&bytes=b
GET /_cat/recovery?v&active_only=true
As APIs de nós expõem configuração e estatísticas para investigar heap, GC, CPU, pools, caches e I/O. Valores de configuração e defaults devem ser interpretados junto dos overrides e do build do serviço.
10. Preserve o contrato ao crescer
Dimensionar um motor de busca significa relacionar os recursos do cluster ao serviço que a aplicação precisa entregar: resultados relevantes, tempo de resposta aceitável e dados atualizados no prazo esperado. As escolhas de mapping, shards, memória, CPU e armazenamento devem sustentar esses objetivos durante a operação normal, mas também quando há picos, manutenção ou perda de capacidade.
Os dois cenários mostram por que não existe uma configuração única. Na observabilidade, o desafio é absorver eventos continuamente, controlar a retenção e recuperar a redundância sem acumular um atraso insustentável. No catálogo, é preservar a qualidade e a velocidade das consultas enquanto produtos são atualizados e índices são reconstruídos. O mesmo volume armazenado não implica a mesma necessidade de processamento.
Para novos ambientes, o caminho é transformar requisitos em uma configuração inicial, indexar uma amostra representativa e validar as estimativas com a carga esperada. Para clusters existentes, o ponto de partida são as métricas e o comportamento das consultas. Antes de adicionar recursos, identifique se a restrição está no hardware, na distribuição dos shards, na modelagem ou no trabalho solicitado pela aplicação. Cada alteração deve ter uma hipótese clara e um resultado mensurável.
A validação também precisa ultrapassar o teste de desempenho. Antes da produção, demonstre que a capacidade sobrevivente atende ao cenário de falha planejado, que os backups podem ser restaurados e que uma migração preserva atualizações e exclusões. Confronte o custo dessa configuração com os requisitos atendidos, incluindo a margem necessária para recuperação.
Uma arquitetura de busca está preparada para crescer quando a equipe conhece seus limites, reconhece os sinais da saturação e sabe como ampliar ou recuperar a capacidade sem perder o controle sobre os dados, o desempenho e o custo.