Oracle Autonomous AI Database 26ai: qualidade de busca competitiva, um motor híbrido mais completo e sem a necessidade de duplicar dados
Procurando busca BM25 ou busca híbrida no Oracle Database? Você está no lugar certo e pode parar de se preocupar com aquilo de que terá que abrir mão. O Oracle AI Database 26ai faz busca híbrida nativamente, sem necessidade de outro sistema para buscar por palavras-chave ou para combiná-la com vetores. Nos benchmarks a seguir, ele fica à frente de uma stack OpenSearch altamente otimizada em todos os datasets testados, e ainda conta com um mecanismo de fusão que oferece diversas funcionalidades integradas aos dados relacionais.
Tradicionalmente, implementar uma solução completa de busca envolve adicionar diferentes tecnologias, aumentando progressivamente a complexidade da arquitetura:
- Busca vetorial (semântica): encontra conteúdos semelhantes pelo significado, mas pode falhar com identificadores e termos exatos.
- Busca textual (full-text): permite localizar palavras-chave, códigos e mensagens de erro.
- Busca híbrida: combina resultados semânticos e textuais, exigindo mecanismos adicionais de integração.
- Filtros e permissões: demandam replicação de dados e regras de acesso entre sistemas.
- Busca em grafos: identifica relacionamentos entre informações, como dependências entre componentes ou vínculos entre documentos.
O resultado é uma arquitetura com múltiplas cópias dos mesmos dados, pipelines de sincronização, processos de reconciliação e riscos de inconsistência.
O Oracle AI Database 26ai unifica essas capacidades em um único banco de dados, permitindo executar buscas textuais, vetoriais e híbridas, aplicar filtros relacionais e percorrer relacionamentos em grafos, sem precisar replicar os dados em sistemas especializados.
Por exemplo:
CREATE HYBRID VECTOR INDEX docs_hvi ON docs(body)
  PARAMETERS ('VECTORIZER my_vectorizer LEXER my_lexer');
Esse comando cria um índice híbrido, combinando busca textual e vetorial sobre a mesma coluna. Ambas são gerenciadas pelo próprio banco de dados e mantidas consistentes com os dados originais.
O custo dos silos
Em uma arquitetura com múltiplos sistemas, manter os dados e os índices de busca sincronizados exige componentes adicionais, como ETL, message queues, indexers, pipelines de reindexação, jobs de reconciliação, replicação de atributos e controles de acesso (ACLs).
Esses componentes não melhoram diretamente a qualidade das buscas. Eles existem para compensar a separação entre o banco de dados e o mecanismo de busca, aumentando a complexidade e os custos operacionais.
Com o Oracle AI Database 26ai, os índices são gerenciados diretamente no banco e sincronizados automaticamente com as transações que modificam os dados, eliminando a necessidade dessa infraestrutura adicional e garantindo consistência.
1. Qualidade do Retrieval: Benchmark
Para validar que manter a busca dentro do banco de dados não compromete a relevância dos resultados, o Oracle AI Database 26ai foi comparado ao OpenSearch 3.6, utilizando busca híbrida (BM25 + busca vetorial no OpenSearch; Oracle Text + busca vetorial no Oracle), os mesmos embeddings e 2.271 queries de seis datasets públicos do BEIR.
O Oracle AI Database 26ai apresentou resultados superiores ao OpenSearch em todos os seis datasets, liderando em nDCG@10 e em quatro das cinco métricas gerais avaliadas.
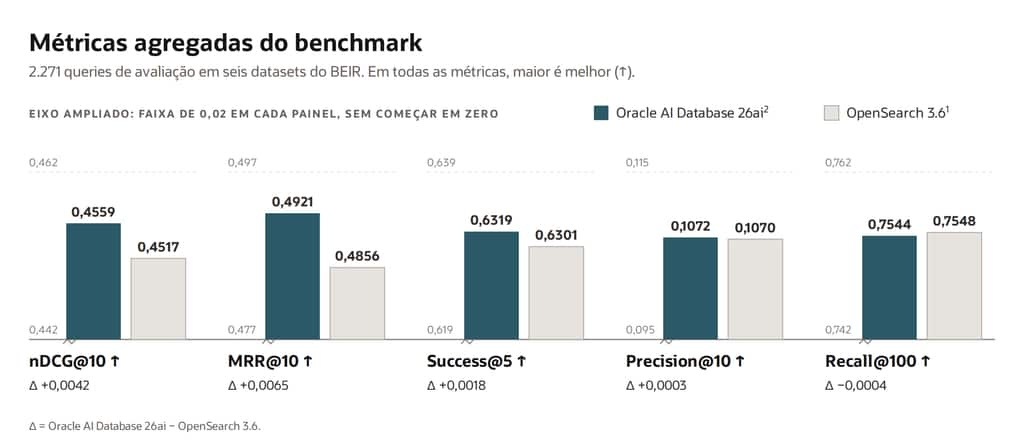
1 Configuração do OpenSearch: A comparação utilizou 324 configurações de fusão, além de otimizações do BM25, com query textual match simples; no Oracle AI Database 26ai, a formulação da query textual também foi escolhida no tuning. Ambos os mecanismos apresentaram melhores resultados priorizando a busca vetorial sobre a lexical.
2 Validação do índice HNSW: Com configurações padrão, o Oracle AI Database 26ai apresentou qualidade equivalente à busca exata (brute-force) nos quatro datasets avaliados, sem ganhos relevantes com tuning adicional de index_efsearch.
Por dataset, o Oracle lidera o nDCG@10 nos seis:
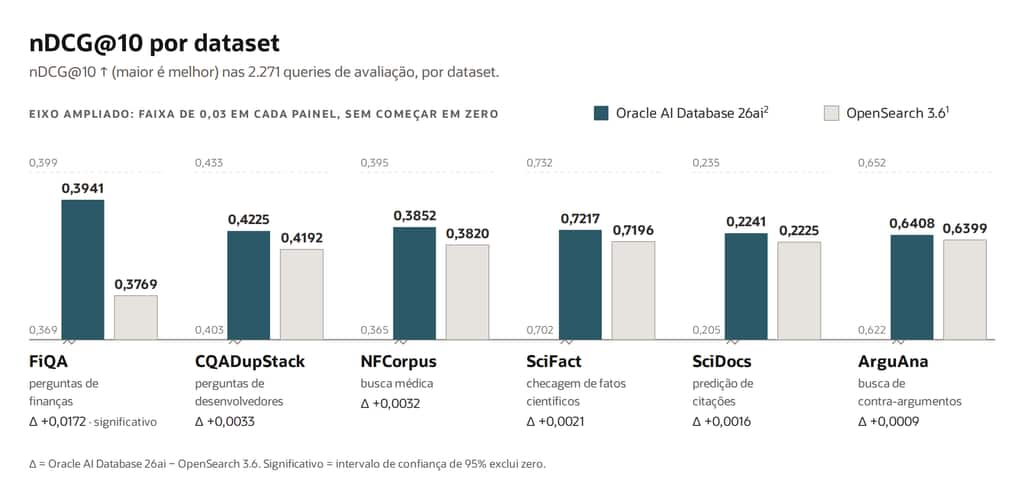
No FiQA a diferença é estatisticamente significativa em três métricas: +0,0172 de nDCG@10, +0,0217 de MRR@10 e +0,0293 de Success@5. É também a carga mais parecida com produção: perguntas longas, em linguagem natural, contra respostas de fórum, o formato típico de uma aplicação de RAG.
Em relação à busca apenas vetorial do próprio Oracle, nas mesmas queries, a busca híbrida ganhou +0,0291 de nDCG@10 no FiQA, +0,0177 no NFCorpus e +0,0150 no CQADupStack, ficando à frente nos seis datasets.
2. Além do BM25: Recursos Avançados de Busca Híbrida
Além da qualidade de retrieval demonstrada nos benchmarks, o Oracle AI Database 26ai oferece recursos avançados de busca híbrida que permitem personalizar estratégias de busca, ranking e processamento de documentos diretamente no banco de dados.
O principal diferencial é a flexibilidade para combinar busca vetorial e textual, ajustar a relevância dos resultados e integrar todo o pipeline de RAG utilizando SQL, sem depender de serviços externos ou reindexação.
Estratégias de Search Fusion
O Oracle AI Database 26ai oferece sete modos de fusão em um único índice híbrido:
| Modo | Resultado |
| UNION | híbrida clássica: tudo o que qualquer lado encontrou |
| INTERSECT | alta precisão: só o que os dois lados encontraram |
| RERANK | o texto recupera, o vetor reordena |
| MINUS_TEXT | o que os vetores encontraram e as palavras-chave não |
| MINUS_VECTOR | o que as palavras-chave encontraram e os vetores não |
| TEXT_ONLY | só léxica, mesmo índice |
| VECTOR_ONLY | só semântica, mesmo índice |
A estratégia pode ser definida por query, sem necessidade de reindexação.
Em nosso dataset de demonstração, uma query encontrou 72 documentos pela busca textual e 148 pela vetorial. O MINUS_VECTOR retornou os 13 documentos encontrados apenas pela busca textual, e o MINUS_TEXT, os 89 encontrados apenas pela vetorial.
Custom Scoring e Ranking
Com o parâmetro score_calc, é possível criar fórmulas personalizadas de relevância utilizando scores e rankings textuais e vetoriais. Ele recebe uma árvore de expressão em JSON sobre quatro variáveis (text_score, vector_score, text_rank, vector_rank), combinadas com add, sub, mul, div, greatest, least, power, mod, round, remainder, exp, sqrt, abs, floor e ceil. Isso permite implementar Weighted Scoring, Reciprocal Rank Fusion (RRF), médias geométricas e outras estratégias diretamente na query, sem desenvolver serviços externos de reranking.
Por exemplo, uma soma ponderada:
{"op":"add","opnds":[
  {"op":"mul","opnds":["text_score", 0.3]},
  {"op":"mul","opnds":["vector_score", 0.7]}]}
Fusão por posição recíproca (RRF) montada manualmente, com a penalidade desejada:
{"op":"add","opnds":[
  {"op":"div","opnds":[1, {"op":"add","opnds":["text_rank", 60]}]},
  {"op":"div","opnds":[1, {"op":"add","opnds":["vector_rank", 60]}]}]}
Uma média geométrica, que penaliza documentos fortes em só um dos lados:
{"op":"sqrt","opnds":[{"op":"mul","opnds":["text_score","vector_score"]}]}Também é possível dividir o score textual na própria fórmula:
{"op":"add","opnds":[
  {"op":"mul","opnds":[{"op":"div","opnds":["text_score",100]}, 0.3]},
  {"op":"mul","opnds":["vector_score", 0.7]}]}
Como os scores textual e vetorial vão ambos de 0 a 100, essa fórmula equivale a pesos de 1:233 e praticamente ignora o lado textual.
Todas essas expressões rodam em todos os datasets e podem ser alteradas por query, sem reindexação.
Retrieval por Documento ou Chunk
O Oracle AI Database 26ai permite alternar entre retrieval por CHUNK ou DOCUMENT, evitando que múltiplos trechos do mesmo documento dominem os resultados e que o top N se encha de trechos do mesmo arquivo.
"vector": { "search_mode": "DOCUMENT", "aggregator": "BONUSMAX" }Entre as estratégias de agregação disponíveis estão MAX, AVG, MEDIAN, BONUSMAX, WINAVG, ADJBOOST, MAXAVGMED, permitindo ajustar o ranking conforme o contexto da aplicação RAG.
BONUSMAX favorece um documento com um trecho muito relevante; AVG, relevância consistente ao longo do texto; WINAVG, a melhor janela. A escolha depende do uso (buscar evidência ou material de leitura) e é feita por query.
Busca Textual Avançada
O BM25 trata a query como um conjunto de palavras. O Oracle Text aceita uma expressão:
| Operador | Significado |
| NEAR((a,b), n) | os dois termos a até n palavras de distância |
| ABOUT(text) | documentos sobre o conceito, não só os tokens |
| $term | o termo e suas variações de flexão |
| ?term | correspondência aproximada (erros de digitação, variantes) |
| !term | correspondência fonética |
| {term}*n | peso n para o termo, só nesta query |
Motores de busca também oferecem parte disso (match_phrase com slop dá proximidade; analisadores dão radicalização). A diferença está em onde o sinal entra. No Oracle AI Database 26ai, os operadores são termos da mesma expressão pontuada que a fusão usa, ponderados entre si e alterados por query. Em outros motores, são cláusulas adicionais a equilibrar ou propriedades do índice que exigem reconstrução para mudar. A função BM25 em si não considera posição, tema nem morfologia.
Com o NEAR, reduzir a janela de proximidade para cinco palavras nas perguntas de desenvolvedores, inverteu um resultado desfavorável.
A melhor formulação variou por dataset: NEAR com janela curta em perguntas de desenvolvedores e predição de citações, proximidade em checagem de fatos e expansão de radicais com peso por IDF em busca médica. A troca é feita editando a string da query, sem reindexar nem mudar o analisador.
Evidências e Citações para RAG
Com CTX_DOC.SNIPPET e CTX_DOC.HIGHLIGHT, o Oracle AI Database 26ai retorna trechos relevantes e termos destacados diretamente do índice híbrido, junto com os documentos e seus scores.
Isso facilita a geração de respostas RAG com citações verificáveis, sem exigir um pipeline adicional de destaque de trechos.
Pipeline de Ingestão Integrado
O pacote DBMS_VECTOR_CHAIN permite executar diretamente em SQL as principais etapas de ingestão:
Document parsing → Text extraction → Chunking → Embeddings → Indexing → Hybrid Search
Funções como UTL_TO_TEXT, UTL_TO_CHUNKS e UTL_TO_EMBEDDING simplificam o processamento de documentos, reduzindo a necessidade de serviços externos e movimentação de dados.
Suporte Multilíngue
O Oracle AI Database 26ai oferece suporte a buscas textuais em múltiplos idiomas, incluindo detecção automática com AUTO_LEXER, suporte a conteúdos mistos com WORLD_LEXER e suporte a português e espanhol com stemming, stoplist padrão e correspondência aproximada.
3. Dados Corporativos: Relacionamentos, Grafos e Segurança
Em aplicações corporativas, a busca não se limita a encontrar documentos semanticamente semelhantes. Os resultados também precisam respeitar relacionamentos entre clientes, produtos, versões, contratos, permissões e tickets.
Por exemplo, uma busca pode precisar localizar documentos relevantes considerando simultaneamente o cliente, o produto, a versão, o tenant e as permissões do usuário.
Filtros Relacionais e Controle de Acesso
O OpenSearch oferece filtros eficientes, mas exige que os atributos utilizados na busca sejam replicados e mantidos sincronizados no índice.
Isso é especialmente importante para permissões de acesso (entitlements). Uma alteração não refletida no índice pode expor informações indevidamente, transformando um problema de sincronização em um risco de segurança.
No Oracle AI Database 26ai, os filtros são aplicados diretamente sobre os dados relacionais, sem necessidade de manter cópias desses atributos em sistemas externos.
Em nosso dataset de demonstração, a mesma busca híbrida apresentou os seguintes resultados:
| Predicado | Linhas retornadas |
| sem filtro (50 primeiros) | 50 |
| entitlement = 'public' | 44 |
| product in ('db','ml') and tenant_id < 3 | 10 |
| entitlement = 'public' and tenant_id in (1,2) and version >= 2 | 10 |
| tenant_id = 2 and version >= 2 | 5 |
Como os resultados da busca híbrida podem ser utilizados diretamente em SQL, é possível combinar relevância com JOINs, filtros e agregações.
Por exemplo, agregando os resultados por produto:
| Produto | Documentos | Relevância média |
| search | 8 | 69,67 |
| net | 17 | 68,37 |
| ml | 10 | 68,06 |
| db | 9 | 67,06 |
Os filtros também podem ser incorporados ao índice híbrido, permitindo sua aplicação durante o retrieval, e não apenas após a recuperação dos resultados:
CREATE HYBRID VECTOR INDEX docs_hvi ON docs(body)
  FILTER BY tenant_id, product, version, entitlement
  PARAMETERS (...);
Isso permite combinar busca híbrida e regras de negócio utilizando uma única query SQL, um otimizador e uma transação.
Busca Híbrida Integrada a Grafos
Alguns relacionamentos são mais naturalmente representados como: grafos, citações entre documentos, dependências entre componentes, hierarquias de permissões e cadeias de suprimentos.
O Oracle AI Database 26ai suporta SQL/PGQ, permitindo definir property graphs diretamente sobre tabelas relacionais existentes, sem duplicar os dados.
Por exemplo, um grafo de citações entre documentos:
CREATE PROPERTY GRAPH doc_graph
  VERTEX TABLES (docs KEY (doc_id) LABEL document
                   PROPERTIES (doc_id, tenant_id, product, entitlement))
  EDGE TABLES  (cites KEY (src, dst)
                  SOURCE KEY (src) REFERENCES docs (doc_id)
                  DESTINATION KEY (dst) REFERENCES docs (doc_id)
                  LABEL cites);
Com isso, é possível executar um fluxo de retrieval que combina busca semântica, navegação em grafos e validação de permissões em uma única query (o filtro de permissão das sementes vai no próprio :spec, via filter_by):
WITH seeds AS (
  SELECT d.doc_id, j.score
    FROM JSON_TABLE(DBMS_HYBRID_VECTOR.SEARCH(JSON(:spec)), '$[*]'
         COLUMNS (rid VARCHAR2(255) PATH '$.rowid', score NUMBER PATH '$.score')) j
    JOIN docs d ON d.rowid = CHARTOROWID(j.rid))
SELECT s.doc_id AS seed, s.score, g.neighbour, v.product
  FROM seeds s
  JOIN GRAPH_TABLE(doc_graph
         MATCH (a IS document) -[e IS cites]-> (b IS document)
         COLUMNS (a.doc_id AS origin, b.doc_id AS neighbour)) g
    ON g.origin = s.doc_id
  JOIN docs v ON v.doc_id = g.neighbour
 WHERE v.entitlement = 'public'
 ORDER BY s.score DESC;
Em nosso teste, expandir a navegação para dois níveis (two hops) permitiu alcançar 67 documentos relacionados a partir de 25 documentos iniciais.
Em uma arquitetura fragmentada, esse mesmo fluxo poderia exigir três sistemas especializados: um vector store, um mecanismo de busca textual e um graph database, além de código adicional para integrar os resultados e aplicar permissões.
No Oracle, essas operações utilizam os mesmos dados e são executadas diretamente em SQL.
Geração de Embeddings no Banco de Dados
Além de integrar busca híbrida e grafos, o Oracle AI Database 26ai permite executar modelos de embedding diretamente no banco, utilizando SQL:
SELECT VECTOR_EMBEDDING(my_model USING :text AS data) FROM dual;Isso elimina a necessidade de um serviço externo de inferência durante a query, reduzindo a complexidade operacional e o risco de inconsistência entre os embeddings utilizados na indexação e na busca.
4. Otimização do Ranking: O Impacto do Score Weight
Um dos parâmetros mais importantes para a qualidade da busca híbrida é o score_weight, que multiplica o score da busca textual e o da vetorial antes da soma.
No Oracle AI Database 26ai, o Oracle Text e a busca vetorial produzem scores de 0 a 100, e a estratégia de fusão RSF calcula uma média ponderada desses scores. O padrão do índice já dá ao vetor um peso 10 vezes maior que ao texto.
Nos testes, partindo do padrão de 1:10 (texto:vetor), houve ganhos adicionais ao aumentar o peso vetorial.
Mantendo os demais parâmetros constantes e ajustando apenas o score_weight, os resultados de nDCG@10 no conjunto de tuning foram:
| Dataset | 1:10 (padrão) | Melhor peso | Ganho |
| FiQA | 0,3821 | 0,4087 (1:30) | +0,0266 |
| CQADupStack | 0,4113 | 0,4290 (1:20) | +0,0177 |
| SciDocs | 0,2135 | 0,2239 (1:200) | +0,0104 |
| SciFact | 0,7933 | 0,8013 (1:20) | +0,0080 |
| ArguAna | 0,6050 | 0,6183 (1:30) | +0,0133 |
| NFCorpus | 0,3700 | 0,3775 (1:20) | +0,0075 |
Os seis datasets apresentaram melhorias apenas com o ajuste desse parâmetro, sem necessidade de reindexação.
Configuração Inicial Recomendada
Embora o tuning ideal dependa do dataset e do tipo de query, os testes identificaram uma configuração inicial que oferece bons resultados sem ajustes específicos por domínio.
SELECT d.id, d.title, j.score
  FROM JSON_TABLE(
         DBMS_HYBRID_VECTOR.SEARCH(JSON_OBJECT(
           'hybrid_index_name' VALUE 'docs_hvi',
           'search_fusion'     VALUE 'UNION',
           'search_scorer'     VALUE 'RSF',
           'text'   VALUE JSON_OBJECT('contains'     VALUE :text_query,
                                      'score_weight' VALUE 1,
                                      'result_max'   VALUE 2000),
           'vector' VALUE JSON_OBJECT('search_text'  VALUE :user_question,
                                      'score_weight' VALUE 20,
                                      'result_max'   VALUE 500),
           'filter_by' VALUE JSON_OBJECT('op' VALUE '=', 'col' VALUE 'ENTITLEMENT',
                                         'type' VALUE 'string',
                                         'args' VALUE JSON_ARRAY(:caller_entitlement)),
           'return' VALUE JSON_OBJECT('topN' VALUE 20,
                                      'values' VALUE JSON_ARRAY('rowid', 'score'))
           RETURNING JSON)), '$[*]'
         COLUMNS (rid VARCHAR2(255) PATH '$.rowid',
                  score NUMBER PATH '$.score')) j
  JOIN docs d ON d.rowid = CHARTOROWID(j.rid)
 ORDER BY j.score DESC;
A configuração utiliza fusão UNION, scoring RSF e uma proporção de 1:20 entre busca textual e vetorial.
Cada lado possui seu próprio result_max, definido por query. Nos testes, esse foi um dos parâmetros de maior impacto na qualidade, que se estabiliza entre 500 e 2.000 candidatos por lado. Todos os resultados deste artigo utilizam no máximo 2.000; no FiQA, 2.000 candidatos tiveram resultado superior a 20.000.
No conjunto de tuning, essa configuração fixa, sem tuning por dataset, alcançou 98,6% da qualidade obtida com configurações individualmente otimizadas, contra 95,6% da configuração padrão.
Além disso, não apresentou resultados inferiores ao padrão em nenhum dos seis datasets.
Isso demonstra que é possível iniciar com uma configuração simples e posteriormente ajustar pesos, estratégias de busca e formulação das queries, sem reconstruir o índice.
5. Metodologia e Reprodutibilidade dos Benchmarks
A comparação entre Oracle AI Database 26ai e OpenSearch 3.6 utilizou seis datasets públicos do BEIR: NFCorpus, SciFact, ArguAna, SciDocs, CQADupStack e FiQA.
As queries foram divididas de forma determinística entre conjuntos de tuning e validação. Todas as configurações foram selecionadas utilizando exclusivamente o conjunto de tuning, enquanto os resultados da comparação com o OpenSearch foram calculados sobre 2.271 queries não utilizadas na otimização.
Ambos os mecanismos utilizaram os mesmos embeddings, gerados pelo modelo BAAI/bge-base-en-v1.5 em ONNX, tanto para documentos quanto para queries.
A avaliação considerou cinco métricas: nDCG@10, MRR@10, Success@5, Precision@10 e Recall@100, com intervalos de confiança calculados por paired bootstrap de 10.000 amostras.
A principal conclusão do benchmark é que a busca híbrida integrada ao Oracle AI Database 26ai alcança qualidade de retrieval comparável à de uma stack OpenSearch otimizada, sem exigir um mecanismo de busca separado.
6. Conclusão: Uma Arquitetura Convergente para Busca e RAG
A questão central não é apenas se um banco de dados consegue executar buscas textuais ou vetoriais, mas quais benefícios justificam manter uma infraestrutura de busca separada.
Os benchmarks demonstram que o Oracle AI Database 26ai oferece qualidade de retrieval competitiva com o OpenSearch 3.6, além de recursos avançados para aplicações de busca e RAG:
- Sete estratégias de Search Fusion e fórmulas personalizadas de ranking.
- Retrieval por documento ou chunk, com diferentes estratégias de agregação.
- Busca textual avançada com operadores de proximidade, expansão e ponderação.
- Filtros relacionais e controle de acesso diretamente sobre os dados.
- Navegação em grafos integrada à busca híbrida.
- Geração de embeddings e processamento de documentos dentro do banco.
Em arquiteturas tradicionais, essas funcionalidades frequentemente exigem diferentes sistemas especializados, com replicação de dados, pipelines de sincronização e código adicional de integração.
No Oracle AI Database 26ai, elas podem ser combinadas diretamente em SQL, utilizando os dados já existentes.
Por exemplo, um índice híbrido com filtros de tenant e permissões pode ser criado com:
CREATE HYBRID VECTOR INDEX docs_hvi ON docs(body)
  FILTER BY tenant_id, entitlement
  PARAMETERS ('VECTORIZER my_vectorizer LEXER my_lexer');
O resultado é uma arquitetura mais simples e integrada, que reduz a necessidade de sistemas adicionais e permite combinar busca híbrida, regras de negócio, segurança e relacionamentos em uma única plataforma.
Para quem já utiliza Oracle Database, a busca híbrida pode ser incorporada diretamente às tabelas existentes, sem adicionar um novo cluster de busca ou manter outra cópia dos dados.
Para começar, o guia Understand Hybrid Vector Indexes, do Oracle AI Vector Search User’s Guide, mostra como criar e consultar o índice híbrido, e a referência do pacote DBMS_HYBRID_VECTOR detalha os parâmetros de busca usados neste artigo. Para experimentar sem custo, use o Oracle AI Database Free.
Detalhes técnicos
| Item | Oracle AI Database 26ai | OpenSearch 3.6.0 |
| Versão / nó | 26ai Enterprise Edition, 23.26.3.2.0, Autonomous ATP | nó único, Docker, 1 shard, 0 réplicas |
| Índice vetorial | BASIC_VECTORIZER: VECTOR_IDXTYPE HNSW · VECTOR_DISTANCE COSINE · CHUNK_BY WORDS · CHUNK_MAX 8000 · CHUNK_EXTENDED YES · demais no padrão | knn_vector, dimensão 768, engine faiss, método hnsw, space_type cosinesimil, ef_construction 200, m 16, ef_search 512 |
| Lado léxico | BASIC_LEXER com INDEX_STEMS ENGLISH, STOPLIST CTXSYS.DEFAULT_STOPLIST | um campo text com 32 subcampos, um por célula de BM25: analisadores standard e english × k1 ∈ {0.6, 0.9, 1.2, 1.5} × b ∈ {0.3, 0.6, 0.75, 0.9} |
| Query | DBMS_HYBRID_VECTOR.SEARCH, search_fusion UNION, search_scorer RSF, return.topN 200 | hybrid com match no subcampo escolhido e knn com k 500, pagination_depth 1000, size 200 |
| Fusão | score_weight e result_max por dataset (tabela abaixo) | normalization-processor, escolhido por dataset entre 54 pipelines; min_max com arithmetic_mean em todos |
| Dataset | Oracle score_weight (texto : vetor) | Oracle result_max (texto / vetor) | Formulação Oracle Text | OpenSearch subcampo BM25 | OpenSearch pesos (texto / vetor) |
| SciFact | 1 : 10 | 1000 / 500 | termos ponderados por idf + NEAR((rare₁,rare₂),10)*3 | english_k06_b06 | 0,3 / 0,7 |
| NFCorpus | 1 : 20 | 250 / 2000 | termos $stem ponderados *max(1,min(5,1+idf)) | english_k15_b03 | 0,1 / 0,9 |
| ArguAna | 1 : 30 | 1000 / 500 | NEAR sobre cada par de termos adjacentes, janela 5 | english_k15_b09 | 0,4 / 0,6 |
| SciDocs | 1 : 200 | 1000 / 500 | NEAR((rare₁,rare₂),5)*3 + termos | english_k15_b09 | 0,1 / 0,9 |
| CQADupStack | 1 : 20 | 1000 / 500 | NEAR((rare₁,rare₂),5)*3 + termos | standard_k15_b075 | 0,2 / 0,8 |
| FiQA | 1 : 20 | 2000 / 500 | ABOUT(q)*2 + termos ponderados por idf | english_k15_b075 | 0,1 / 0,9 |
rare₁,rare₂ são os dois termos da query com menor frequência nos documentos. Os pesos dos termos são max(1, min(5, round(1 + ln((N+1)/(df+1))))). O peso final de cada dataset foi escolhido junto com a profundidade e a formulação, por isso pode diferir do melhor peso da seção 4.